AI 검색 답변은 사용자 위치에 따라 출처가 달라질까
질문 300개를 위치만 바꿔 ChatGPT·Gemini에 물어 답변 31,200개를 모았어요. ChatGPT는 앱이 알려준 도시를, Gemini는 네트워크가 있는 나라를 따라 출처와 추천 업체를 바꿨어요. arXiv 단편 논문 읽기
같은 질문이라도 어디서 묻느냐에 따라 AI 검색이 인용하는 출처와 추천하는 업체가 달라졌어요. ChatGPT는 앱이 알려준 도시를 따라 동네 질문 검색어의 100%에 그 도시 이름을 넣었고, Gemini는 알려준 위치는 무시하고 접속한 네트워크의 나라를 따랐어요 [1]. 이 연구는 캐나다 Toronto 대학 Mahe Chen과 Nick Koudas가 2026년 10월 arXiv에 올린 4쪽짜리 단편 논문이에요. 동료 심사를 거치기 전 단계이고, 측정 시점은 2026년 10월이에요 [1].
이 글은 arXiv 원문 v1의 본문과 표 1–4, 그림 1–3을 2026년 10월에 읽고 수치를 하나씩 대조해 정리했어요 [1]. 저자가 공개했다고 밝힌 질문·코드·답변은 직접 돌려 보지 않았어요. 저자와 이해관계는 없어요.
AI 검색 답변은 사용자 위치에 따라 달라지나요
GEO 모니터링은 보통 정해진 질문 묶음을 한 곳에서 보내 결과를 기록해요. 일반 검색에서는 로그인 다음으로 위치가 가장 큰 개인화 요인인데, 생성형 검색이 위치를 반영하는지는 측정된 적이 없었어요. 저자들은 이 빈자리를 실험으로 채웠어요 [1].
질문은 상업 분야 10개(가정 서비스·의료·금융·보험·통신·외식·소매·자동차·여행·공공 서비스)에서 300개를 직접 썼어요. "근처 배관공 추천"처럼 가까운 곳을 찾는 질문, "자동차 판매세는 얼마인가"처럼 지역마다 답이 다른 질문, "로봇청소기 추천"처럼 지역과 무관한 질문을 100개씩 나눴고, 어떤 질문에도 지명은 넣지 않았어요 [1].
실험은 두 갈래예요. 첫째는 ChatGPT(gpt-5.4-mini, Responses API 웹검색)에 미국 도시 15곳과 런던·토론토·시드니·더블린 4곳을 위치로 알려주거나 아무 위치도 안 알려주고 같은 질문을 두 번씩 물었어요(답변 24,000개). 둘째는 위치를 알려주지 않은 채 캐나다 연구실 회선과 뉴욕·로스앤젤레스·런던·시드니 VPN에서 ChatGPT와 Gemini(gemini-3.1-flash-lite, Google 검색 grounding)에 물었어요(답변 7,200개) [1].
비교 지표는 인용 도메인의 Jaccard 겹침이에요. 같은 조건에서 두 번 물은 "쌍둥이" 답변끼리의 겹침을 반복 잡음으로 보고, 위치를 바꾼 두 답변의 겹침이 그보다 얼마나 낮은지를 지역화 지수로 정의했어요.
$$
여기서 는 같은 질문·같은 위치 두 답변의 평균 겹침, 은 위치만 다른 두 답변의 평균 겹침이에요. 0이면 위치 효과가 반복 잡음보다 크지 않다는 뜻이에요 [1].
결과는 질문 종류에 따라 갈렸어요. ChatGPT에 미국 두 도시를 알려주면 동네 질문의 지역화 지수가 0.14, 지역 의존 질문이 0.17이었고, 나라가 다른 두 도시는 0.28과 0.43이었어요. 지역과 무관한 질문은 0.00과 0.03으로 위치 영향이 거의 없었어요 [1].
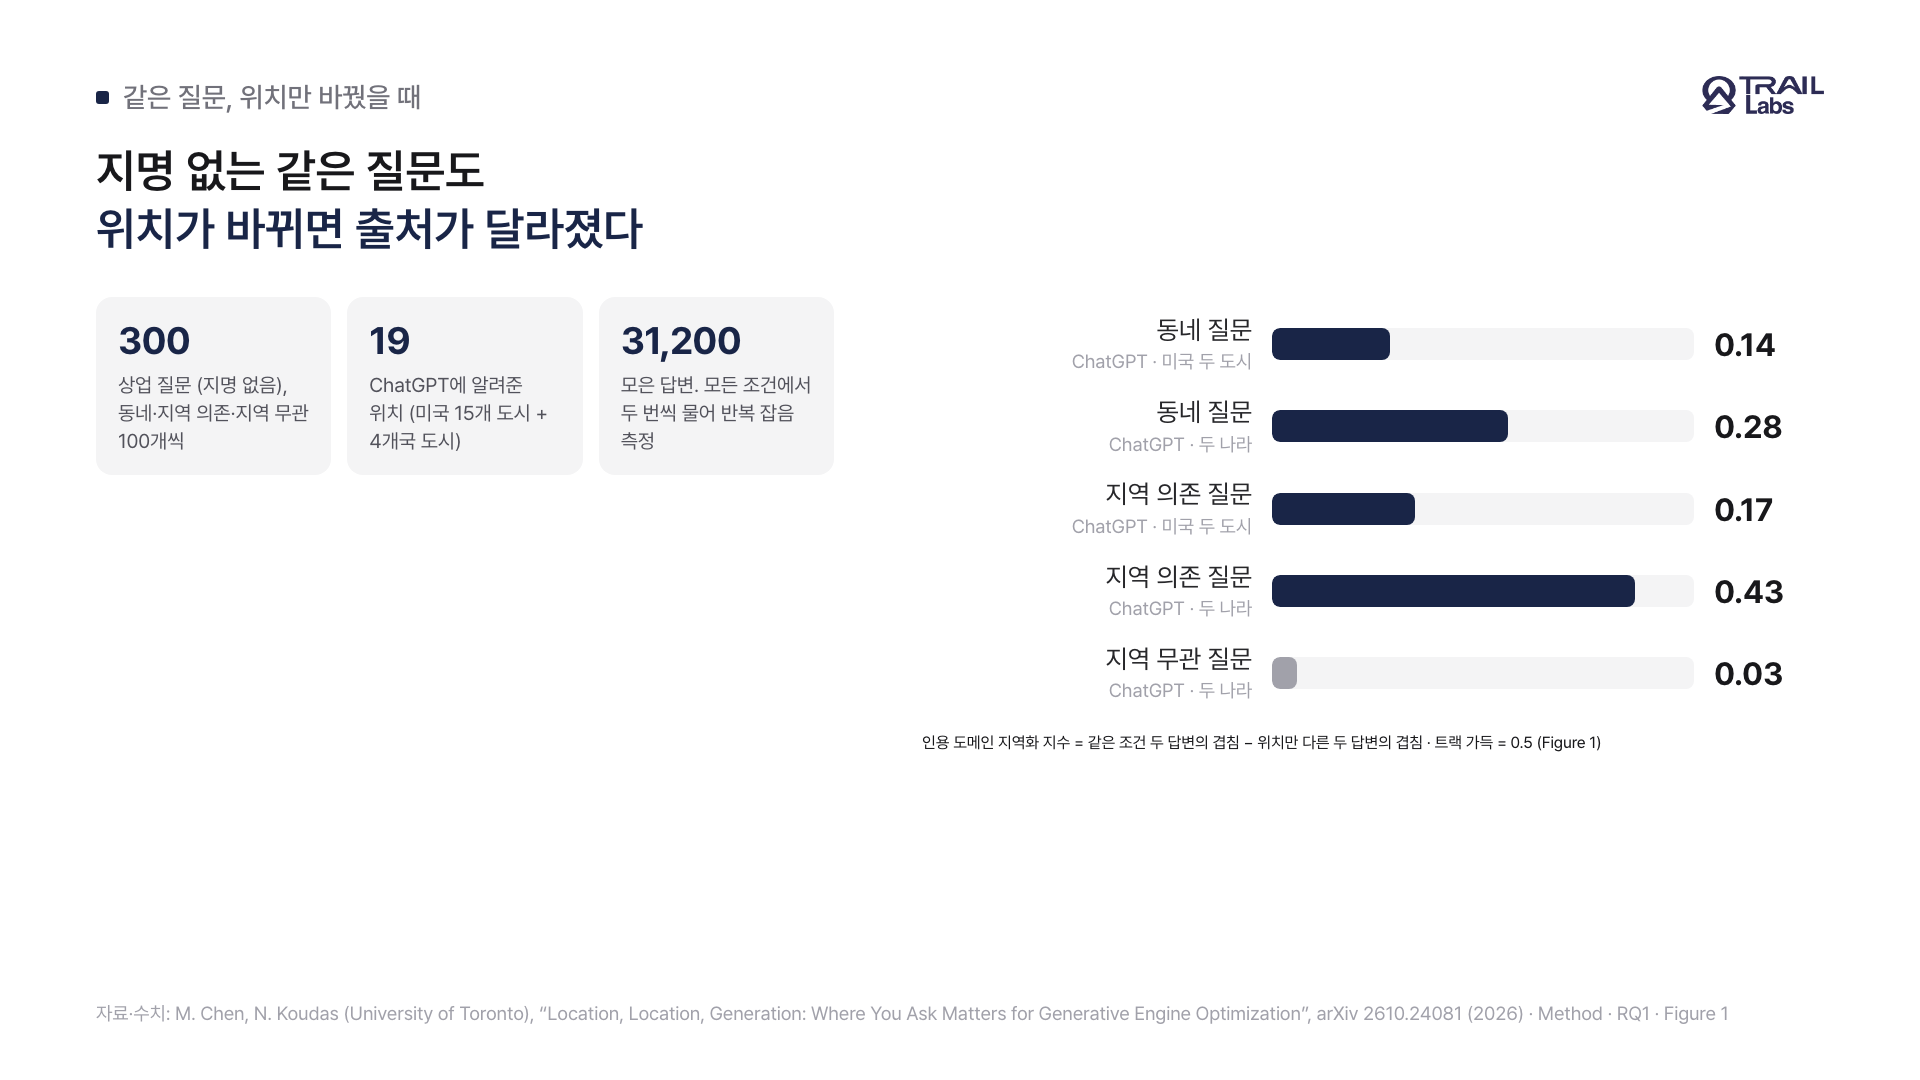
그림 1. 지명 없는 같은 질문도 ChatGPT에 알려준 위치에 따라 인용 출처가 달라졌어요. 동네 질문과 지역 의존 질문에서 차이가 컸어요 [1].
분야별로는 공공 서비스가 가장 강했어요(지역 의존 질문 0.57). 답변이 각 주 정부 사이트를 인용했기 때문이에요. 통신·공공요금은 연방통신위원회나 전국 통신사 같은 전국 출처를 인용해 0.02로 가장 약했어요. 분야마다 질문이 10개라 분야별 수치는 참고용이라고 저자들이 적었어요 [1].
ChatGPT와 Gemini는 사용자 위치를 어떻게 알아내나요
두 엔진은 위치를 받는 경로가 달랐어요. ChatGPT는 접속 네트워크를 무시했어요. 네트워크 국가가 다를 때 지역화 지수가 0.00, 0.01, 0.01로 전부 잡음 범위였어요. 대신 앱이 API로 알려준 위치를 도시 단위까지 따랐어요 [1].
Gemini는 반대였어요. API로 알려준 좌표는 사전 실험에서 효과가 없었고, 접속 네트워크의 나라를 따랐어요. 그런데 나라 단위까지만 따라서, 뉴욕과 로스앤젤레스 사이의 지수는 0.00(95% 신뢰구간 −0.03–0.04)이었어요. Gemini 검색어는 동네 질문의 56%에서 나라 이름을 넣었지만 도시 이름은 한 번도 넣지 않았어요 [1].
시간에 따른 변화로는 설명되지 않았어요. 같은 회선에서 사흘 간격으로 잰 차이는 0.03, 0.01, 0.05였고, 30분 간격으로 잰 런던과 시드니는 다른 나라 쌍만큼 달랐어요. Gemini는 지역과 무관한 질문에서도 나라가 바뀌면 출처가 0.23(신뢰구간 0.20–0.27)만큼 달라졌어요 [1].
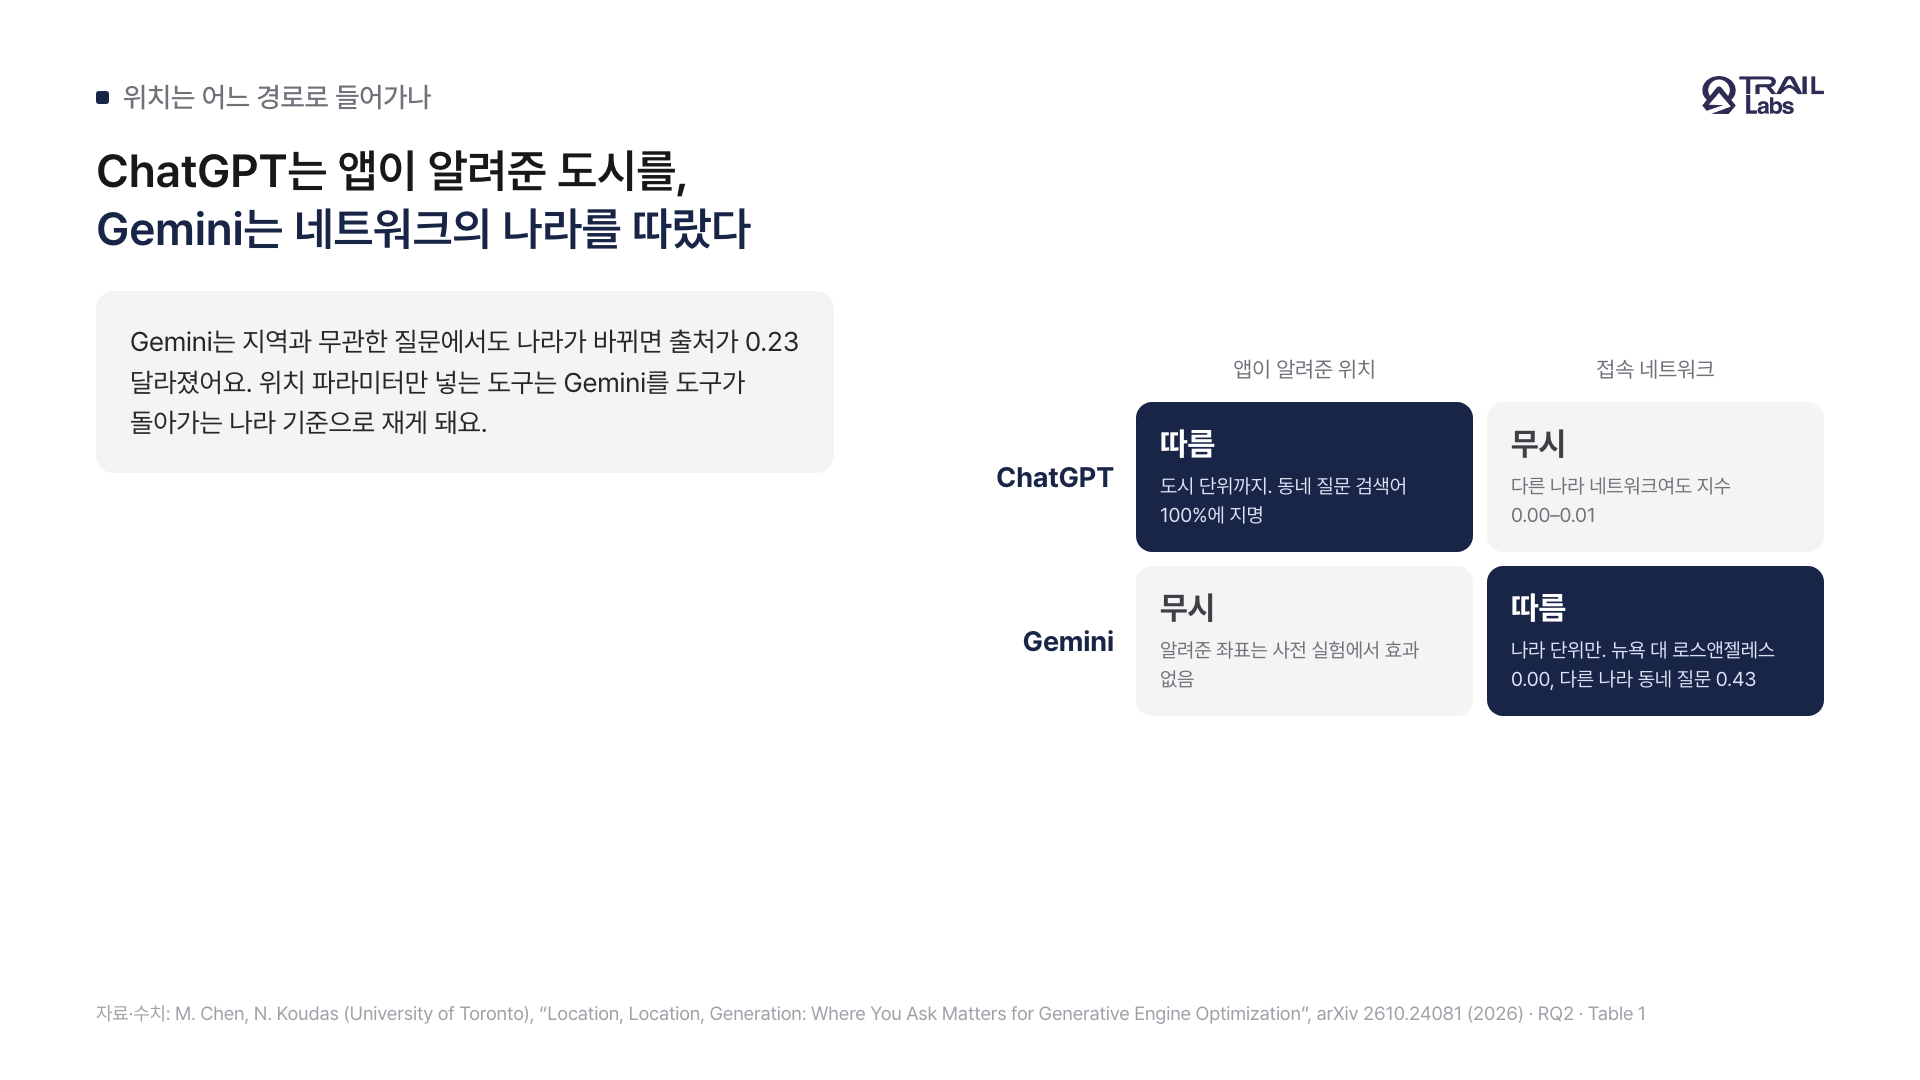
그림 2. ChatGPT는 앱이 알려준 위치를 도시 단위로, Gemini는 네트워크의 나라를 따랐어요. 한 엔진에서 효과가 있던 위치 신호가 다른 엔진에서는 효과가 없었어요 [1].
ChatGPT 안에서는 위치가 두 군데로 들어갔어요. 먼저 모델이 검색어에 지명을 직접 썼어요. 동네 질문은 검색어의 100%, 지역 의존 질문은 48%에 지명이 들어갔어요. 다음으로 검색 백엔드가 스스로 결과를 지역화했어요. 두 답변의 검색어 모두에 지명이 없을 때도 출처 차이가 0.17(신뢰구간 0.09–0.25)이었고, 둘 다 지명이 있으면 0.37로 올랐어요 [1].
거리는 상관이 없었어요. 동네 질문에서 1,000km 미만 도시 쌍의 지수는 0.13, 3,000km 넘는 쌍은 0.14였어요(거리와의 스피어만 상관 0.01). ChatGPT에게는 다른 도시가 모두 다른 곳이고, Gemini에게는 다른 나라만 다른 곳이었어요 [1].
위치를 알려주지 않으면 기본값도 달랐어요. ChatGPT는 동네 질문의 63%에서 우편번호나 도시를 되물었고(위치를 알려주면 4%), 검색하더라도 출처가 미국 도시들과 더 비슷했어요(겹침 0.25 대 다른 나라 0.10). 미국의 불특정 사용자에게 전국 출처로 답한 셈이에요. Gemini의 기본값은 어떤 위치를 알려주든 네트워크의 나라였어요 [1].
AI 검색 가시성은 어느 지역 기준으로 측정해야 하나요
출처가 바뀌면 추천 업체도 바뀌었어요. ChatGPT의 동네 질문 답변은 업체·브랜드·제품을 평균 4.3개 추천했는데, 같은 조건 두 답변이 공유한 이름은 23%, 위치가 다른 두 답변은 4%였어요. Gemini는 지역과 무관한 질문에서도 나라에 따라 추천 이름이 달랐어요(지수 0.07). 추천 이름은 언어모델로 뽑았고, 직접 확인한 36건 중 29건이 완전히 맞았어요 [1].
모니터링에 주는 숫자가 분명했어요. 동네 질문에서 한 도시의 답변은 다른 도시 답변이 추천한 업체의 8%만 추천했어요. 같은 도시에서 다시 물으면 32%였어요. 동네 질문 추천 업체의 96%는 15개 도시 중 한 곳에서만 나왔어요. 지역 의존 질문은 31%와 34%로 차이가 작았어요 [1].
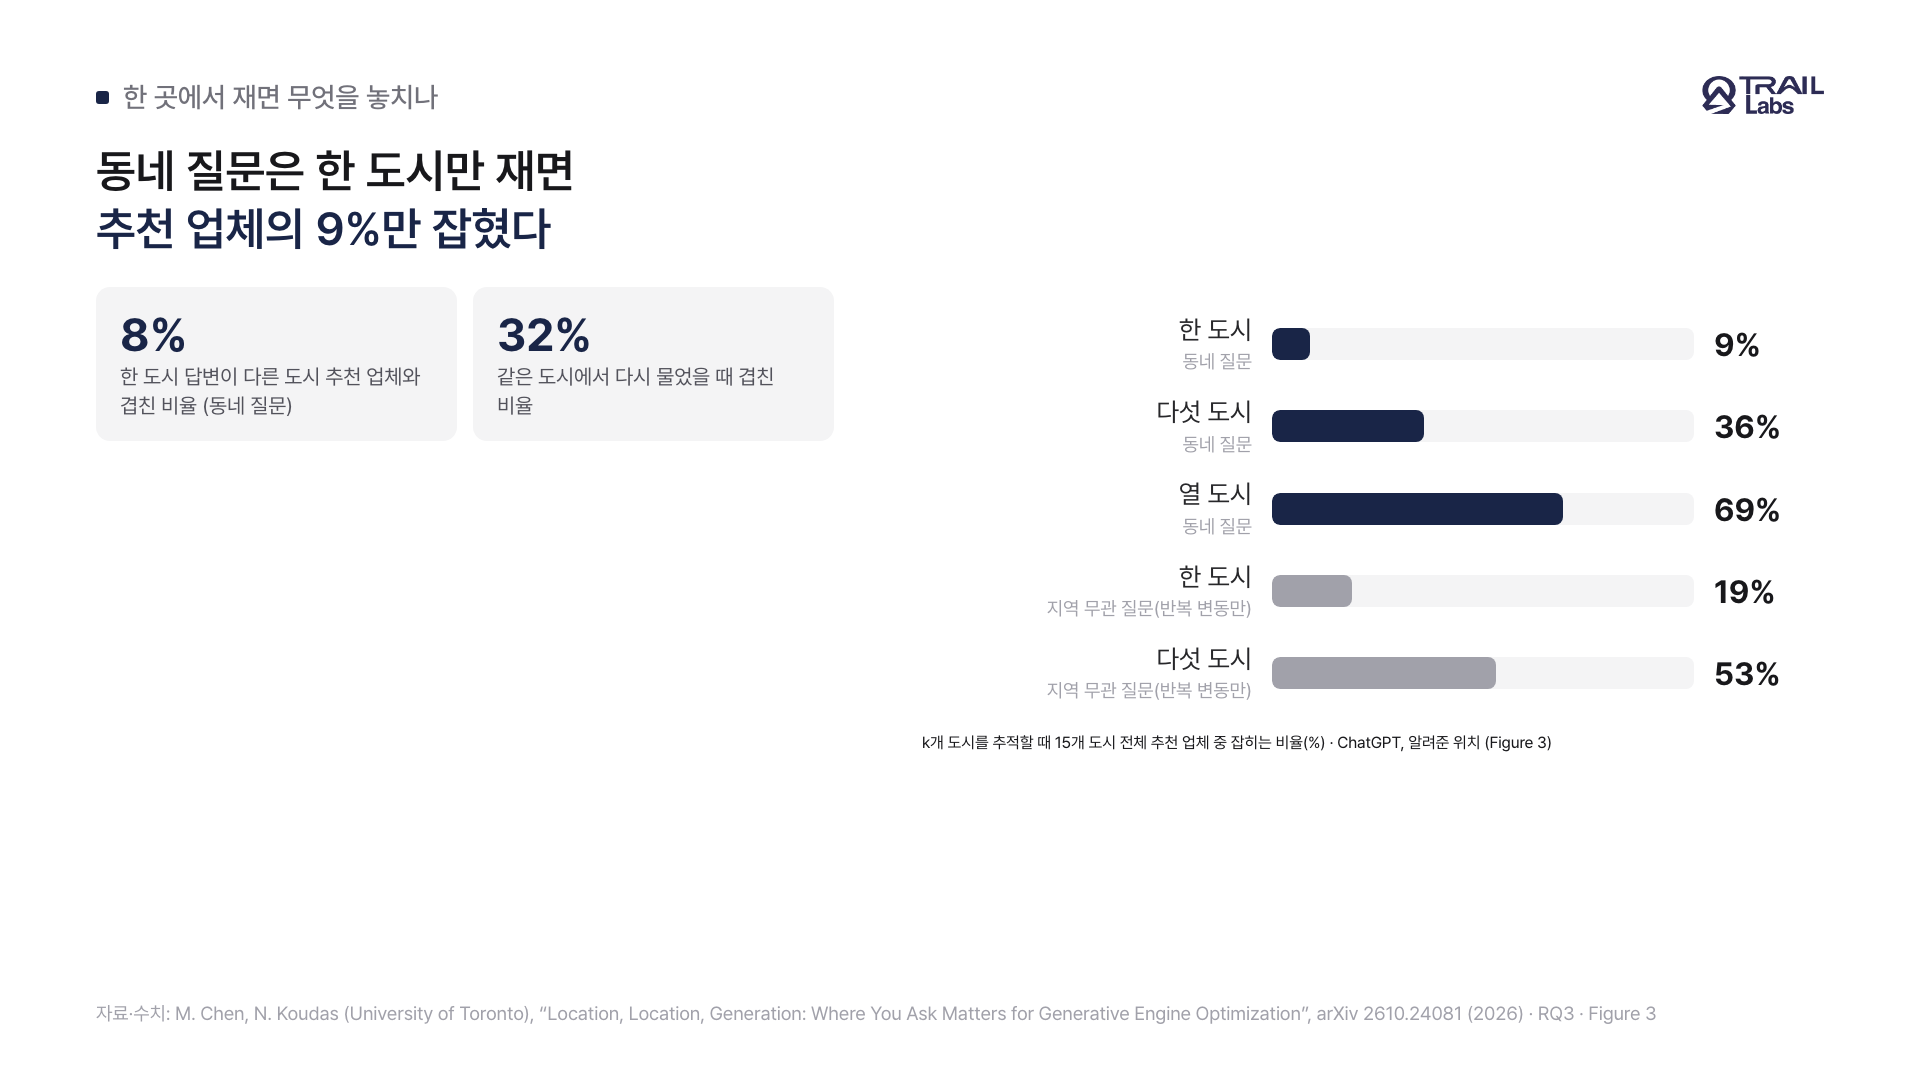
그림 3. 동네 질문에서 한 도시만 재면 15개 도시에서 추천된 업체의 일부만 잡혔고, 도시를 늘려도 곡선이 평평해지지 않았어요 [1].
추적 도시 수를 늘려도 금방 채워지지 않았어요. 동네 질문은 한 도시가 15개 도시 추천 업체의 9%, 다섯 도시가 36%, 열 도시가 69%를 잡았어요. 위치 영향이 없는 질문도 한 도시 19%, 다섯 도시 53%여서, 반복 사이의 변동만으로도 한 번 측정은 일부만 담았어요. 한 번 재는 측정의 한계는 AI 검색 가시성은 한 번 재면 못 믿어요에서 더 다뤘어요 [1].
저자들은 측정 도구에 세 가지를 요구했어요. 위치는 엔진이 읽는 경로에 맞춰 넣을 것(ChatGPT는 위치 파라미터, Gemini는 접속 네트워크), 엔진마다 단위가 다르니 ChatGPT는 시장 도시마다, Gemini는 나라마다 따로 잴 것, 시간이나 엔진을 비교할 때는 위치를 고정할 것. 위치 파라미터만 넣는 도구는 ChatGPT는 그 도시 기준으로, Gemini는 도구가 돌아가는 나라 기준으로 재게 돼요 [1].
지역 업체가 AI 검색 추천에 나오려면 무엇이 필요한가요
ChatGPT 답변은 지역 출처를 많이 인용했어요. 위치를 알려준 동네 질문에서 미국 도시 답변의 79%가 그 도시나 주 이름이 들어간 출처를, 다른 나라 도시 답변의 92%가 그 나라 도메인 출처를 인용했어요. 지역과 무관한 질문에서는 이 비율이 1%와 10%로 떨어졌어요 [1].
예시도 실렸어요. "우리 동네 신용협동조합"을 물으면 ChatGPT는 뉴욕·보이시·마이애미·런던에서 각각 그 지역 조합을 추천했어요. "어느 마트가 제일 싸나"를 물으면 Gemini는 캐나다·미국·영국·호주에서 각기 다른 전국 체인을 추천했고, 미국 동부와 서부에서는 같은 체인이 겹쳤어요 [1].
저자들의 해석은 이래요. ChatGPT는 지명을 넣어 검색하니, 지역 업체는 지역 디렉터리·리뷰 사이트·지역 기관 사이트처럼 지명으로 검색되는 페이지를 통해 보이게 된다는 거예요. Gemini에서는 사용자의 나라가 어떤 전국 체인과 출처가 뜰지를 정하니, 한 나라의 브랜드 가시성으로 다른 나라를 짐작할 수 없다고 봤어요. 검색에 걸리는 것과 인용되는 것의 차이는 AI 검색에서 수집과 인용은 어떻게 다른가에서 더 설명했어요 [1].
이 연구의 한계는 무엇인가요
저자가 밝힌 한계부터요. 공급사 API와 작은 모델로 쟀기 때문에 소비자 앱과 다르게 동작할 수 있고, 큰 모델 확인은 ChatGPT만 했어요(질문 60개·위치 6곳, 답변 720개에서 지역화가 작은 모델 이상으로 강했어요). VPN 출구가 데이터센터 주소라 가정용 회선에서는 Gemini가 더 세밀하게 지역화할 수도 있어요. 질문은 영어이고 저자가 직접 썼어요 [1].
4쪽 단편이라 분야별 표본이 작고, 신뢰구간 일부는 저장소에만 있어요. API 측정이 소비자 화면과 얼마나 다른지는 AI 챗봇의 제품 추천은 도구마다 다를까에서 다룬 감사와 같이 읽는 게 좋아요. 한국어 질문이나 국내 지역에서 같은 패턴이 나오는지는 별도 측정이 필요해요 [1].
TRAIL에게 주는 의미
TRAIL Search 코드를 이 논문 기준으로 대조해 봤어요. ChatGPT는 웹검색 도구에 위치를 나라 단위(한국 또는 미국)로만 넣고 도시는 넣지 않아요. 그래서 우리 ChatGPT 수치는 "그 나라의 불특정 도시 사용자" 기준이에요. Google AI 개요는 검색 API에 국가·언어 파라미터를 넣어 재요.
Gemini는 위치 값을 따로 보내지 않아요. 논문 결과대로라면 Gemini는 측정이 돌아가는 서버의 나라를 따르는데, 우리 측정 서버는 AWS 서울 리전에 있어요. 한국 시장 측정에는 맞는 조건이지만, 영어·미국 시장으로 잰 Gemini 결과도 한국 네트워크 기준일 수 있어요. 이건 논문 결과에서 나온 추정이라 직접 확인이 필요하고, 확인 전까지는 리포트에 Gemini 측정 위치를 같이 밝히는 게 맞아요.
반복 측정의 기본값이 한 회차라는 점도 이 논문과 맞물려요. 지역 업체나 지역 의존 질문을 추적하는 고객이라면 위치와 반복을 함께 늘려야 측정이 의미 있어요. 출처를 못 받은 응답을 "언급 없음"과 따로 두는 이유는 언급 없음과 측정 불가를 어떻게 구분하나에, API와 화면 중 무엇으로 잴지는 AI 가시성 측정, API와 실제 화면 중 무엇으로에 정리했어요.
Mahe Chen, Nick Koudas, "Location, Location, Generation: Where You Ask Matters for Generative Engine Optimization", arXiv 2610.24081 (2026).
Frequently asked questions
AI 검색 답변은 사용자 위치에 따라 달라지나요?
동네 업체를 찾는 질문과 지역마다 답이 다른 질문에서는 크게 달라졌어요. ChatGPT에 미국 두 도시를 위치로 알려주면 출처 차이(반복 잡음을 뺀 지역화 지수)가 동네 질문 0.14, 지역 의존 질문 0.17이었고, 나라가 다르면 0.28과 0.43으로 커졌어요. 지역과 무관한 질문은 0.00–0.03으로 차이가 거의 없었어요 [1].
ChatGPT와 Gemini는 사용자 위치를 어떻게 알아내나요?
두 엔진이 쓰는 경로가 달랐어요. ChatGPT는 앱이 API로 알려준 위치를 도시 단위까지 따르고 접속 네트워크 위치는 무시했어요(네트워크 국가가 달라도 지수 0.00–0.01). Gemini는 반대로 알려준 좌표를 무시하고 접속 네트워크의 나라를 따랐는데, 뉴욕과 로스앤젤레스처럼 같은 나라 안에서는 차이가 없었어요(0.00) [1].
AI 검색 가시성은 어느 지역 기준으로 측정해야 하나요?
엔진이 위치를 읽는 경로에 맞춰 고정해야 해요. ChatGPT는 위치 파라미터로 도시를, Gemini는 접속 네트워크로 나라를 정해야 하고, 둘 다 안 정하면 ChatGPT는 미국의 불특정 사용자, Gemini는 측정 서버가 있는 나라 기준으로 답해요. 동네 질문에서 한 도시의 추천 업체는 다른 도시 추천의 8%만 겹쳐서, 지역 업체 추적에는 여러 위치와 반복 측정이 함께 필요해요 [1].
지역 업체가 AI 검색 추천에 나오려면 무엇이 필요한가요?
ChatGPT는 동네 질문의 검색어 100%에 도시 이름을 넣어 검색했고, 미국 도시 답변의 79%가 그 도시나 주 이름이 들어간 출처를 인용했어요. 그래서 지역 업체는 전국 순위보다 지역 디렉터리·리뷰 사이트·지역 기관 사이트처럼 지명으로 검색되는 페이지에서 보여야 추천 후보가 된다고 저자들은 해석했어요 [1].
References
Summary
- 질문 300개를 위치만 바꿔 ChatGPT와 Gemini에 두 번씩 물어 답변 31,200개를 모았어요. 질문에는 지명이 하나도 없었어요.
- ChatGPT는 앱이 알려준 위치를 도시 단위까지 따르고 네트워크는 무시했어요. Gemini는 알려준 위치를 무시하고 네트워크의 나라를 따랐어요.
- Gemini는 지역과 무관한 질문에서도 나라가 바뀌면 출처가 크게 달라졌어요(지역화 지수 0.23).
- 추천 업체도 출처를 따라 바뀌어서, 동네 질문에서 다른 도시끼리 겹친 업체 이름은 4%였고 한 도시만 재면 15개 도시 추천 업체의 9%만 잡혔어요.
- 측정 도구는 엔진마다 위치가 들어가는 경로를 고정해야 하고, 지역 질문은 여러 위치와 반복 측정이 함께 필요해요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility