AI 가시성 리포트의 0%와 측정 불가, 어떻게 구분하나
리포트의 빈칸을 0으로 칠하는 순간, '없음'과 '모름'이 같은 값이 돼요
AI 가시성 리포트의 0과 측정 불가는 서로 다른 숫자예요. 0은 재 봤는데 브랜드가 없었다는 관측이고, 측정 불가는 그 칸의 값을 얻지 못했다는 공백이에요. 대부분의 대시보드는 두 칸을 똑같이 비워 두거나 똑같이 0으로 칠해요. 그 한 번의 뭉개기 때문에 숫자는 원래 쓰려던 결정에 쓸 수 없게 돼요. "이번 분기 이 질문군에서 0"이라는 보고를 받았을 때, 그게 콘텐츠를 만들어야 한다는 뜻인지 측정 경로부터 고쳐야 한다는 뜻인지 숫자만으로는 알 수 없거든요.
이 글의 근거 범위부터 밝혀 둘게요. 반복 측정에 관한 수치는 스위스 장크트갈렌대 연구진의 Don't Measure Once 논문 원문을 직접 대조해 옮겼고, 모두 논문 실험 기준이에요 [1]. 엔진이 답변이나 인용을 내지 않는 조건은 Google과 OpenAI의 공식 문서, Pew Research Center의 공개 자료에서 가져왔어요 [2][3][4]. 우리는 AI 검색 가시성을 재는 TRAIL Search를 운영하는 회사라는 이해관계가 있어요. 그래서 우리 측정 규칙을 예로 들되, 그 규칙이 노출이나 인용을 늘려 준다고는 말하지 않아요.
AI 답변 인용이 실제로 0일 때 원인을 나누는 순서는 AI 검색 인용수가 0일 때, 원인을 나눠 보는 진단 순서에서, 엔진별로 쪼개 보는 이유는 AI 가시성을 점수 하나로 보면 위험한 이유에서 다뤘어요. 이 글은 그 앞 단계, 즉 그 0이 정말 잰 0인지를 가리는 일에 집중해요.
0%와 측정 불가는 서로 다른 관측이에요
가시성 0은 측정이 성공한 결과예요. 엔진이 답변을 냈고, 그 답변을 수집했고, 브랜드 언급이나 인용을 찾아봤는데 없었다는 뜻이에요. 반대로 측정 불가는 측정이 성립하지 않은 칸이에요. 답변이 없었거나, 답변은 있었지만 판정에 필요한 정보(인용 목록 같은)가 없었거나, 수집 자체가 실패한 경우예요.
이 차이가 중요한 이유는 다음 행동이 정반대이기 때문이에요. 0은 "이 엔진은 이 질문에 우리 대신 다른 출처를 골랐다"는 증거라서 콘텐츠·출처 처방의 출발점이 돼요. 측정 불가는 "아직 아무것도 모른다"는 상태라서 측정 조건을 먼저 바꿔야 해요. 측정 불가 칸에 콘텐츠를 더 써 넣어도, 다음 회차에 그 칸이 또 비어 있으면 효과를 확인할 길이 없어요.
| 칸의 상태 | 실제로 일어난 일 | 리포트 표기 | 다음 행동 |
|---|---|---|---|
| 관측됨, 언급 있음 | 답변을 수집했고 브랜드가 나왔어요 | 값(%) | 엔진별 유지·확장 |
| 관측됨, 언급 없음 | 답변을 수집했고 브랜드가 없었어요 | 0% | 인용된 경쟁 출처를 보고 처방 |
| 측정 불가 | 답변·인용이 없었거나 수집이 실패했어요 | 측정 불가(빈 값과 다른 표시) | 측정 경로·조건부터 점검 |
표 1. AI 가시성 리포트의 칸이 가질 수 있는 세 가지 상태와 각각의 다음 행동이에요.
AI 답변 인용이 0이어도 측정 불가인 경우가 많아요
측정 불가 칸은 예외적인 고장보다 AI 검색의 정상 동작에서 더 자주 생겨요. 세 가지 경로가 대표적이에요.
첫째, AI 답변 자체가 생성되지 않는 경우예요. Google Search Central 문서는 AI Overviews가 기존 검색에 보탬이 된다고 시스템이 판단할 때만 표시되며, 그래서 자주 뜨지 않는다고 적고 있어요 [2]. 실제 사용 데이터로도 확인돼요. Pew Research Center가 미국 성인 900명의 2025년 3월 브라우징 기록에서 68,879건의 고유 구글 검색을 분석했을 때, AI 요약이 나온 검색은 12,593건으로 약 18%였어요 [3]. AI 요약이 뜨지 않은 검색에서 "우리 브랜드의 AI Overview 가시성"은 0%가 아닌 미정이에요.
둘째, 모델이 웹 검색을 하지 않아 인용 목록이 비는 경우예요. OpenAI의 웹 검색 도구 문서는 다른 도구와 마찬가지로 모델이 입력 프롬프트의 내용에 따라 웹을 검색할지 말지 스스로 고른다고 설명해요. 기본 설정(tool_choice: "auto")에서는 검색이 선택 사항이에요 [4]. 검색을 하지 않은 답변에는 인용 URL이 없으니, 그 답변으로 "우리 페이지가 인용됐는가"를 판정할 수는 없어요.
셋째, 수집이 실패하거나 데이터 품질 때문에 제외되는 경우예요. 이건 측정하는 쪽의 사정이지만 리포트에서는 앞의 두 경우와 똑같이 빈칸으로 남아요.
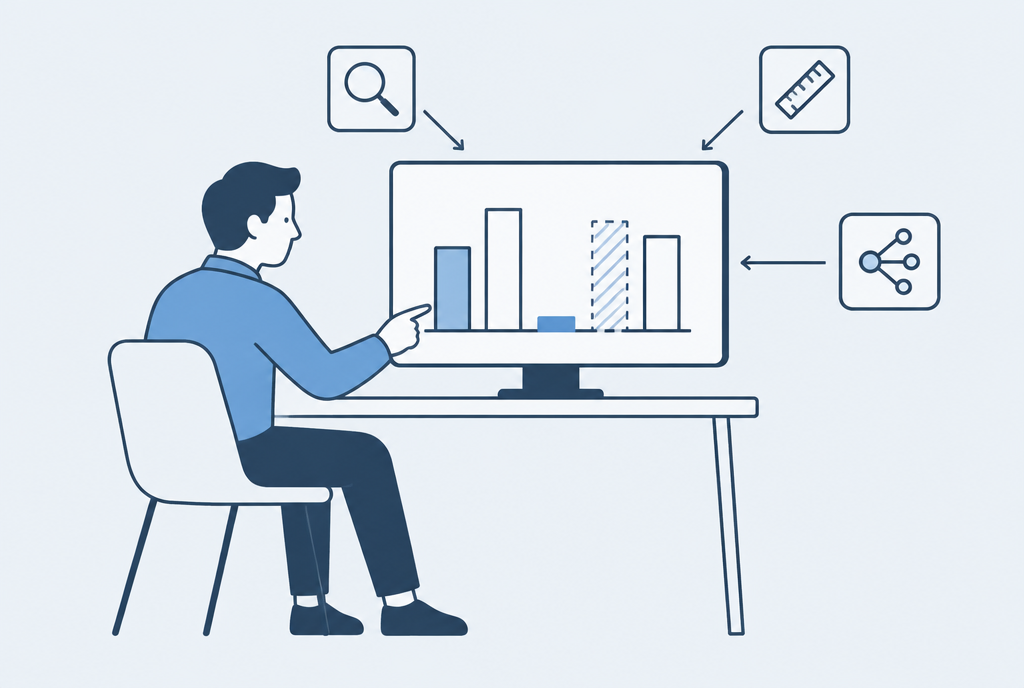
그림 1. 모니터 속 막대 차트에 높이가 아주 낮은 채운 막대와 테두리만 점선으로 그린 빗금 막대가 나란히 있어요. 앞의 것은 잰 값이 작은 칸을, 뒤의 것은 값을 채우지 못한 칸을 그린 삽화예요.
반복 측정 논문도 0과 미측정을 따로 다뤘어요
Don't Measure Once 연구진은 이 구분을 실제 분석 단계에서 직접 적용했어요. 연구는 스위스 독일어권 4개 업종(통신, 부동산 매매, 스포츠용품, 가전)에서 업종당 8개 질문을 ChatGPT, Gemini, Google AI Mode, Perplexity 4개 엔진에 2026년 1월 24일부터 3월 20일까지 매일 넣어 수집했어요 [1].
같은 날 반복 실행한 결과를 비교할 때, 연구진은 인용이 하나 이상 추출된 실행만 남겼어요. 인용이 0개인 응답을 그대로 두면 "둘 다 비어 있어서 같다"는 식의 거짓 일치가 Jaccard 값을 부풀리기 때문이에요. 이 필터를 통과한 실행은 전체의 75.4%였고, ChatGPT는 42.2%로 가장 낮았어요. 논문은 이를 ChatGPT가 정의형 질문에서 웹 검색을 생략하는 경향 때문이라고 설명해요 [1]. 다시 말해 ChatGPT 실행의 절반 넘게가 인용 단위 판정에서는 측정 불가였어요.
일별 수집에도 빈칸이 있었어요. 45–46일 수집 기간 동안 ChatGPT·Google AI Mode·Perplexity는 업종별로 38–44일치 결과가 있었지만, Gemini는 22–26일치에 그쳤어요. 인용량이 평소의 약 2배로 튄 1월 30일 하루는 분석에서 통째로 뺐고요 [1]. 이 빈칸들을 0으로 채웠다면 Gemini는 실제보다 훨씬 덜 보이는 엔진으로 기록됐을 거예요.
AI 검색 점유율(SoV) 계산: 브랜드명이 들어간 프롬프트는 분모에서 빼요
AI 검색 점유율(SoV)은 브랜드명이 들어간 프롬프트를 뺀 질문 집합 위에서 계산해요. 0과 미측정을 가르는 일은 분모를 정직하게 잡는 일과 같은 문제예요. 우리가 점수 체계를 만들기 전에 정한 첫 규칙은 자기 브랜드를 묻는 질문을 분모에서 빼는 것이에요. AI에 "우리 브랜드 어때?"라고 묻고 그 답에 브랜드가 나왔다고 세는 건 측정이 아니에요. 식으로 쓰면 이래요.
는 전체 질문 세트, 는 브랜드명이 든 질문을 빼고 오염 플래그를 단 나머지예요. 는 엔진 집합이고, 엔진별 값은 따로 보여 준 다음에 합쳐요. 는 엔진 가 질문 에 답하면서 이름을 댄 브랜드 집합이에요.
이 식에서 분모 는 질문과 엔진의 조합 수예요. 여기에 측정 불가 칸이 0으로 섞여 들어가면 분자는 그대로인데 분모만 커져서 점유율이 내려가요. 브랜드가 실제로 덜 보인 게 아닌데도 숫자는 하락으로 읽혀요. 반대로 브랜드명이 든 질문이 섞이면 분자가 거의 자동으로 채워져서 점유율이 부풀어요. 두 오류 모두 분모를 무엇으로 잡느냐의 문제예요.
재지 못한 항목은 0점 대신 분모에서 빼요
같은 원칙을 페이지 진단 점수에도 적용해요. 두 번째 규칙은 측정하지 못한 항목을 0점으로 매기지 않고 분모에서 빼는 것이에요.
는 실제로 관측한 채점 항목만 모은 집합이고, 는 항목 가중치, 는 그 항목에서 얻은 점수 비율이에요. 우리 100점 룰브릭은 접근 4, 검색(어휘 겹침) 13, 어휘 보존 5, 재랭킹 12(청크 위치 8과 최고 청크 4), 인용 수사 6, 의도 일치 4, 완전성 4, 구조 20, 권위 32로 나뉘어요. 페이지에 타깃 질문이 정해져 있지 않으면 검색과 의도 일치 항목은 잴 수가 없어요. 비교 맥락이 없는 페이지라면 가격·스펙을 보는 완전성 항목도 잴 대상이 아니고요.
계산 예시로 보면 차이가 분명해요. 타깃 질문이 없고 비교 페이지도 아닌 가상의 페이지가 있다고 해 볼게요. 빠지는 항목이 검색 13, 의도 일치 4, 완전성 4라서 관측 가능한 만점은 79점이에요. 이 페이지가 79점 중 60점을 얻었다면 위 식으로는 60/79, 100점으로 환산해 약 76점이에요(우리 계산). 미측정 항목을 0점으로 넣으면 같은 페이지가 60점으로 기록돼요. 16점의 차이는 페이지 품질과 무관하게 측정 범위에서 나온 거예요. 팀이 그 16점을 메우려고 손을 대기 시작하면 고칠 필요가 없는 곳에 시간을 쓰게 돼요.
AI 검색 가시성은 몇 번 반복 측정해야 믿을 수 있나
논문 실험 기준으로 브랜드별 검출률은 7회 이상 반복 측정해야 표준오차가 0.10 아래로 내려가요 [1]. 한 번 잰 0은 아직 0이 아니에요. 세 번째 규칙은 런 수를 먼저 보여 주는 것이에요. 같은 질문을 같은 날 다시 물어도 인용 출처는 꽤 바뀌어요. Don't Measure Once 논문에서 24시간 안에 반복 실행한 결과끼리의 인용 출처 Jaccard 유사도는 업종별 평균 0.32–0.43이었고, 날짜를 바꿔 비교한 일간 값 0.34–0.42와 같은 범위였어요 [1]. 하루 안의 변동만으로 관측된 불안정성 대부분이 설명된다는 뜻이에요. 일간 기준으로는 인용 출처의 약 65%가 하루 만에 바뀌었어요 [1].
이 변동은 표본을 늘리면 줄어들어요. 반복 횟수 에 대한 표준오차는 익숙한 식을 따라요.
| 반복 횟수(n) | 표준오차(SE) | 95% 신뢰구간 반폭(±) |
|---|---|---|
| 1 | 0.370 | 0.724 |
| 2 | 0.246 | 0.483 |
| 3 | 0.188 | 0.369 |
| 5 | 0.123 | 0.241 |
| 7 | 0.081 | 0.158 |
| 8 | 0.062 | 0.121 |
표 2. 브랜드별 검출률 추정의 반복 횟수별 표준오차(1,216개 브랜드 시계열 평균, 논문 실험 기준)예요 [1].
논문은 1회 측정을 사실상 정보가 없다고 평가해요. 실제 검출률이 50%인 브랜드가 1회 측정에서는 명목상 95% 구간으로 −22%에서 +122% 사이 어디에든 나올 수 있기 때문이에요. 7회가 되면 표준오차가 0.081로 0.10 아래로 내려가고, 인용 출처 단위의 커버리지는 8회가 필요했어요. 브랜드별 추정에는 2–4주 롤링 집계를 권했고요 [1].
그래서 우리는 값을 보여 주기 전에 런 수로 칸에 라벨을 붙여요. 3회 미만은 예비 추정, 3–6회는 중간 신뢰, 7회 이상은 고신뢰예요. 한 번 재서 0이 나온 칸과 일곱 번 재서 일곱 번 모두 0이 나온 칸은 같은 0이 아니에요. 논문도 항상 인용되거나 한 번도 인용되지 않는 브랜드는 더 적은 반복으로 충분하다고 적었어요 [1]. 반복해서 확인한 0은 단단한 근거가 되고, 한 번 본 0은 예비 관측일 뿐이에요.
근거 등급이 가중치의 상한을 정해요
네 번째 규칙은 점수 자체의 정직성에 관한 거예요. 채점 항목 하나하나를 공개 연구와 그 근거 등급에 묶어 두고, 등급이 그 항목이 총점을 움직일 수 있는 폭의 상한을 정해요.
는 항목 의 근거 등급이에요. 다른 분야에서 유추한 근거(analogy)만 있는 항목은 100점 중 5점, 약한 근거(weak)만 있는 항목은 10점을 넘을 수 없어요. 뒷받침하는 연구가 없는 채점 항목은 아예 만들 수 없게 해 뒀어요. 페이지를 256토큰 단위, 64토큰 겹침으로 잘라 보는 청크 시뮬레이션의 위치 가중치도 앞쪽일수록 큰 단조 감쇠로 두었어요. 결론부에 보너스를 주는 안을 시험했지만 넣지 않았어요.
이 규칙은 0과 미측정 구분과 같은 뿌리에서 나와요. 모르는 것을 아는 것처럼 점수에 넣지 않는다는 원칙이에요. 근거가 약한 항목에 큰 가중치를 주면, 그 항목에서 받은 0점이 실제보다 큰 문제처럼 보여요.
리포트를 받았을 때 먼저 확인할 것
AI 가시성 리포트를 받으면 숫자를 읽기 전에 다섯 가지를 확인하면 돼요.
- 0과 측정 불가가 다르게 그려졌는지 봐요. 같은 색, 같은 빈칸이라면 그 리포트는 없음과 모름을 구분하지 않아요.
- 분모에 브랜드 질문이 섞였는지 봐요. 브랜드명이 든 질문이 점유율 계산에 들어갔다면 그 숫자는 발견 가능성을 재지 않아요.
- 칸마다 몇 회 측정인지 봐요. 런 수가 없으면 지난달 대비 변화가 실제 변화인지 모델 확률성인지 가릴 수 없어요.
- 프롬프트 세트가 바뀌었는지 봐요. 질문 구성이 달라진 구간의 상승은 개선이 아닌 구성 변화예요. 우리는 프롬프트 세트에 지문(fingerprint)을 붙여 두 경우를 나눠요.
- 엔진을 합치기 전에 엔진별 값을 봐요. 한 엔진의 측정 불가가 전체 평균에 0으로 섞이면 다른 엔진의 성과까지 가려져요. 엔진을 나눠 읽는 법은 AI 가시성을 점수 하나로 보면 위험한 이유에서 자세히 다뤘어요.
다섯 가지를 통과한 0만 진단 대상이에요. 그 0의 원인을 검색 노출, 크롤링, 콘텐츠 구조로 나눠 보는 순서는 AI 검색 인용수가 0일 때, 원인을 나눠 보는 진단 순서를 이어서 보면 돼요. 측정 불안정성이 GEO 연구 전반의 문제라는 점은 GEO 논문 45편 서베이에서도 확인할 수 있어요.
한계
이 글의 수치에는 분명한 경계가 있어요. Don't Measure Once의 결과는 스위스 독일어권 4개 업종, 업종당 8개 질문, 4개 엔진, 2026년 1–3월이라는 조건에서 나왔어요 [1]. 한국어 질문이나 국내 검색 표면에서 같은 변동 폭이 나올지는 이 논문이 답하지 않아요. 연구진도 다른 언어와 지역 시장에서 같은 불안정성 패턴이 유지되는지를 후속 과제로 남겼어요. 표준오차 기준도 브랜드별 검출률에 대한 값이고, 중간 정도의 검출 확률을 가정해요.
Pew Research Center의 18%는 2025년 3월 미국 사용자의 구글 검색 기준이에요 [3]. AI 요약이 뜨는 비율은 질문 유형과 시기에 따라 달라지고, 이 글은 한국 검색에서 그 비율을 재지 않았어요.
우리 측정 규칙 네 가지는 숫자를 정직하게 읽기 위한 설계 선택이에요. 이 규칙이 노출, 인용, 순위를 늘려 주지는 않아요. 그건 우리가 통제하지 못하는 모델의 출력이에요. 우리가 보고하는 건 무엇이 관측됐는지, 무엇을 관측하지 못했는지, 지난 회차 이후 무엇이 움직였는지예요.
Frequently asked questions
AI 가시성 리포트에서 0%와 측정 불가 표시는 어떻게 읽어야 하나요?
0%는 그 엔진과 질문 조합을 실제로 재서 우리 브랜드가 한 번도 나오지 않았다는 관측이에요. 측정 불가는 답변이 생성되지 않았거나 검색·인용이 일어나지 않았거나 수집이 실패해서 값을 얻지 못한 칸이에요. 0%는 콘텐츠 처방의 근거가 되고, 측정 불가는 측정 경로를 먼저 고쳐야 한다는 신호예요.
AI 검색 가시성은 몇 번 반복해서 재야 하나요?
Don't Measure Once 논문 실험 기준으로 브랜드별 검출률의 표준오차는 1회 0.370, 2회 0.246이었고 7회에서 0.081로 0.10 아래로 내려갔어요. 인용 출처 단위는 8회가 필요했고, 브랜드별 추정은 2–4주 롤링 집계를 권했어요. 그래서 우리는 런 수에 따라 예비 추정·중간 신뢰·고신뢰로 표시해요.
브랜드 이름이 들어간 질문을 점유율 계산에 넣으면 왜 안 되나요?
'우리 브랜드 어때?'라고 물으면 답변은 거의 항상 그 브랜드를 언급해요. 이런 질문이 분모에 섞이면 점유율이 실제 발견 가능성과 무관하게 올라가요. 그래서 브랜드명이 든 질문은 분모에서 빼고 오염 플래그를 달아 따로 보여줘요.
측정하지 못한 항목을 0점 처리하면 무엇이 문제인가요?
재지 못한 이유가 페이지의 약점처럼 보이게 돼요. 예를 들어 타깃 질문이 정해지지 않은 페이지의 검색·의도 항목을 0점으로 넣으면 점수가 떨어지고, 팀은 고칠 필요가 없는 곳을 고치게 돼요. 미측정 항목은 분모에서 빼는 편이 판단을 덜 왜곡해요.
References
- [1]Schulte, Bleeker & Kaufmann, "Don't Measure Once: Measuring Visibility in AI Search (GEO)", arXiv:2604.07585 (2026)
- [2]Google Search Central, "AI features and your website"
- [3]Pew Research Center, "Google users are less likely to click on links when an AI summary appears in the results" (2025)
- [4]OpenAI API 문서, "Web search"
Summary
- 0%는 재서 없었다는 관측이고, 측정 불가는 값을 얻지 못한 공백이에요. 리포트가 둘을 같은 0으로 그리면 '없음'과 '모름'이 구분되지 않아요.
- 측정 불가는 AI 답변이 아예 생성되지 않을 때, 모델이 웹 검색을 하지 않아 인용이 없을 때, 수집이 실패할 때 생겨요.
- 점유율 분모에서 브랜드명이 든 질문을 빼고, 재지 못한 채점 항목은 0점 대신 분모에서 빼요.
- Don't Measure Once 논문 실험 기준으로 같은 날 재실행한 인용 출처 Jaccard는 0.32–0.43이었고, 브랜드 검출률 표준오차는 7회에서 0.10 아래로 내려갔어요.
- 리포트를 받으면 0과 측정 불가가 다르게 그려졌는지, 몇 회 측정인지, 프롬프트 세트가 바뀌었는지부터 확인해요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility