AI 검색 가시성은 한 번 재면 못 믿어요, 몇 번·며칠을 재야 할까
같은 질문인데 인용이 하루 새 60% 넘게 바뀌는 이유와, 믿을 만한 측정에 필요한 반복 횟수를 실측한 연구 읽기
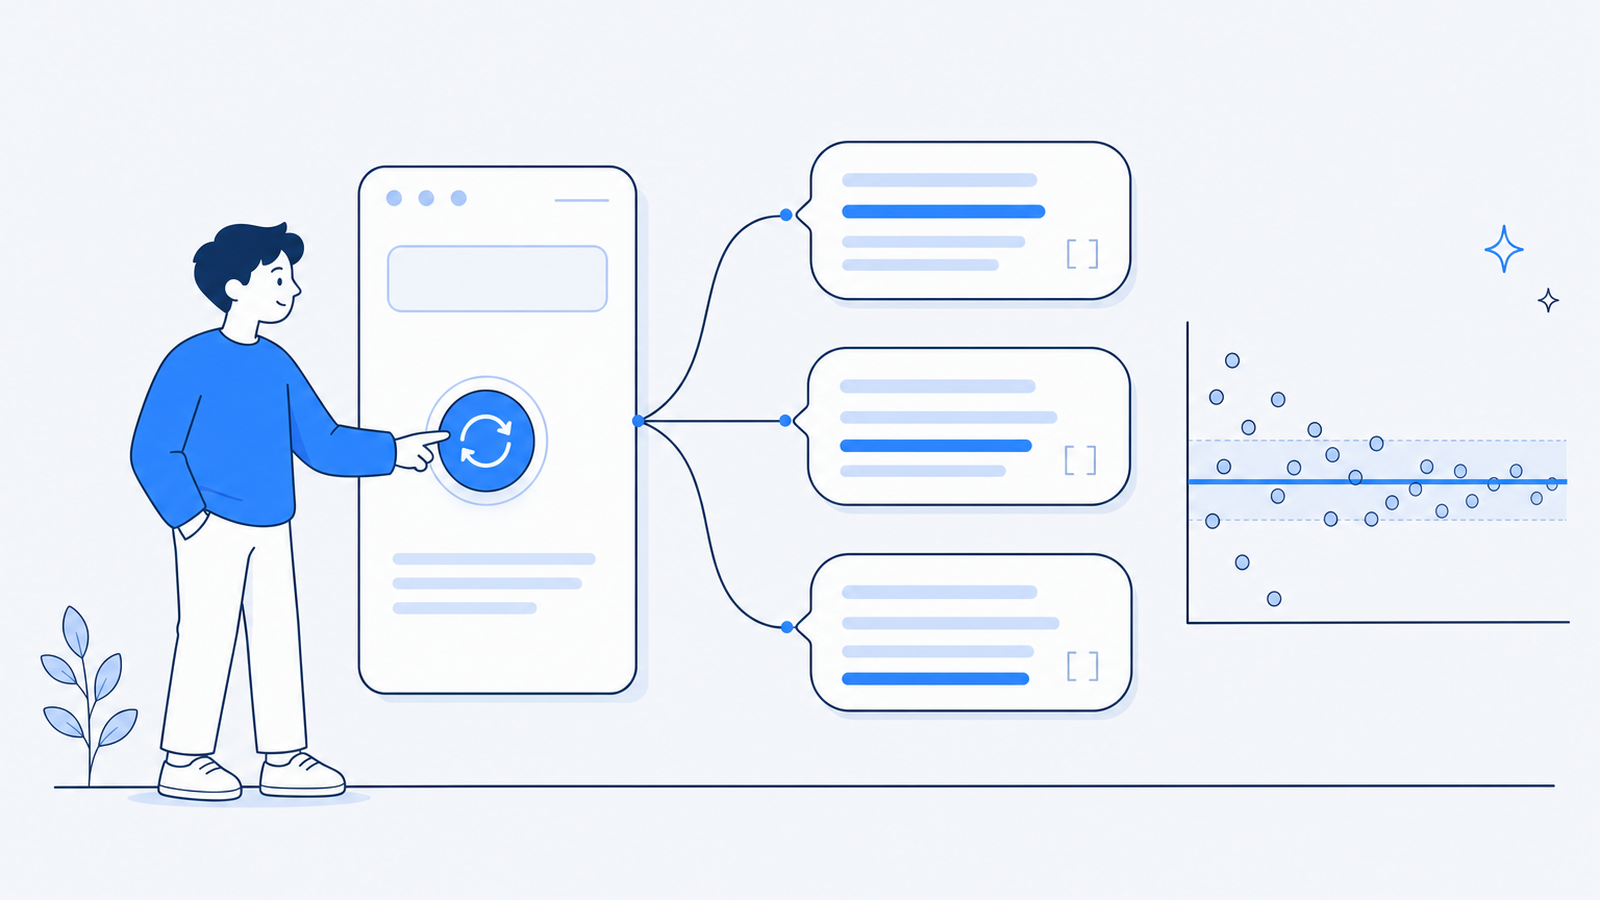
AI 검색 가시성은 한 번 재면 믿기 어려워요. 같은 질문인데 인용되는 소스가 하루 새 약 65%가 바뀌고, 이 흔들림의 상당 부분은 알고리즘 변화보다 모델이 매번 다르게 생성하는 데서 와요. St. Gallen 연구진이 4개 AI 검색엔진을 45일 추적한 결과, 인용 소스는 이틀 연속 평균 34-42%만 겹쳤어요(Jaccard) [1]. 그래서 측정을 믿으려면 한 번으로는 부족하고 여러 번 반복해야 하는데, 이 연구는 그 횟수와 기간을 수치로 제시해요 [1].
이 글은 arXiv에 공개된 논문 원문의 본문과 표를 읽고 수치를 대조해 정리했어요. 수치는 모두 논문 실험 기준이고, 저장소에 라이선스가 없어 우리는 재현하지 않았어요 [1]. 저자 한 명이 GEO 모니터링 벤더를 겸하고 우리도 반복 추적을 파는 입장이라, 이 결론은 이해관계를 감안해 읽었어요.
왜 AI 검색 가시성은 매번 달라질까요?
전통 검색은 순위가 흔들려도 결과 집합에는 대개 남아 있어요. 반면 생성형 검색은 포함 아니면 배제로 움직여요 [1]. 한 응답에 등장했다가 다음 응답에는 완전히 사라지곤 해요 [1]. 저자들은 그 원인을 두 가지로 봐요. 토큰을 확률적으로 생성하는 특성과, RAG가 여러 소스를 제한된 답변 공간으로 압축하며 근거를 고르는 과정이에요 [2].
연구진은 이 변동을 두 데이터셋으로 측정했어요 [1]. 하나는 4개 캠페인(통신·부동산·스포츠용품·가전) × 프롬프트 8개 × 4개 엔진을 매일 1회씩 45일간 모은 시계열이고, 다른 하나는 같은 날 최대 10번 연속 실행한 데이터예요 [1]. 겹침은 집합 유사도인 Jaccard로 쟀어요. 1에 가까울수록 두 번의 인용 목록이 똑같다는 뜻이에요 [1]. 참고로 Gemini는 수집 결측이 많았고, ChatGPT는 인용이 없는 응답이 많아 소스 분석에서 제외했어요 [1].
하루 새 인용은 얼마나 바뀌나요?
인용된 소스는 이틀 연속으로 평균 34-42%만 겹쳤어요(Jaccard, 캠페인별 0.336-0.423) [1]. 겹치지 않은 비율로 보면 하루 새 약 65%가 바뀐 셈이에요 [1]. 브랜드 언급은 소스보다 안정적이어서 45-59%가 겹쳤는데, 이 값은 검출률이 70% 이상인 3개 캠페인에서 잰 값이에요 [1].
저자들은 이 변동을 꾸준히 나타나는 특성으로 읽어요 [1]. 그래서 한 시점의 조회 결과를 그대로 "우리 브랜드 가시성"이라고 부르기 어려워요 [1].
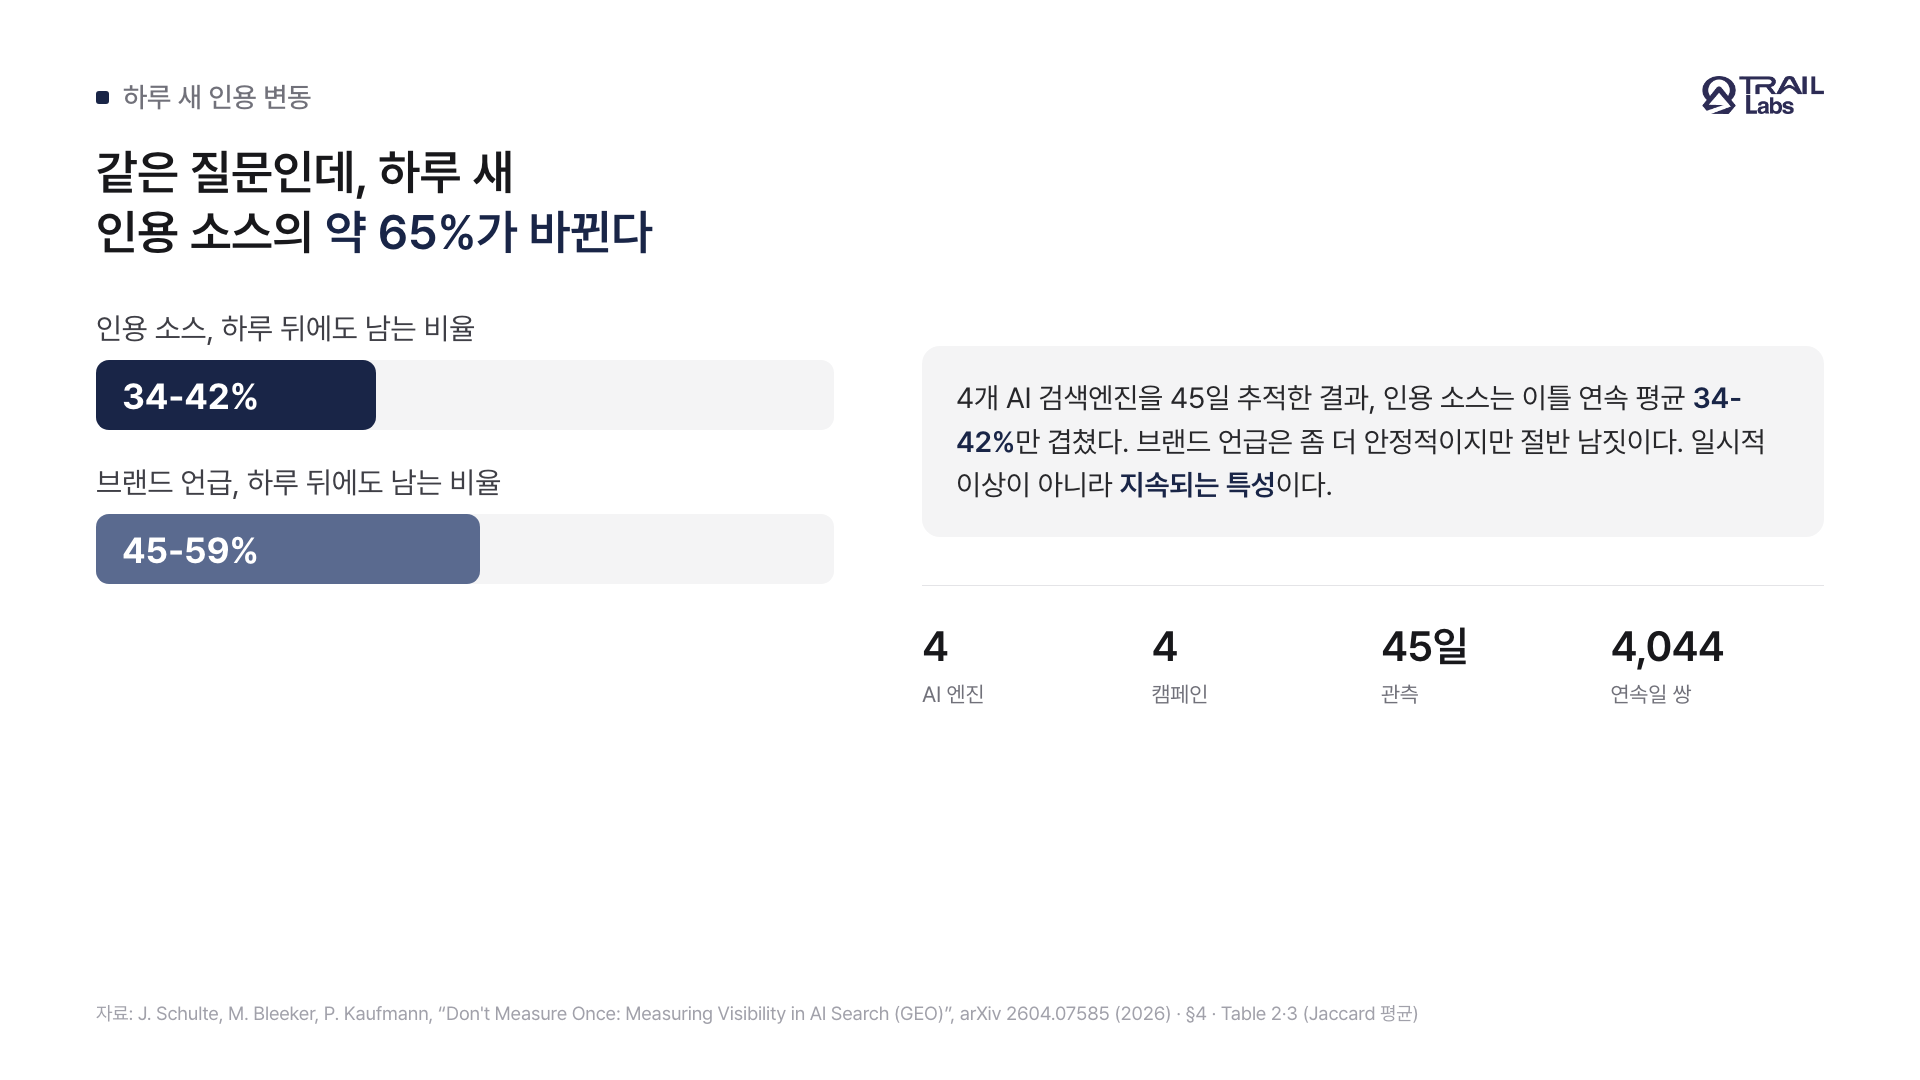
그림 1. 하루 새 인용 변동.
변동의 원인은 시간일까요, 모델일까요?
연구진은 시간이 지나며 생기는 변화와 모델 자체의 변동을 나눠 봤어요 [1]. 같은 날 즉시 다시 실행한 소스의 겹침은 Jaccard 0.32-0.43으로, 하루 간격으로 잰 0.34-0.42와 비슷한 범위였어요 [1]. 시간이 거의 흐르지 않은 재실행에서도 이만큼 흔들린다는 것은, 변동의 상당 부분이 모델의 확률적 생성에서 온다는 관찰이에요 [1].
그래서 한 번의 측정이 담은 노이즈는 더 자주 잰다고 줄지 않아요 [1]. 노이즈는 여러 측정의 평균을 내야 줄어드는데, 평균은 같은 시점에 여러 번 돌리거나(반복 횟수) 여러 날을 쌓아서(관측 창) 낼 수 있어요 [1]. 프롬프트별 편차도 커서, 어떤 질의는 Jaccard 0.8을 넘게 안정적이고 어떤 질의는 0.2 아래로 거의 매번 바뀌었어요 [1].
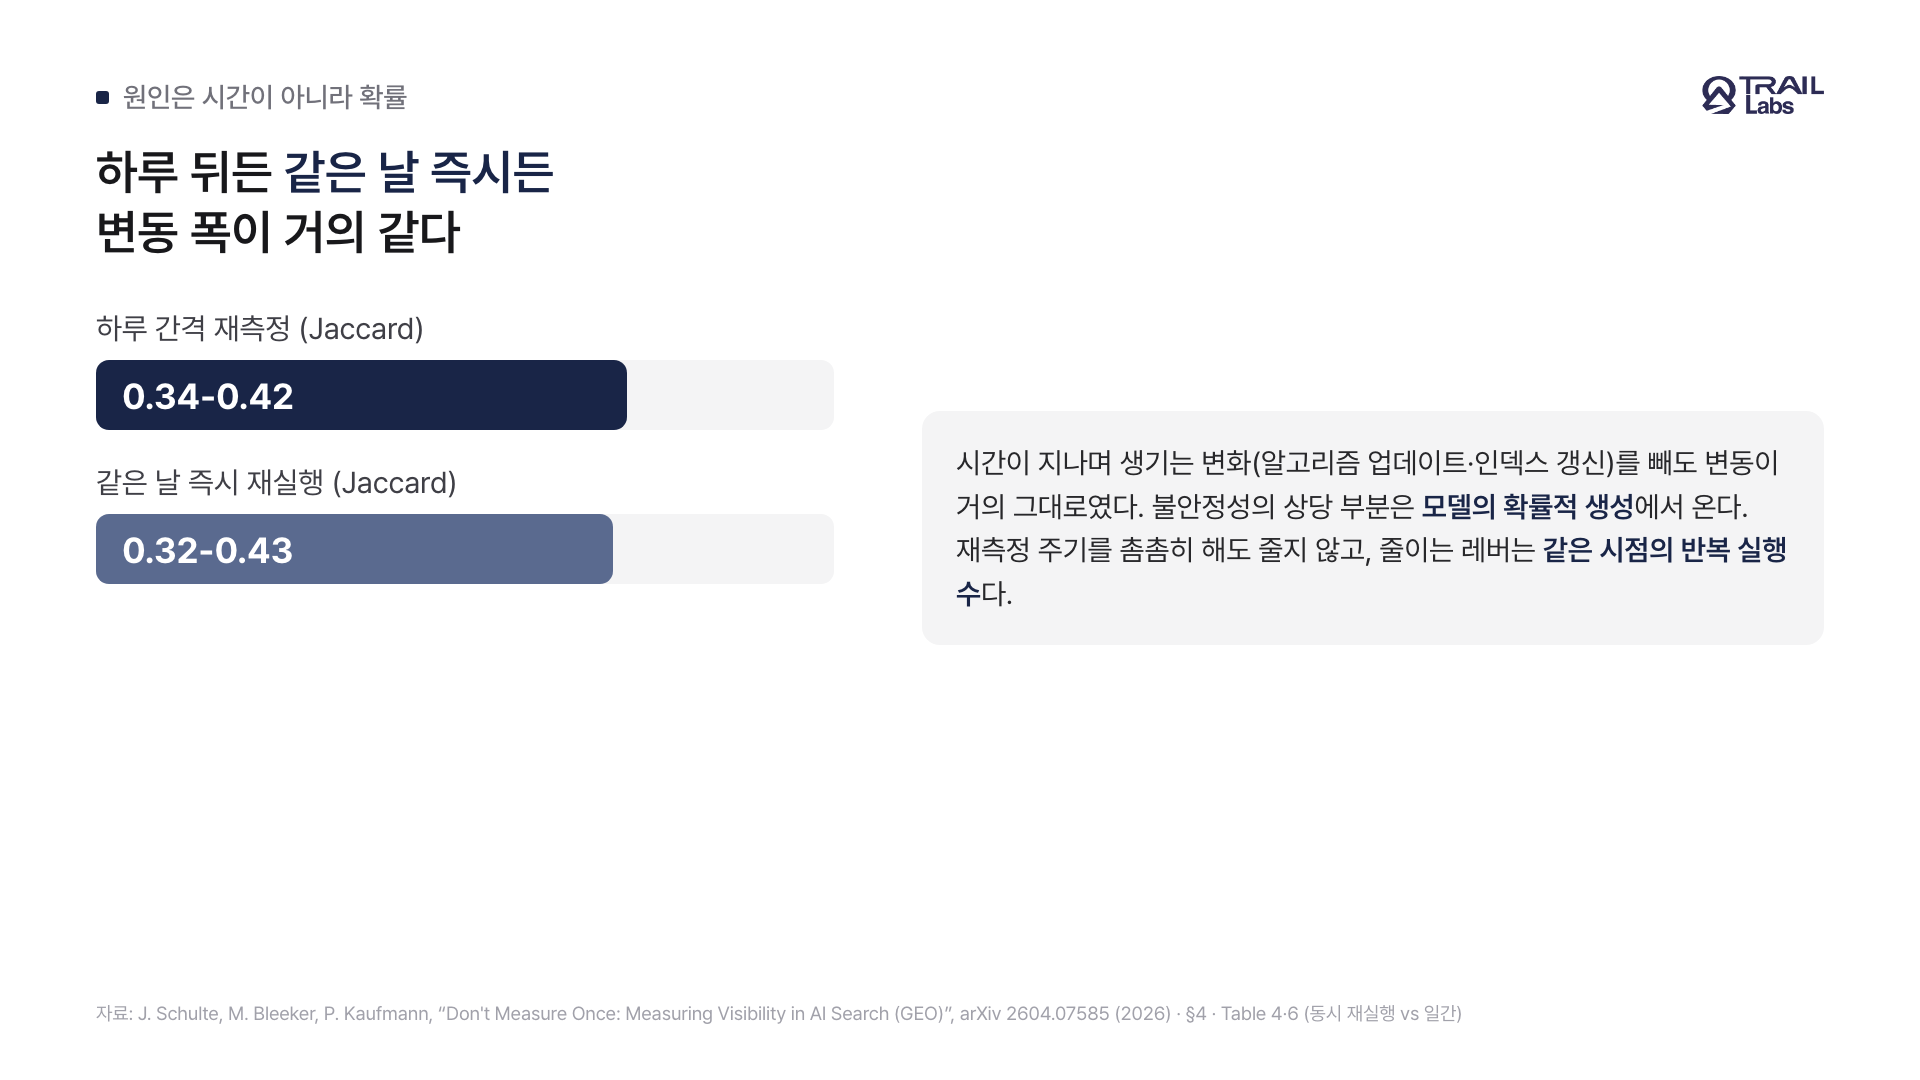
그림 2. 변동의 원인은 시간보다 모델의 확률성.
가시성을 믿으려면 몇 번, 며칠을 재야 하나요?
단일 측정은 표준오차(SE)가 0.37로 사실상 무정보예요 [1]. 참 검출률이 50%여도 명목 95% 구간이 매우 넓게 벌어져요 [1]. 연구진은 10번 반복 데이터를 참값으로 삼고 반복 횟수를 늘려 가며 SE를 추정했어요 [1].
| 반복 횟수 | 표준오차(SE) | 신뢰구간 반폭(±) |
|---|---|---|
| 1번 | 0.370 | 0.724 |
| 2번 | 0.246 | 0.483 |
| 3번 | 0.188 | 0.369 |
| 7번 | 0.081 | 0.158 |
| 8번 | 0.062 | 0.121 |
표 1. 반복 횟수별 브랜드 검출률 추정의 표준오차와 95% 신뢰구간 반폭 [1].
브랜드 검출률 SE는 7번에서 0.10 밑, 8번에서 0.08 밑으로 떨어졌어요 [1]. 어떤 URL이 인용되는지까지 보려면 소스 커버리지가 더 느리게 수렴해서 8번이 필요했어요 [1]. 다만 참값을 같은 10번 실행의 평균으로 잡았기 때문에, 7-8번의 표준오차는 다소 낙관적일 수 있어요 [1].
반복과 별개로, 하루 1번씩 여러 날을 쌓아 평균을 내도 표준오차가 내려가요 [1]. 관측 창으로 보면 2주에 SE 0.08, 4주에 0.03까지 떨어졌어요 [1]. 저자 권고는 프롬프트당 하루 7번 이상 반복과 2-4주 롤링 관측이에요 [1].
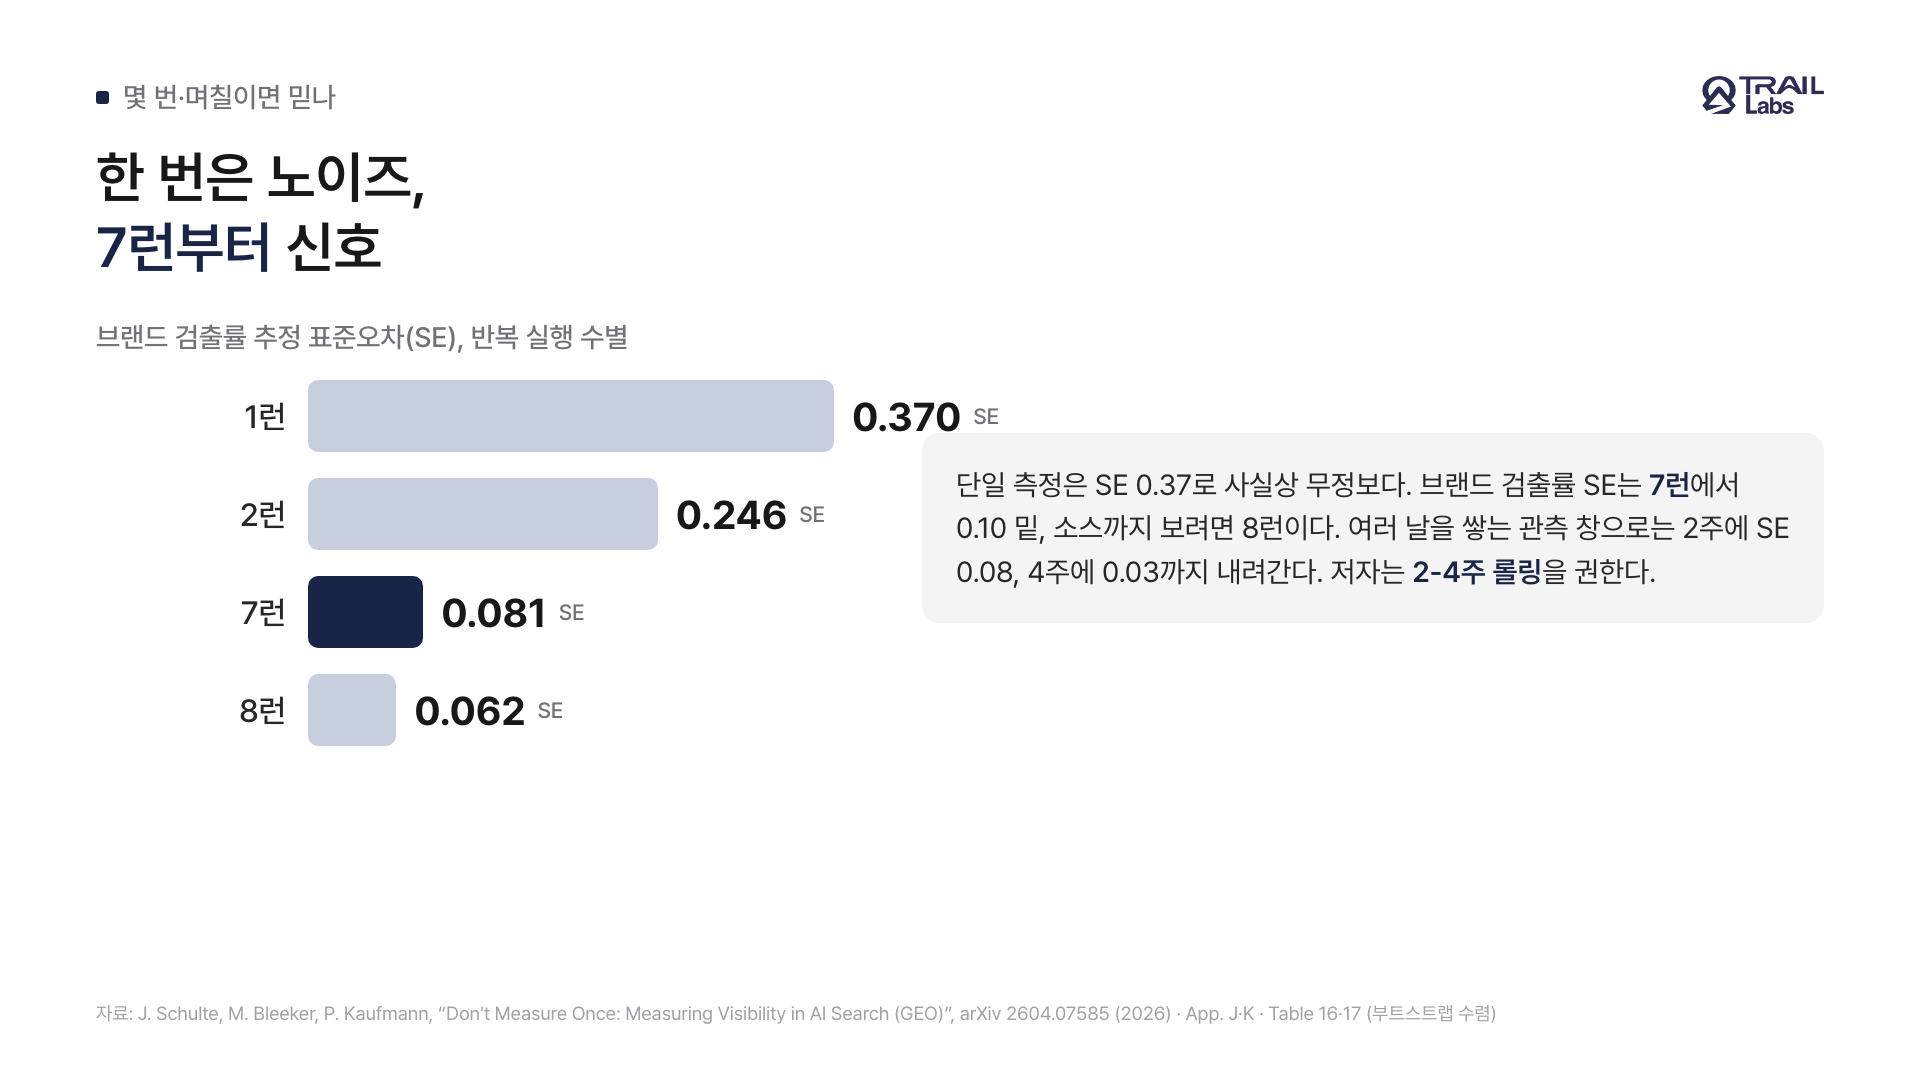
그림 3. 한 번은 노이즈, 7번 반복부터 신호.
이 연구의 한계는 무엇인가요?
저자들이 밝힌 한계가 분명해요 [1]. 모든 데이터가 스위스 소재 서버에서 수집돼 스위스 IP와 로케일로 서빙됐기 때문에, 다른 지역이나 언어권으로 일반화하기 어려워요 [1]. 캠페인은 4개, arXiv 프리프린트이며 게재처 표시가 없고, 코드 저장소에는 라이선스가 없어요 [1]. 브랜드 검출은 고정된 단어 목록 매칭이라 동의어나 약어로 언급된 브랜드는 놓칠 수 있어요 [1].
또한 저자 한 명이 GEO 모니터링 벤더를 겸하고 있어요 [1]. "더 많이 재야 한다"는 결론은 반복 측정을 파는 쪽에 유리한 방향이에요. 같은 이해는 반복 추적을 파는 우리에게도 똑같이 걸려서, 이 결론은 그만큼 거리를 두고 봤어요.
TRAIL Search와 어떻게 연결되나요?
이 연구는 우리가 가시성을 반복 측정하는 이유를 수치로 뒷받침해요. TRAIL Search는 브랜드명이 없는 발견형 프롬프트를 열 개 넘게 모아 여러 번 실행한 중앙값으로 점수를 내고, 측정한 런 수에 따라 예비·중간·고신뢰 세 단계 배지를 붙여요. 런 사이에 결과가 뒤바뀌는 정도는 따로 보여 주고요. 재측정 주기로는 두 주에서 한 달을 권고해요. 이 논문은 우리 측정 근거 목록에 이미 들어가 있어요.
다만 기본 반복 횟수는 저비용 추적을 위해 적게 잡혀 있어서, 이 논문이 제시한 고신뢰 기준(하루 7-8번)에는 못 미쳐요 [1]. 중요한 의사결정용 판정에는 반복 횟수를 더 늘려요. 한편 우리가 점수 변동을 노이즈로 보는 기준은 이 논문이 직접 검증하지는 않았어요. 논문은 겹침 유사도와 표준오차를 재지 우리 합성 점수의 포인트 변동을 재지 않거든요. 그래서 이 기준은 실무 관례로 두고, 실제 재측정 데이터가 쌓이면 보정해요.
Frequently asked questions
AI 검색 가시성은 왜 매번 다르게 나오나요?
생성형 검색은 포함 아니면 배제로 움직여요. 한 응답에 등장했다가 다음 응답에는 완전히 사라지곤 해요. 저자들은 그 원인을 토큰을 확률적으로 생성하는 특성과, RAG가 여러 소스를 제한된 답변 공간으로 압축하며 근거를 고르는 과정으로 봐요. 이 연구는 4개 AI 검색엔진을 45일 추적해 그 변동을 수치로 확인했어요.
AI 검색 인용은 하루에 얼마나 바뀌나요?
이 연구에서 인용된 소스는 이틀 연속으로 평균 34-42%만 겹쳤어요(Jaccard). 겹치지 않은 비율로 보면 하루 새 약 65%가 바뀐 셈이에요. 브랜드 언급은 좀 더 안정적이어서 45-59%가 겹쳤는데, 이 값은 검출률이 70% 이상인 3개 캠페인에서 잰 값이에요.
AI 검색 가시성 변동은 알고리즘 업데이트 때문인가요?
알고리즘 업데이트가 주된 원인은 아니에요. 같은 날 즉시 다시 실행한 결과의 겹침(Jaccard 0.32-0.43)이 하루 간격으로 잰 겹침(0.34-0.42)과 비슷했어요. 시간이 거의 흐르지 않은 재실행에서도 이만큼 흔들린다는 것은, 변동의 상당 부분이 모델의 확률적 생성에서 온다는 관찰이에요.
AI 검색 브랜드 노출을 믿으려면 몇 번 측정해야 하나요?
한 번은 부족해요. 단일 측정은 표준오차(SE) 0.37로 사실상 무정보예요. 이 연구에서 브랜드 검출률 SE는 7번 반복하면 0.10 밑, 8번이면 0.08 밑으로 떨어졌어요. 어떤 URL이 인용되는지까지 보려면 8번이 필요했어요. 여러 날을 쌓는 관측 창으로는 2주에 SE 0.08, 4주에 0.03까지 내려가서, 저자들은 하루 7번 이상 반복과 2-4주 롤링 관측을 권해요.
References
Summary
- St. Gallen 연구진이 4개 AI 검색엔진(ChatGPT·Gemini·Google AI Mode·Perplexity)을 4개 캠페인에서 45일 추적하고, 같은 날 최대 10번 즉시 재실행한 데이터까지 모아 가시성의 변동을 측정했어요.
- 인용된 소스는 하루 사이에 평균 34-42%만 겹쳐(겹치지 않은 비율로는 약 65%), 매일 크게 바뀌었고, 브랜드 언급은 좀 더 안정적인 45-59%였어요.
- 같은 날 즉시 재실행한 변동(Jaccard 0.32-0.43)이 하루 간격 변동(0.34-0.42)과 비슷해, 흔들림의 상당 부분이 시간보다 모델의 확률적 생성에서 온다는 것을 보였어요.
- 단일 측정은 SE 0.37로 무정보에 가깝고, 반복으로는 7번·8번, 여러 날 창으로는 2주·4주에서 SE가 크게 내려갔어요. 저자들은 하루 7번 이상 반복과 2-4주 롤링 관측을 권해요.
- 데이터가 스위스 서버에서만 수집됐고 4개 캠페인·arXiv 프리프린트이며 저자 한 명이 GEO 모니터링 벤더를 겸한다는 한계를 밝혀요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility