AI 답변은 사람 이름을 얼마나 낼까, 명단 기반 측정이 놓치는 것
부동산·자동차·보험 추천 질문에서 AI는 답변 4개 중 1개꼴로 개인 이름을 냈어요. 같은 답변을 명단과 맞춰 세면 이름 언급의 0.5%만 잡혔어요. arXiv 프리프린트 읽기
AI 검색에 "바르샤바 최고의 부동산 중개인"을 물으면, 답변 4개 중 1개꼴로 특정 개인의 이름이 나왔어요. 같은 답변을 미리 만든 939명 명단과 맞춰 세면 모델이 낸 이름 모양 언급 27,293건 중 128건, 0.47%만 잡혔어요 [1]. 이 결과는 2026년 7월 arXiv에 올라온 단독 저자 프리프린트이고, 저자는 AI 가시성 측정 서비스를 파는 Rankfor.AI(에스토니아 탈린) 소속이에요. 동료 심사를 거친 논문은 아니고, 저자 스스로 이해관계를 밝혔어요 [1].
이 글은 arXiv 원문 v2의 본문과 표 1부터 표 7까지, 그림 1부터 그림 5까지를 2026년 10월에 읽고 수치를 하나씩 대조해 정리했어요 [1]. 저자가 공개했다고 밝힌 데이터와 코드는 직접 돌려 보지 않았어요. 저자와 이해관계는 없어요.
AI 검색은 추천할 때 개인 이름을 얼마나 언급하나요
AI 가시성 연구는 지금까지 주로 회사 단위를 쟀어요. 모델이 어떤 브랜드를 추천하는지, 그게 평판과 맞는지를 봤어요. 이 연구는 한 단계 아래로 내려가, 구매자가 회사보다 "사람"을 고르는 업종을 골랐어요. 부동산 중개인, 자동차 딜러 영업 담당, 보험 설계사예요 [1].
설계는 이래요. 폴란드, 아일랜드, 네덜란드, 발트(리투아니아·에스토니아) 4개 시장에 구매 의도 질문 120개를 만들고, 웹 검색을 쓰는 모델 4종(GPT-5.6 Sol, Gemini 3.6 Flash, Perplexity Sonar Pro, Grok 4.5)에 각각 5회씩 물었어요. 모두 2,400건이고 2026년 7월 24일 하루에 수집했어요 [1].
결과는 2,400건 중 619건, 25.8%의 답변이 개인 전문가 이름을 냈어요. 탐지기의 정밀도는 96.9%지만 재현율은 61.7%라서, 논문의 모든 비율은 하한값이에요 [1].
가장 큰 차이는 업종이었어요. 부동산 35.4%, 자동차 딜러 32.9%에 비해 보험은 9.1%였어요. 모델 차이도 컸어요. Grok 38.0%, Perplexity 34.0%, GPT-5.6 Sol 21.8%, Gemini 9.3%로 네 배 넘게 벌어졌어요. 여러 요인을 함께 넣은 모형에서 보험은 부동산보다 이름이 나올 승산이 12분의 1이었고, 모델은 아래에서 위까지 승산을 약 11배 바꿨어요 [1].
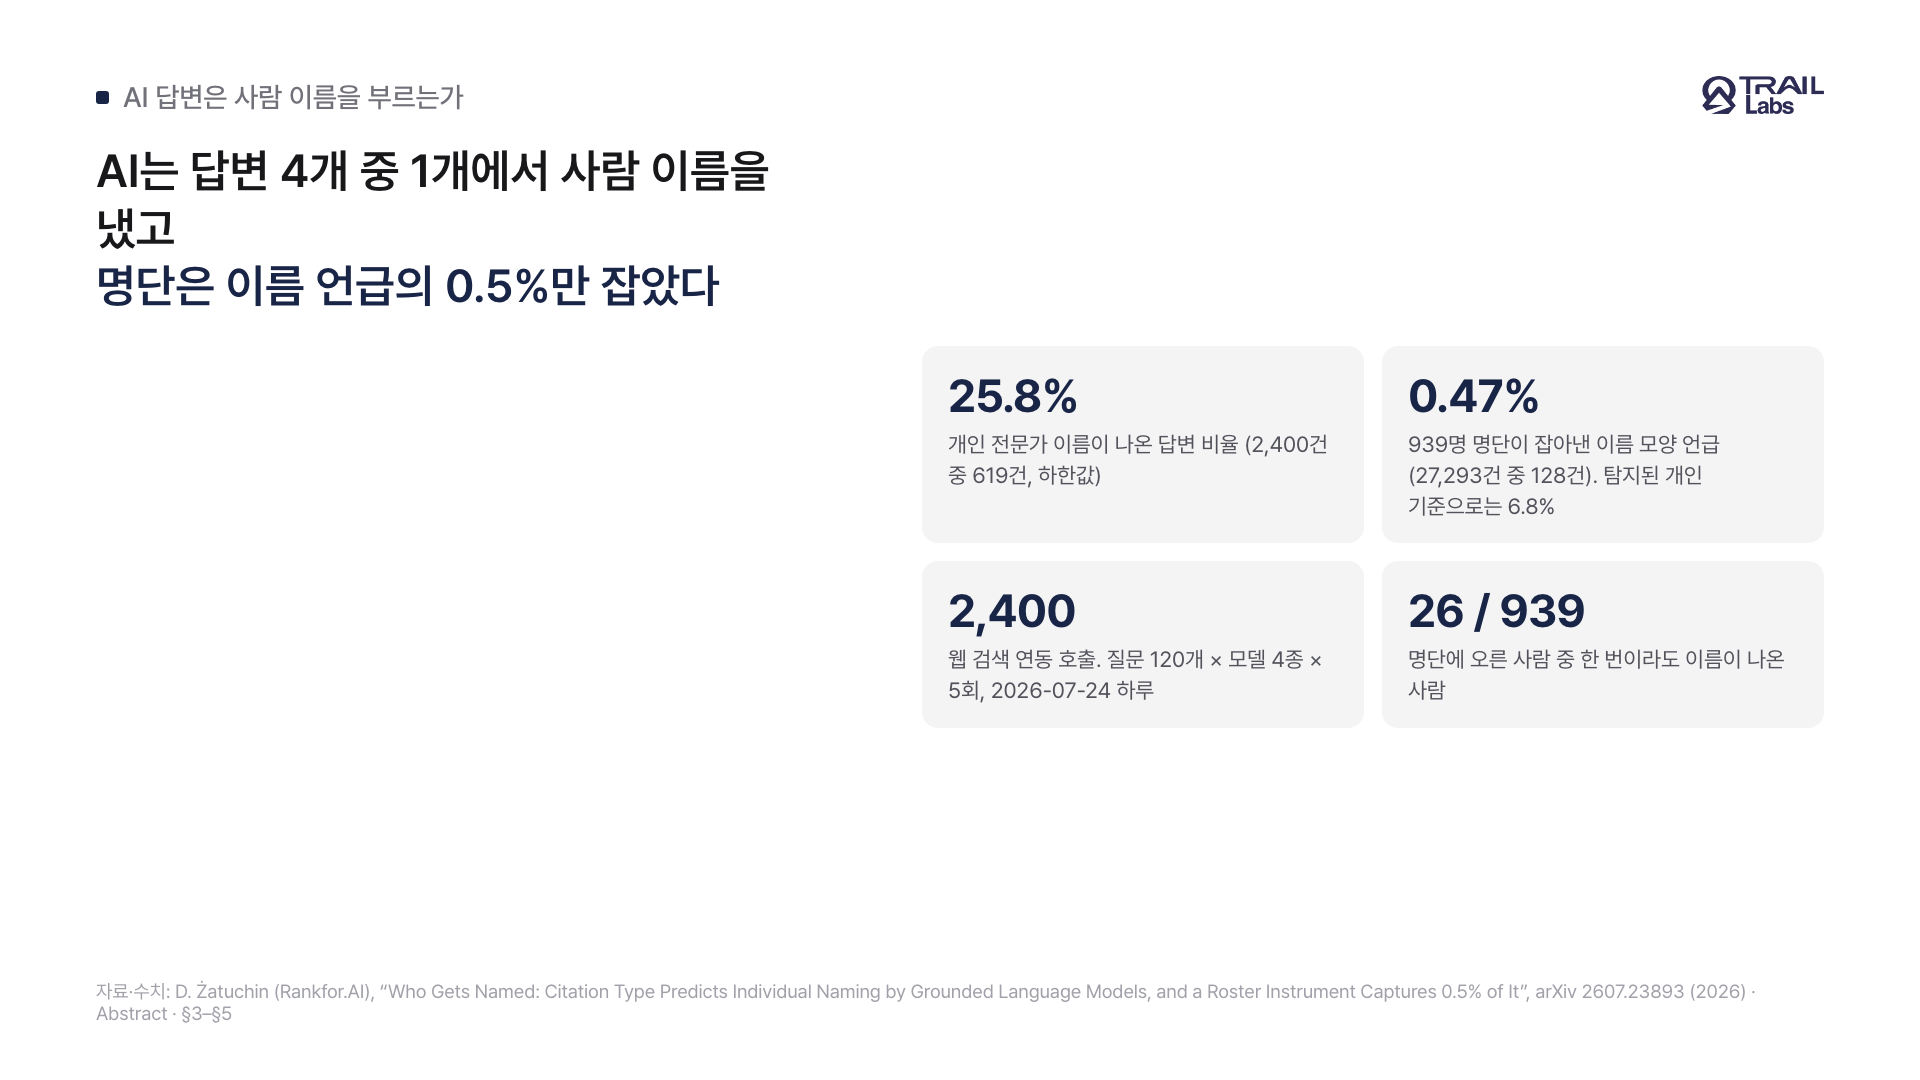
그림 1. AI는 답변 4개 중 1개꼴로 개인 이름을 냈고, 939명 명단은 이름 모양 언급의 0.47%만 잡았어요 [1].
AI 답변 속 언급을 명단으로 세면 무엇을 놓치나요
개인의 AI 가시성을 재는 가장 쉬운 방법은 명단이에요. 실제 전문가 목록을 만들고, 답변에서 그 이름을 찾아 세는 방식이에요. 저자는 LinkedIn 검색으로 939명 명단을 만들어 이 방식을 같은 2,400건에 함께 돌렸어요 [1].
명단은 모델이 낸 이름 모양 언급 27,293건 중 128건(0.47%)을 잡았어요. 명단 없는 탐지기가 개인으로 판정한 1,876건과 비교해도 6.8%예요. 939명 중 한 번이라도 이름이 나온 사람은 26명이었어요 [1].
문제는 이 숫자가 그럴듯해 보인다는 점이에요. 명단 기준으로 보면 폴란드는 600건 중 0건, 0.0%였어요. 같은 답변을 명단 없이 세면 폴란드 모델들은 31.3%의 답변에서 개인 이름을 냈어요. 명단 기준 수치는 모델 행동이 아니라 "명단과 모델 답변이 겹친 정도"를 잰 거예요 [1].
모델 비교도 뒤집혔어요. 명단 없이 세면 GPT-5.6 Sol 21.8%와 Gemini 9.3%는 확실히 달라요. 명단 기준으로는 3.3%와 3.2%로 구분이 안 돼요. 시장 순서도 바뀌었어요. 명단은 시장이 작을수록 겹칠 확률이 높아서, 시장 크기 순서를 시장 효과처럼 만들어 냈어요 [1].
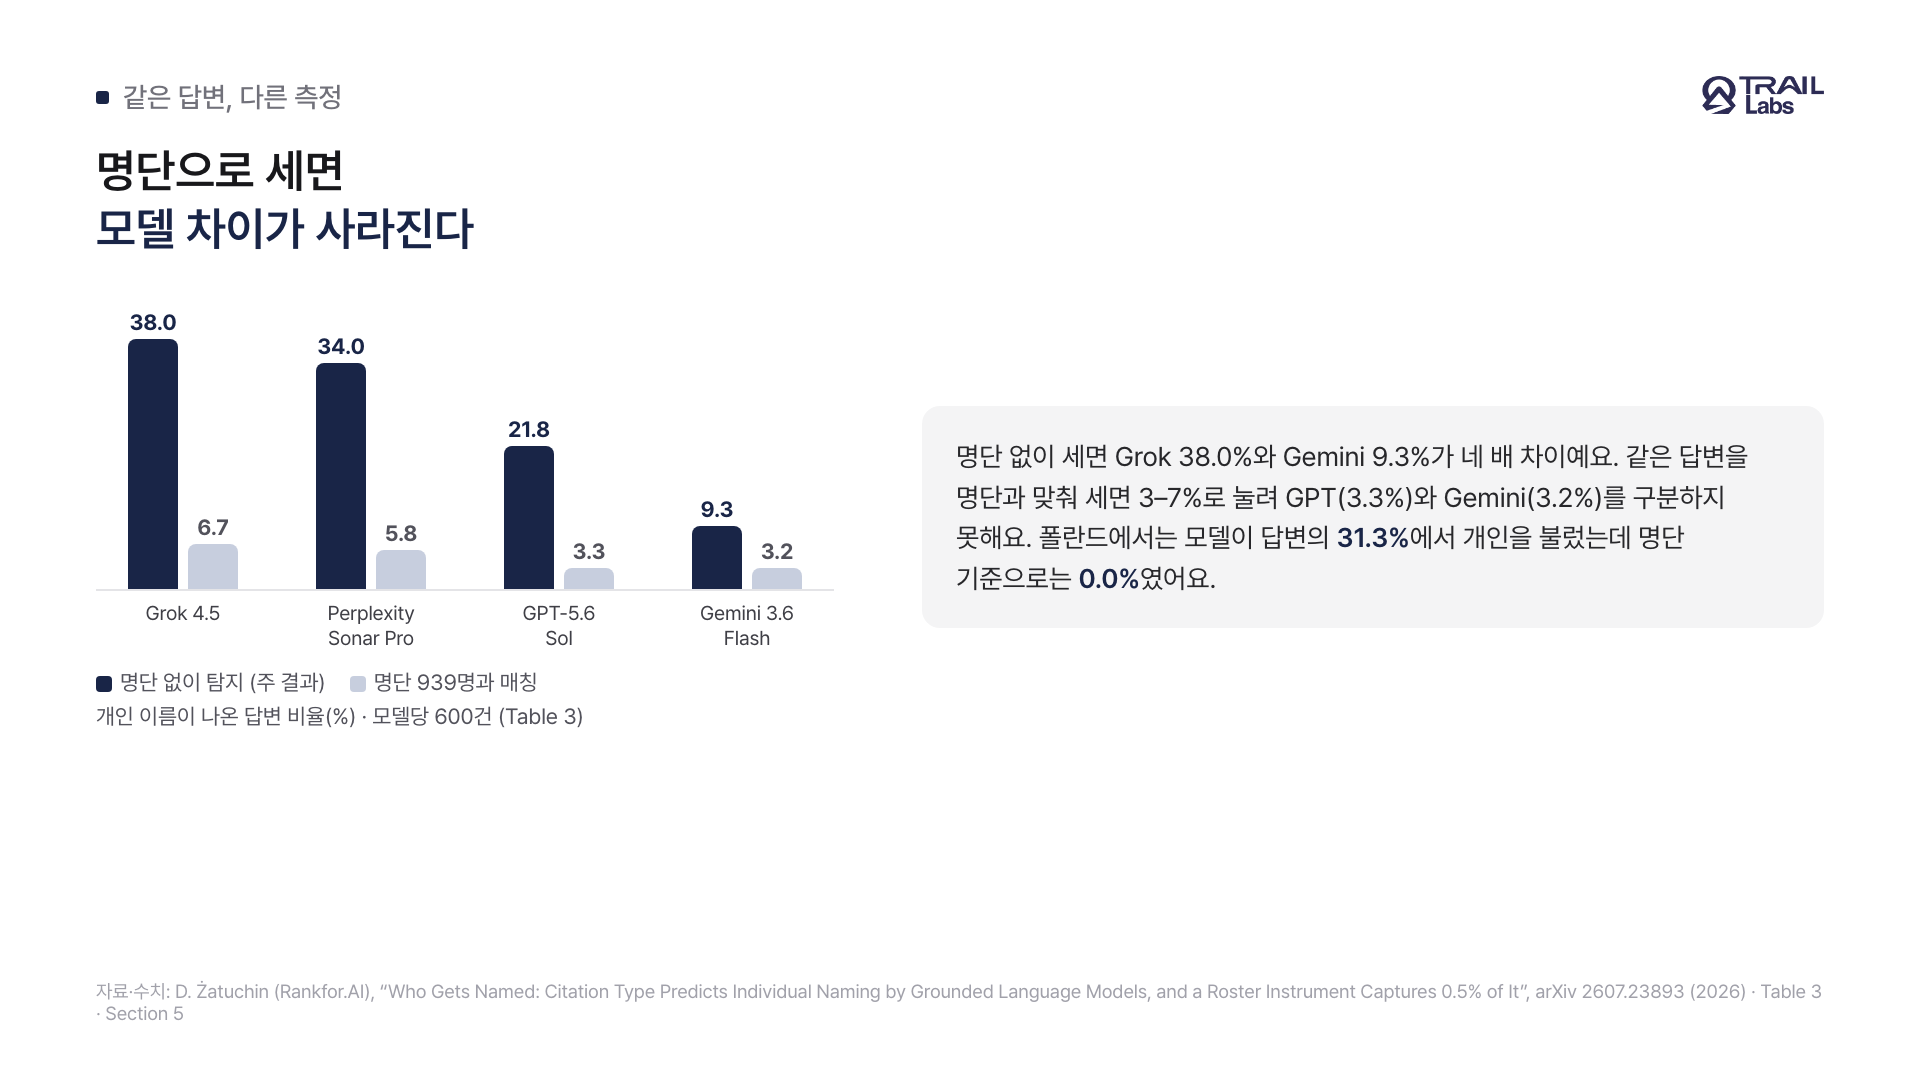
그림 2. 명단 없이 세면 모델 차이가 네 배인데, 명단과 맞춰 세면 모두 낮게 눌려 차이가 사라져요 [1].
| 모델 | 명단 없는 탐지 (주 결과) [1] | 명단 매칭 [1] |
|---|---|---|
| Grok 4.5 | 38.0% | 6.7% |
| Perplexity Sonar Pro | 34.0% | 5.8% |
| GPT-5.6 Sol | 21.8% | 3.3% |
| Gemini 3.6 Flash | 9.3% | 3.2% |
표 1. 논문 표 3에서 옮긴 값이에요. 모델당 600건이에요 [1].
AI 답변에 이름이 나오는 데 어떤 인용 출처가 영향을 주나요
먼저 인용 개수는 영향이 없었어요. 이름이 나온 답변은 평균 7.90개, 이름이 나오지 않은 답변은 8.81개를 인용했어요 [1].
차이는 출처의 종류에서 났어요. 저자는 인용 도메인 2,182개를 20개 유형으로 다시 분류했고, 이름이 나온 답변과 회사만 나온 답변의 인용 비중을 비교했어요. 이름이 나온 답변은 개인 본인이 운영하는 사이트를 2.58%p, 업종 포털을 4.27%p 더 인용했고, 소셜 플랫폼은 2.19%p 덜 인용했어요. 회사 사이트는 44.1% 대 45.5%로 차이가 없었어요 [1].
이 결과는 처음 분석과 반대예요. 수집 당시 분류기는 40여 개 도메인 목록에 없는 도메인을 전부 "회사 소유 페이지"로 넣었어요. 그 기본값이 전체 인용의 87.2%를 빨아들였고, reddit.com도 회사 페이지로 분류됐어요. 그 상태에서는 "회사 사이트에 이름이 잘 보이면 AI가 그 사람을 부른다"는 결론이 나왔는데, 다시 분류하자 사라졌어요 [1]. 저자는 이 실패에 "기본값이 넓은 허용 목록은 기본값 자체를 발견으로 보고한다"는 이름을 붙였어요.
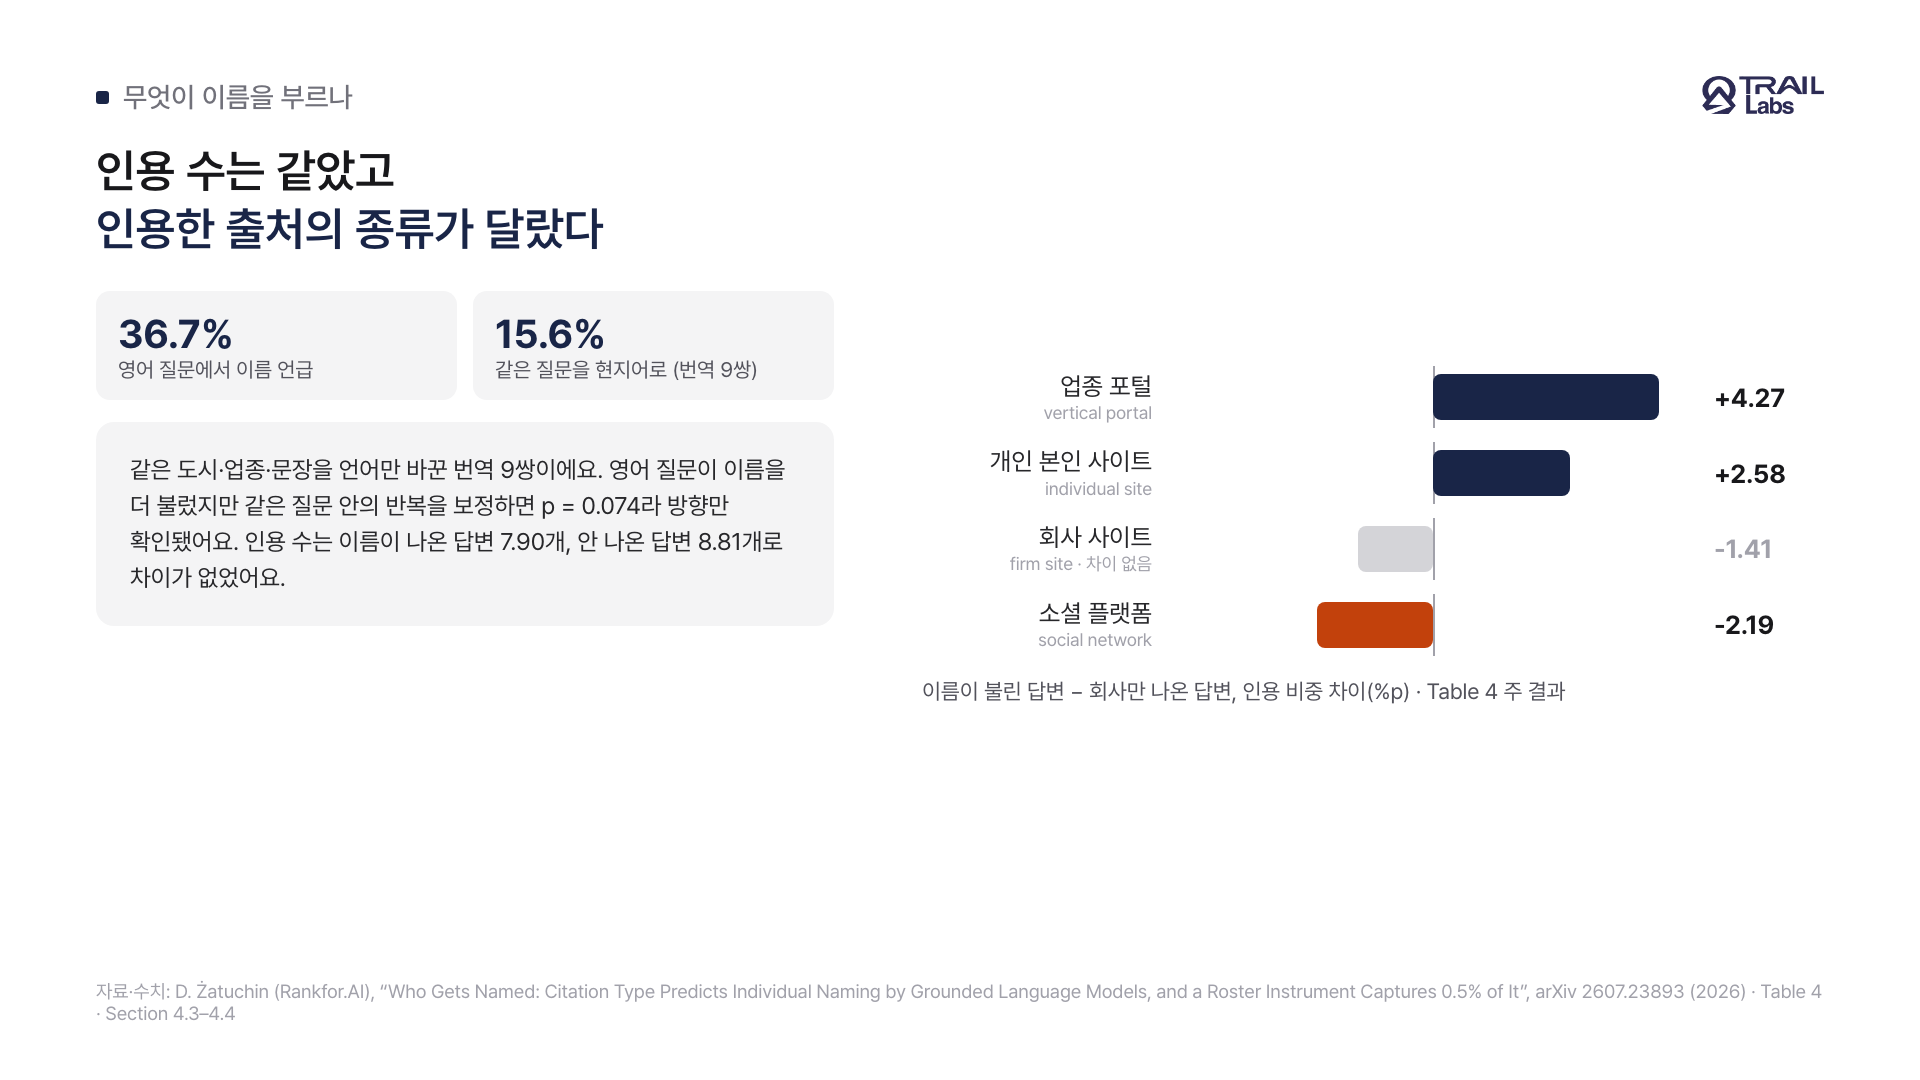
그림 3. 인용 수는 같았고 인용한 출처의 종류가 달랐어요. 회사 사이트 비중은 차이가 없었어요 [1].
질문 언어에 따라 AI 추천 결과가 달라지나요
같은 도시·업종·문장을 언어만 바꾼 번역 9쌍이 가장 깨끗한 비교예요. 영어 질문은 180건 중 66건(36.7%), 같은 질문의 현지어 번역은 180건 중 28건(15.6%)에서 이름을 냈어요 [1].
다만 저자는 방향만 확인됐다고 적어요. 같은 질문을 20번씩 답한 반복을 보정하면 p = 0.074예요. 도시별로도 달라서 암스테르담과 빌뉴스에서는 영어가 높았지만, 바르샤바에서는 영어 29.0%, 폴란드어 36.7%로 오히려 반대였어요. "영어로 물으면 이름이 더 나온다"는 일반 법칙으로 읽으면 안 돼요 [1].
실험은 어떻게 설계했고 무엇을 고쳤나요
측정 과정에서 저자가 고친 것들이 이 논문에서 가장 쓸모 있는 부분이에요 [1].
- 웹 검색이 안 켜진 호출: 처음 600건의 OpenAI 호출은 Chat Completions 엔드포인트를 썼는데, 이 엔드포인트는 GPT-5.x에 실제 웹 검색을 지원하지 않았어요. 학습 지식만으로 답한 셈이라, Responses API의 web_search 도구로 600건을 다시 수집했어요 [1].
- 출처 없는 답변: 다시 수집한 뒤에도 2,400건 중 177건(7.38%)에 인용이 없었고, 그중 137건이 OpenAI였어요 [1].
- 같은 이름의 미국 도시: 바르샤바 자동차 딜러를 물으면 미국 인디애나주 Warsaw의 딜러가 나왔어요. 바르샤바 질문 인용의 4.68%가 미국 동명 도시의 지역 업체였어요 [1].
- 사람 이름을 딴 회사: 탐지된 이름의 13.3%가 사람 이름 모양의 회사명이었고, 아일랜드에서는 47.8%였어요. 이 규칙 하나로 시장 순위가 바뀌었어요 [1].
통계는 같은 질문 안의 반복을 보정했어요. 2,400건이지만 질문 안 상관이 커서 유효 표본은 약 407건이에요 [1].
이 연구의 한계는 무엇인가요
저자가 밝힌 한계부터 보면, 탐지기 재현율이 61.7%라 모든 비율이 하한이고, 2026년 7월 24일 하루의 약 두 시간 안에 수집해 시간에 따른 안정성은 말할 수 없어요. 명단은 LinkedIn 검색이 보여 준 편의 표본이고, 모델 간 동의율은 표본이 작아 결론을 내지 않았어요 [1].
이 글에서 더 짚을 점은 두 가지예요. 첫째, 저자는 개인 AI 가시성을 측정하는 서비스를 파는 회사 소속이고 동료 심사 전 단계예요. 저자도 이해관계를 밝히면서, 영업에 가장 유리했던 "회사 사이트" 결론을 스스로 철회했다고 적었어요. 둘째, 유럽 4개 시장과 3개 업종만 다뤘어요. 한국어 질문이나 국내 AI 검색에서 같은 양상이 나오는지는 따로 재야 해요 [1].
함께 읽을 글로, 브랜드가 AI 답변에 언급되기까지의 단계를 다룬 AI 답변 브랜드 언급 단계 모형이 있어요.
TRAIL에서는
TRAIL Search도 AI 답변 속 언급을 명단 방식으로 세요. 사용자가 등록한 자사 브랜드와 경쟁사 이름(별칭 포함)을 답변에서 찾아 순위와 인용 여부를 기록해요. 그래서 이 논문의 지적이 우리에게 그대로 해당돼요. 등록하지 않은 경쟁사가 답변에 나오면 지금 구조는 세지 못하고, 그게 얼마나 되는지는 아직 재지 않았어요.
우리가 이미 갖춘 장치도 있어요. 출처를 가져오지 못한 답변은 언급 없음으로 세지 않고 측정 불가로 따로 표시해요. 이 논문의 폴란드 사례처럼 "측정이 못 본 것"을 "언급이 없는 것"으로 읽는 실수를 막으려는 장치예요. 다음 단계는 명단 밖 이름을 답변에서 따로 뽑아, 등록 목록이 답변의 몇 퍼센트를 덮는지 함께 보여 주는 거예요. 이건 계획이고 아직 구현하지 않았어요.
여러분이 쓰는 AI 가시성 도구는 미리 등록한 이름만 세나요, 아니면 답변에 나온 이름을 따로 뽑아 보여 주나요. 두 숫자가 얼마나 달랐는지 확인해 보신 적이 있다면 듣고 싶어요.
Dmitrij Żatuchin, "Who Gets Named: Citation Type Predicts Individual Naming by Grounded Language Models, and a Roster Instrument Captures 0.5% of It", arXiv 2607.23893 (2026).
#AI가시성 #GEO #명단기반측정 #개인브랜딩 #AI검색 #논문리뷰 #TRAILLabs
Frequently asked questions
AI 검색은 추천할 때 개인 이름을 얼마나 언급하나요?
유럽 4개 시장의 부동산·자동차 딜러·보험 추천 질문 2,400건에서 웹 검색을 쓰는 모델 4종이 개인 전문가 이름을 낸 답변은 25.8%였어요. 탐지기 재현율이 61.7%라 실제 비율은 이보다 높을 수 있어요. 업종(보험 9.1%, 부동산 35.4%)과 모델(Gemini 9.3%, Grok 38.0%)에 따라 크게 달랐어요 [1].
AI 답변 속 언급을 명단으로 세면 무엇을 놓치나요?
명단에 없는 이름은 아예 세지 못해요. 이 연구에서 LinkedIn으로 만든 939명 명단은 모델이 낸 이름 모양 언급 27,293건 중 128건(0.47%)만 잡았어요. 폴란드에서는 모델이 답변의 31.3%에서 개인 이름을 냈는데 명단 기준으로는 0.0%였어요 [1].
AI 답변에 이름이 나오는 데 어떤 인용 출처가 영향을 주나요?
인용 개수는 차이가 없었고 출처의 종류가 달랐어요. 이름이 나온 답변은 개인 본인 사이트를 인용한 비중이 2.58%p, 업종 포털 비중이 4.27%p 높았어요. 소셜 플랫폼은 2.19%p 낮았고, 회사 사이트 비중은 차이가 없었어요(44.1% 대 45.5%) [1].
질문 언어에 따라 AI 추천 결과가 달라지나요?
같은 도시·업종·문장을 언어만 바꾼 번역 9쌍에서 영어 질문은 36.7%, 현지어 질문은 15.6%의 답변에서 이름을 냈어요. 다만 같은 질문 안의 반복을 보정하면 p = 0.074라 방향만 확인됐고, 바르샤바처럼 차이가 없는 도시도 있었어요 [1].
References
Summary
- 유럽 4개 시장의 추천 질문 120개를 웹 검색 연동 모델 4종에 5회씩 물은 결과, 개인 전문가 이름이 나온 답변은 25.8%였고 이 값은 하한이에요.
- 업종과 모델이 이름 언급을 가장 크게 갈랐어요. 보험은 부동산보다 이름 언급 승산이 12분의 1이었고, 모델별로는 Gemini 9.3%에서 Grok 38.0%까지 벌어졌어요.
- LinkedIn으로 만든 명단은 이름 모양 언급의 0.47%만 잡았고, 명단 기준 수치는 모델 차이와 시장 순서를 왜곡했어요.
- 이름이 나온 답변은 인용 수가 같은 대신 개인 본인 사이트와 업종 포털을 더 인용했고, 회사 사이트 인용 비중은 차이가 없었어요.
- 미국의 같은 이름 도시(인디애나주 Warsaw 등)의 업체가 답변에 섞이고, 사람 이름을 딴 회사명이 많아 측정 규칙이 결과를 바꿨어요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility