Video-RAG, 긴 영상 이해에서 프레임을 늘리는 대신 OCR·음성 텍스트를 검색
학습 없이 OCR, 음성 인식, 객체 검출 결과를 질문에 맞춰 골라 붙였더니 긴 영상 벤치마크에서 성능이 올랐어요. NeurIPS 2025 논문 읽기
긴 영상을 이해시키려고 프레임을 더 넣으면 오히려 떨어질 수 있어요. Video-RAG는 프레임을 늘리는 대신 영상의 글자, 음성, 물체를 텍스트로 뽑아 질문에 맞게 검색해 넣고, 학습 없이 72B 모델의 Video-MME 점수를 자막 포함 기준 75.9에서 77.4로 올렸어요 [1]. NeurIPS 2025 본 학회에 실린 논문이고, 저자는 Xiamen University, University of Rochester 등 여러 기관의 연구진이에요 [1].
이 글은 arXiv 원문의 본문, 그림 2, 표 1부터 표 5까지를 2026년 10월에 읽고 수치를 하나씩 대조해 정리했어요 [1]. 코드는 GitHub에 공개되어 있지만 직접 돌려 재현하지는 않았어요. 저자들과 이해관계는 없어요.
긴 영상에서 프레임을 늘리면 왜 안 되나요
영상 이해 모델은 보통 영상을 일정 간격으로 잘라 프레임을 입력해요. 프레임이 많으면 정보도 많아질 것 같지만, 논문은 두 가지 문제를 짚어요 [1]. 첫째, 비슷한 장면이 반복되어 정보가 중복돼요. 둘째, 일정 수를 넘으면 성능이 떨어질 수 있어요. LongVA는 Video-MME에서 샘플 프레임을 128개에서 384개로 늘렸을 때 52.6%에서 51.8%로 떨어졌어요 [1][2].
긴 영상을 다루는 기존 방법은 두 가지예요. 하나는 긴 문맥을 처리하도록 모델을 다시 학습하는 방법인데, 대량의 데이터와 GPU가 필요해요. 다른 하나는 GPT-4o 같은 상용 모델을 에이전트로 쓰는 방법이에요. 논문은 VideoAgent로 Video-MME 전체를 돌리는 데 약 20일과 약 2,000달러의 API 비용이 든다고 적어요 [1][3].
Video-RAG는 무엇이고 어떻게 동작하나요
Video-RAG는 프레임을 더 넣는 대신, 늘어날 시각 토큰을 영상에서 뽑은 보조 텍스트로 바꿔요 [1]. 세 단계로 동작해요(그림 2) [1].
1단계, 질의 분해. 모델은 프레임 없이 질문만 보고 필요한 정보를 JSON 검색 요청으로 써요. 음성 요청(R_asr), 물체 요청(R_det), 물체의 위치·개수·관계 요청(R_type)으로 나뉘어요 [1].
2단계, 보조 텍스트 생성과 검색. 영상에서 세 종류의 데이터베이스를 병렬로 만들어요 [1].
- OCR: EasyOCR로 프레임마다 화면의 글자를 읽어요. 텍스트 조각은 Contriever[4]로 임베딩해 FAISS 색인에 넣고, 질문과의 유사도가 0.3을 넘는 조각만 가져와요.
- ASR: Whisper로 음성을 텍스트로 바꾼 뒤 청크로 나누고, OCR과 같은 방식으로 색인해요.
- 객체 검출: 질문의 물체 요청과 CLIP 유사도가 0.3을 넘는 키프레임만 골라 APE로 물체를 찾아요. 찾은 물체는 위치, 개수, 상대 관계를 담은 장면 그래프 문장으로 바꿔요.
3단계, 통합 생성. 가져온 텍스트를 시간순으로 정렬해 질문과 함께 프레임 입력에 붙여요. 논문의 수식은 다음과 같아요 [1].
여기서 는 샘플링한 프레임의 시각 특징, 은 검색된 보조 텍스트 묶음, 는 질문, 는 답이에요. 보조 텍스트는 평균 약 2.0K 토큰이라, 같은 영상의 자막 전체(약 3.0K 토큰)보다 짧아요 [1].
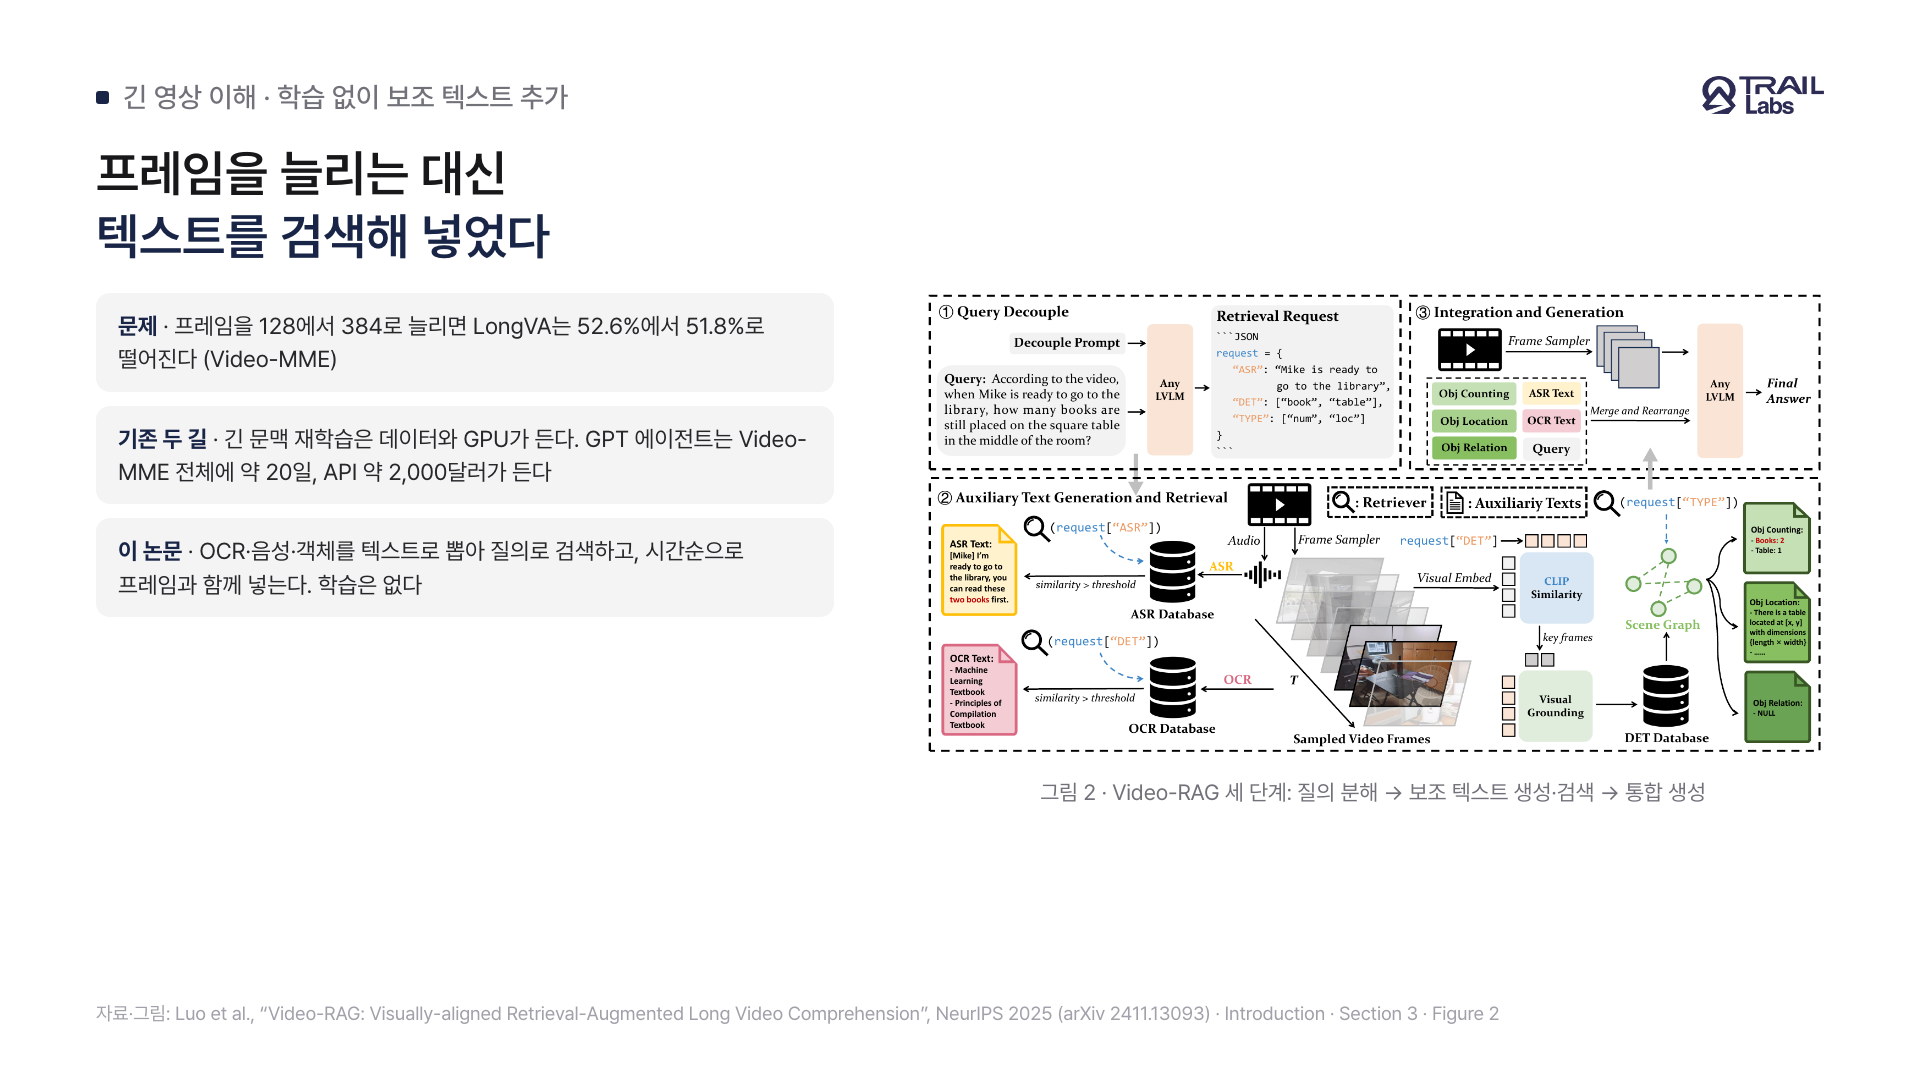
그림 1. Video-RAG의 세 단계예요. 질의 분해, 보조 텍스트 생성과 검색, 통합 생성 순서로 흘러요 [1].
실험 방법은 어떻게 했나요
Video-MME에서는 7개 공개 영상-언어 모델(7B 다섯 개, 72B 두 개)을 시험했어요. MLVU와 LongVideoBench에서는 LLaVA-Video 7B와 72B만 시험했어요 [1]. 오픈 모델의 수치는 저자들이 직접 재현한 값이고, GPT-4o와 Gemini 수치는 논문이 인용한 값이에요 [1]. 프레임 수는 각 모델의 공식 설정을 따랐고, 실험은 A100 80GB GPU에서 진행했어요. 두 임계값은 모두 0.3으로 고정했어요 [1].
질의 분해 프롬프트는 객관식 질문을 위해 설계되었다고 부록에 적혀 있어요. 본문에서 쓴 세 벤치마크는 모두 객관식이에요 [1].
결과와 성능은 얼마나 나왔나요
Video-MME에서 일곱 모델의 평균 성능은 자막 포함 기준보다 2.8점 올랐어요. 가장 큰 모델인 72B LLaVA-Video는 자막 포함 기준 75.9에서 77.4로 올랐고, 자막을 쓴 GPT-4o의 77.2를 0.2점 앞섰어요 [1].
| 벤치마크 · 모델 | 기준 | Video-RAG | 비교 (상용 모델, 논문 인용) |
|---|---|---|---|
| Video-MME · 72B LLaVA-Video | 75.9 (자막 포함) | 77.4 | GPT-4o 77.2, Gemini-1.5-Pro 81.3 (자막 포함) |
| LongVideoBench · 72B LLaVA-Video | 61.9 | 65.4 | GPT-4o 66.7, Gemini-1.5-Pro 64.0 |
| MLVU · 72B LLaVA-Video | 73.1 | 73.8 | GPT-4o 64.6 |
| LongVideoBench · 7B LLaVA-Video | 56.6 | 58.7 | - |
표 1. 논문의 표 1, 표 2, 표 3에서 옮긴 값이에요 [1]. 상용 모델 수치는 논문이 인용한 값이에요.
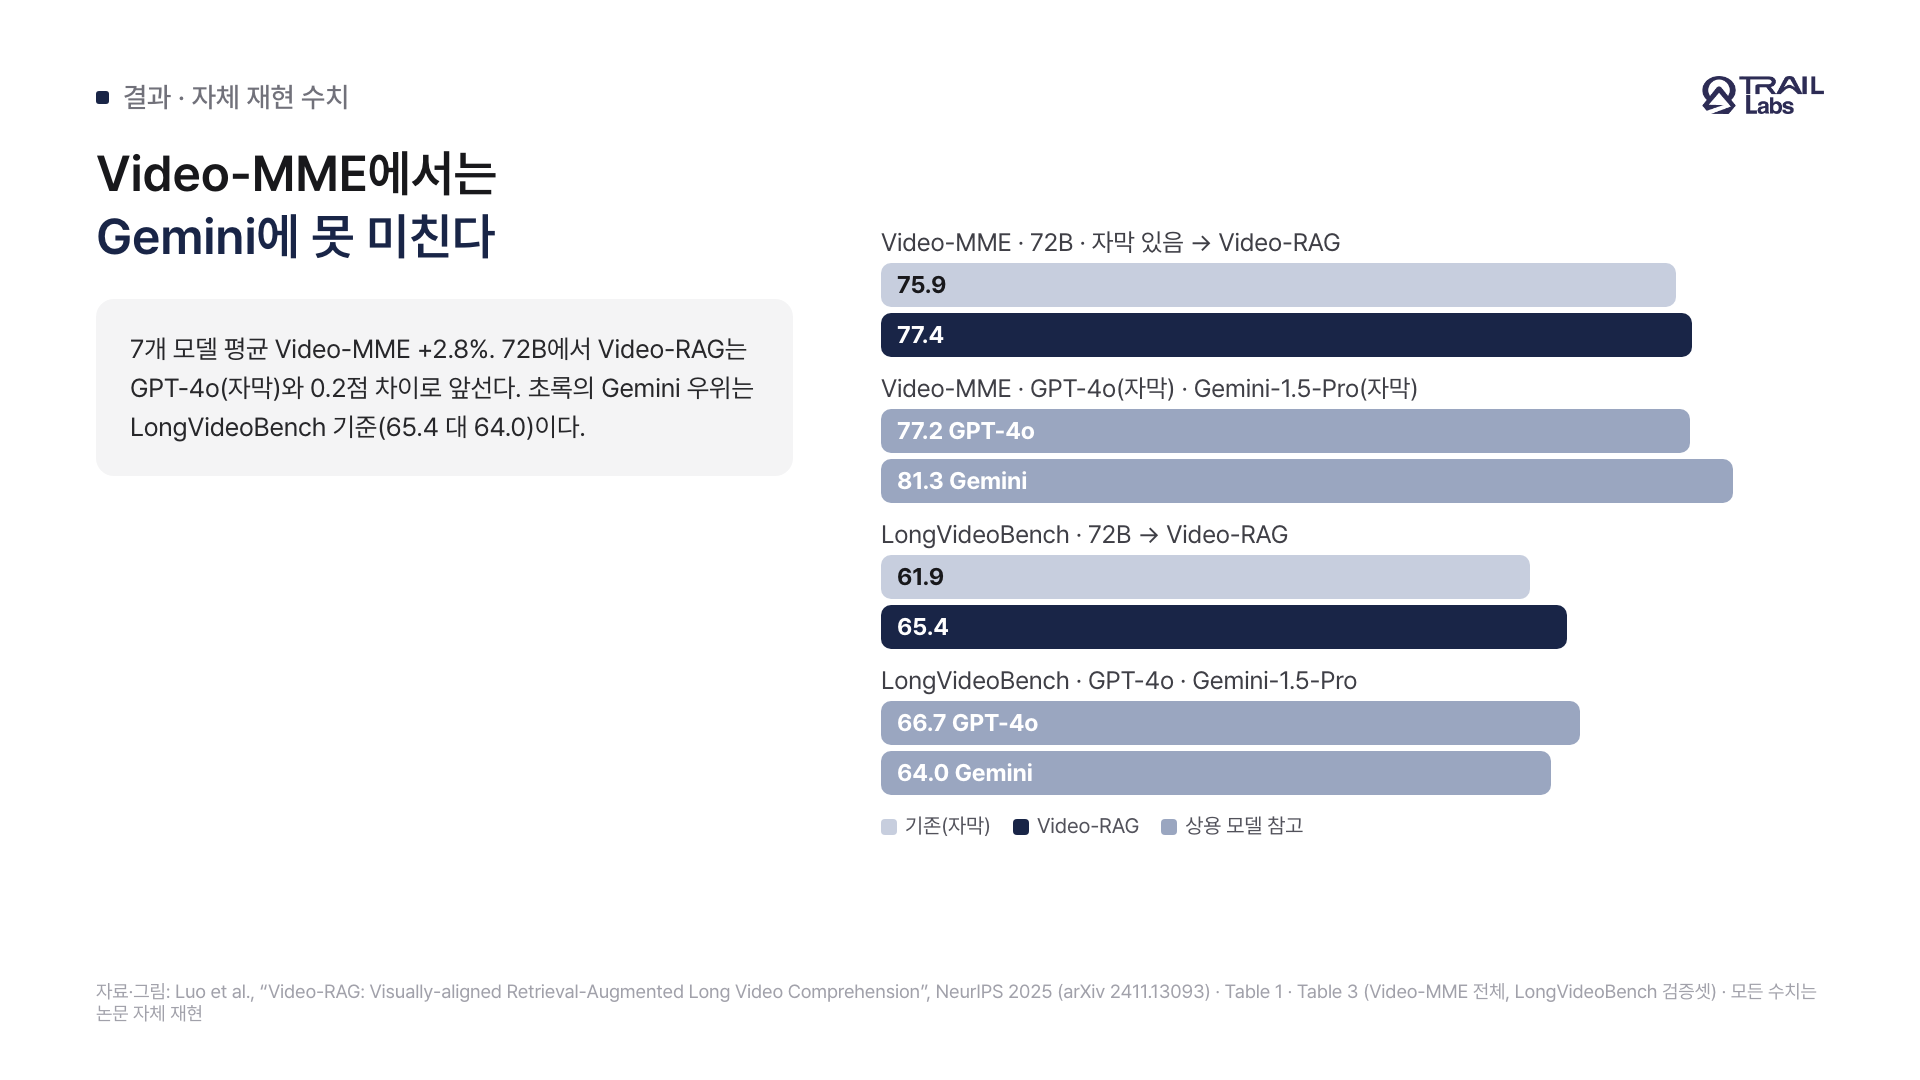
그림 2. 72B 모델에서 기존 기준과 Video-RAG를 비교한 결과예요. 상용 모델 수치는 논문이 인용한 값이에요 [1].
초록은 72B 모델이 Gemini-1.5-Pro를 앞섰다고 써요. 그런데 Video-MME에서 Gemini는 자막 포함 81.3으로, Video-RAG의 77.4보다 높아요. 앞선 것은 LongVideoBench의 65.4 대 64.0이에요. 같은 표에서 GPT-4o(66.7)에는 못 미쳐요 [1]. 그래서 이 글은 벤치마크마다 기준을 나누어 읽어요.
OCR·음성 인식 텍스트는 성능을 얼마나 올리나요
구성 요소 실험은 Long-LLaVA 7B에 32프레임을 넣고 Video-MME에서 진행했어요 [1]. 보조 텍스트가 없으면 52.0이에요. 세 종류를 검색 없이 전부 붙이면 59.8이고, 검색을 거치면 62.1이에요. 검색으로 얻은 효과는 2.3점이에요. 논문은 음성 텍스트를 포함해 전반적인 개선이 있었고, 긴 영상에서 특히 도움이 되었다고 적어요 [1].
임계값 실험은 검색을 얼마나 엄격하게 할지에 따른 변화를 보여 줘요.
| 임계값 t | 보조 텍스트 토큰 | 점수 |
|---|---|---|
| 0.0 | 3.6K | 62.0 |
| 0.3 | 1.9K | 62.1 |
| 0.5 | 0.3K | 56.1 |
| 1.0 (텍스트 없음) | 0 | 52.0 |
표 2. 논문의 표 5에서 옮긴 값이에요 [1]. 임계값 0.3과 0.0의 점수 차이는 0.1점이지만, 토큰은 3.6K에서 1.9K로, 질의당 시간은 36초에서 11초로 줄어요.
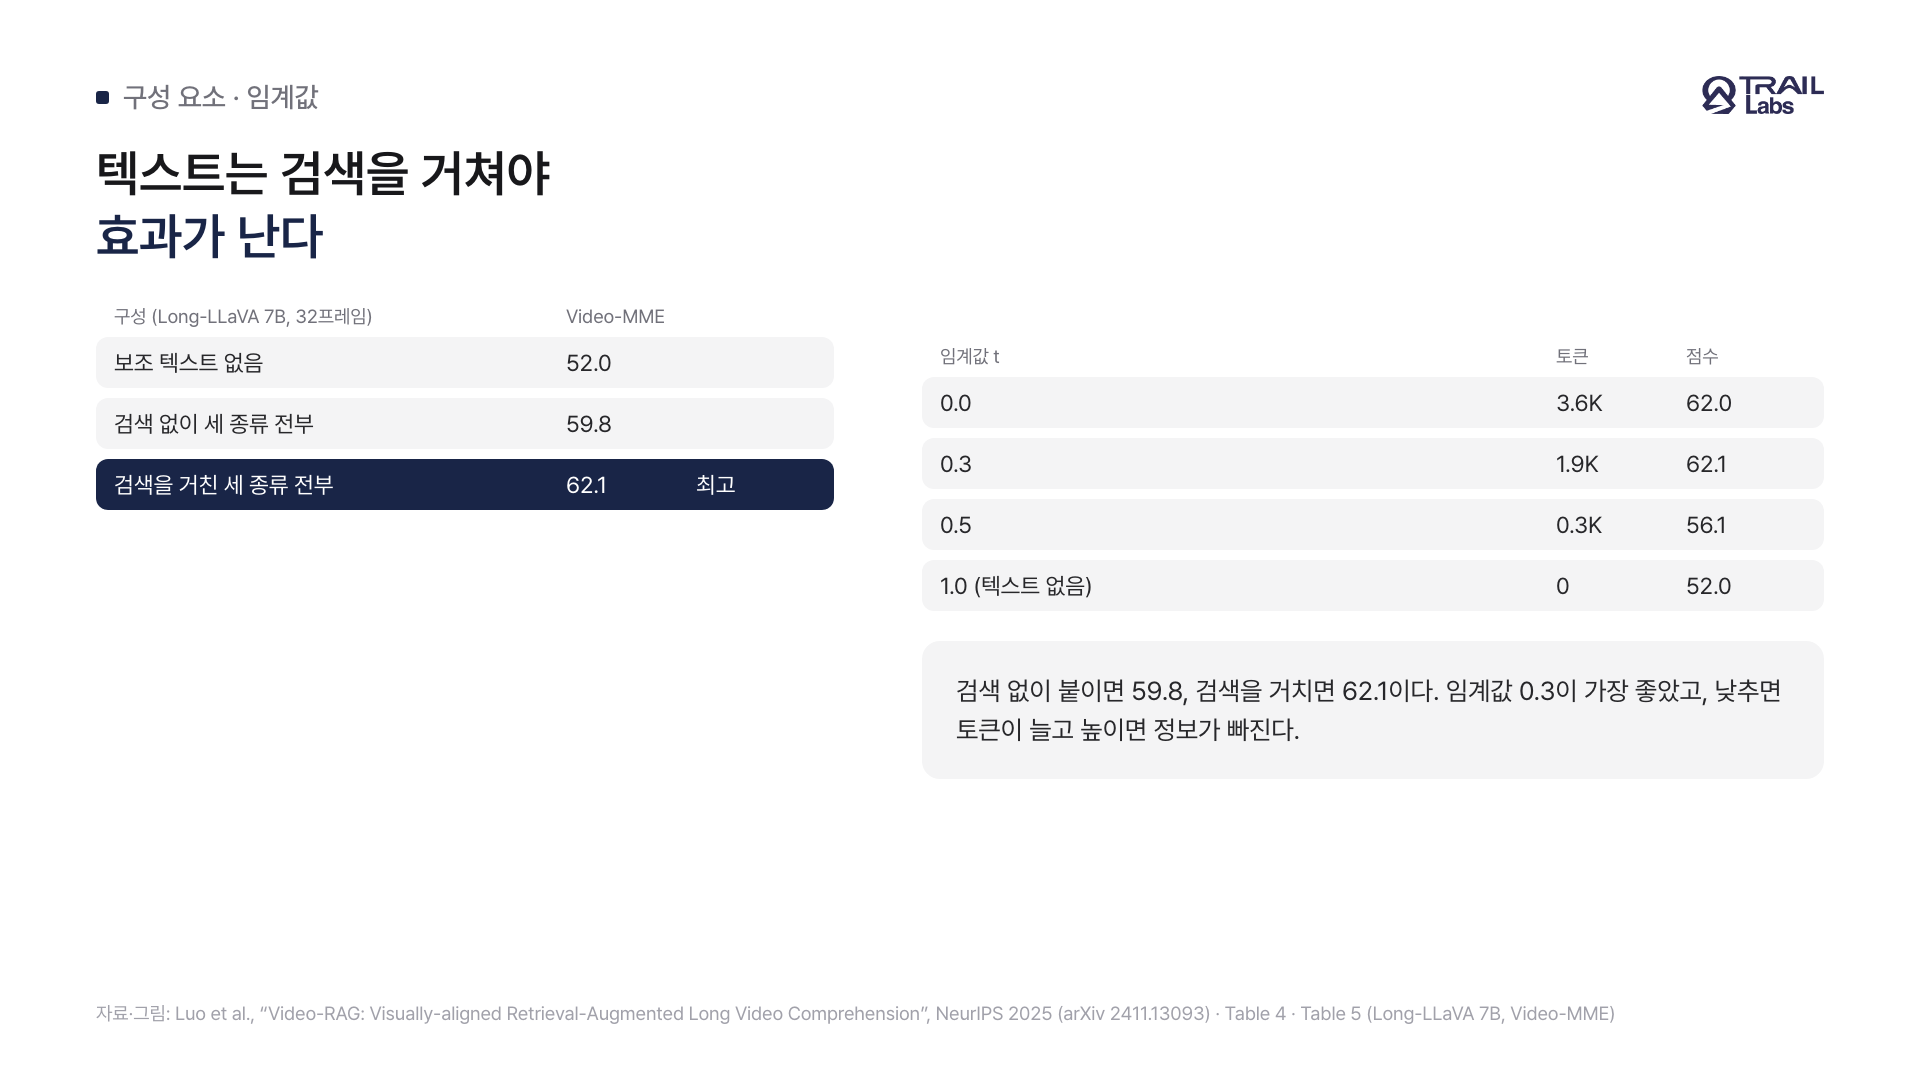
그림 3. 검색을 거친 텍스트가 검색 없이 붙인 텍스트보다 점수가 높았어요. 임계값은 0.3이 가장 좋았어요 [1].
비용도 보고되어 있어요. 7B 모델에 붙이면 추가 GPU 메모리 약 8GB와 질의당 약 5초가 들어요. 추가되는 보조 텍스트 약 2.0K 토큰은 프레임 약 14장 분량이에요 [1].
이 논문의 한계는 무엇인가요
논문에는 한계를 다루는 별도 절이 없어요. 본문 평가는 객관식 벤치마크 세 개이고, 부록의 VNBench는 합성 과제예요. 이 부록에서는 객체와 OCR 텍스트가 검색 성능을 높였지만, 음성 텍스트는 성능을 42.8에서 42.5로 낮췄어요 [1].
이 글에서 짚는 한계는 세 가지예요. 첫째, 질의 분해 단계는 프레임을 보지 않고 질문만으로 물체를 고르기 때문에, 질문에 언급되지 않은 물체는 검출되기 어려워요. 둘째, OCR, 음성 인식, 검출 도구의 오류가 그대로 모델 입력에 들어가요. 논문은 이 오류 전파를 분석하지 않았어요. 셋째, 오픈 모델 수치가 저자들의 재현 값이고 사람 평가는 없어요. 주관식 영상 질의응답에서 같은 효과가 나는지는 따로 확인해야 해요.
TRAIL에서는
TRAIL Studio에는 영상을 분석하는 기능이 있어요. 유튜브나 쇼츠 URL을 Gemini로 분석해 샷 단위 연출 구조를 뽑아요. 장면 자막을 SRT로 만드는 기능도 있어요. 다만 이 논문처럼 OCR과 음성을 텍스트로 뽑아 질문에 맞게 검색하는 구조는 없어요.
설계 아이디어는 우리 문제와 닿아 있어요. 보이는 것을 텍스트 속성으로 바꿔 두면 질문과 맞춰 찾을 수 있어요. 상품 사진과 상세페이지를 AI 검색이 읽을 수 있는 텍스트로 바꾸는 데도 같은 구조가 맞는지는 가설이에요. 아직 측정하지 않았어요.
긴 영상이 모델 문맥에 들어가지 않을 때 프레임을 늘리는 쪽과 텍스트를 붙이는 쪽 중 어디에 비용을 쓰시는지 궁금해요. 실제로 측정해 보신 결과가 있다면 특히 듣고 싶어요.
Yongdong Luo, Xiawu Zheng, Guilin Li, Shukang Yin, Haojia Lin, Chaoyou Fu, Jinfa Huang, Jiayi Ji, Fei Chao, Jiebo Luo, Rongrong Ji, "Video-RAG: Visually-aligned Retrieval-Augmented Long Video Comprehension", NeurIPS 2025 (arXiv 2411.13093).
#VideoRAG #RAG #긴영상 #멀티모달 #NeurIPS2025 #논문리뷰 #TRAILLabs
Frequently asked questions
긴 영상을 AI가 이해하게 하려면 프레임을 늘리면 되나요?
늘린다고 성능이 항상 오르지는 않아요. 이 논문은 LongVA가 Video-MME에서 프레임을 128개에서 384개로 늘렸을 때 52.6%에서 51.8%로 떨어졌다고 보고해요. 프레임이 많아지면 중복되는 정보가 늘고 복잡한 추론이 어려워진다는 설명이에요 [1][2].
Video-RAG는 무엇이고 어떻게 동작하나요?
영상에서 글자(OCR), 음성(ASR), 객체(검출) 정보를 텍스트로 뽑아 벡터 데이터베이스에 넣고, 질문을 분해해 필요한 텍스트만 검색해요. 검색된 텍스트는 시간순으로 프레임과 함께 기존 모델에 들어가요. 모델 자체는 학습하지 않아요 [1].
영상 질의응답에 OCR과 음성 인식을 붙이면 성능이 오르나요?
논문의 구성 요소 실험에서 Long-LLaVA 7B는 보조 텍스트가 없을 때 Video-MME 52.0을 받았어요. 세 종류를 검색 없이 붙이면 59.8, 검색을 거치면 62.1이었어요. 다만 이 수치는 저자들의 재현 값이며, 다른 모델과 과제에서는 따로 확인해야 해요 [1].
학습 없이 영상 이해 성능을 올리는 방법이 있나요?
Video-RAG는 학습 없이 기존 모델 앞에 붙이는 방식이에요. 저자들은 7B 모델에 GPU 메모리를 약 8GB 더 쓰고 질의당 약 5초가 늘어난다고 적었어요. 같은 Video-MME 전체를 VideoAgent 방식의 GPT 에이전트로 돌리는 데는 약 20일과 약 2,000달러의 API 비용이 든다고 비교해요 [1][3].
References
- [1]Yongdong Luo, Xiawu Zheng et al., "Video-RAG: Visually-aligned Retrieval-Augmented Long Video Comprehension", NeurIPS 2025 (arXiv 2411.13093)
- [2]Chaoyou Fu et al., "Video-MME: The First-Ever Comprehensive Evaluation Benchmark of Multi-modal LLMs in Video Analysis", 2024
- [3]Yue Fan et al., "VideoAgent: A Memory-augmented Multimodal Agent for Video Understanding", ECCV 2024 (arXiv 2403.11481)
- [4]Gautier Izacard et al., "Unsupervised Dense Information Retrieval with Contrastive Learning" (Contriever), 2021
Summary
- 긴 영상에서 프레임을 늘리는 방식은 LongVA의 Video-MME 점수를 오히려 낮춘 사례가 보고되었어요.
- Video-RAG는 영상의 글자(OCR), 음성(ASR), 객체(검출)를 텍스트로 뽑아 질문에 맞게 검색하고, 학습 없이 기존 대형 영상-언어 모델에 붙여요.
- 자막 포함 기준으로 72B 모델의 Video-MME 점수는 75.9에서 77.4로, LongVideoBench 점수는 61.9에서 65.4로 올랐어요. 오픈 모델 수치는 저자들의 재현 값이에요.
- Video-MME에서는 자막을 포함한 Gemini-1.5-Pro(81.3)가 77.4보다 높아요. 초록의 우위 주장은 LongVideoBench 기준으로만 성립해요.
- 검색 없이 텍스트를 붙이면 59.8, 검색을 거치면 62.1이었어요. 임계값 0.3이 가장 좋았어요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility