MMDocRAG, 멀티모달 문서 RAG 벤치마크에서 AI는 근거를 잘 고를까
그림과 표가 섞인 긴 문서에서 AI가 답의 근거를 고르게 했더니, 완벽 검색을 가정해도 최고 모델의 인용 선택 F1이 70.2%에 그쳤어요. NeurIPS 2025 벤치마크 읽기
그림과 표가 섞인 긴 문서에서 AI가 답의 근거를 고르게 했더니, 완벽 검색을 가정해도 최고 모델의 인용 선택 F1이 70.2%에 그쳤어요. 후보 20개 중 정답 조각은 중앙값 2개뿐이고, 텍스트 근거(52.0)가 이미지 근거(80.7)보다 더 어려웠어요 [1]. MMDocRAG는 NeurIPS 2025 Datasets & Benchmarks에 실린 벤치마크이고, 저자는 Huawei Noah's Ark Lab 연구진이에요 [1].
이 글은 arXiv 원문과 NeurIPS 카메라레디 본문, 표 1·2·3·5·6, 그림 8을 2026년 10월에 읽고 수치를 하나씩 대조해 정리했어요 [1]. 프로젝트 페이지에 데이터와 코드가 공개되어 있지만 [2] 직접 돌려 재현하지는 않았어요. 저자들과 이해관계는 없어요.
멀티모달 문서 RAG 벤치마크는 무엇을 재나요
기업 문서는 본문만 있지 않아요. 재무 표, 차트, 다이어그램이 섞여 있고, 한 질문의 답이 여러 쪽과 여러 형식에 흩어져 있어요. MMDocRAG는 이런 문서에서 AI가 두 가지를 하게 해요. 첫째, 질문에 맞는 근거 조각을 고르고(인용 선택), 둘째, 고른 조각으로 글과 이미지를 엮어 답을 써요(멀티모달 생성) [1].
벤치마크는 전문가가 주석한 QA 4,055개로, 개발용 2,055개와 평가용 2,000개로 나뉘어요. 질문은 222개의 긴 문서에 기반하고, 문서는 10개 유형에 평균 67쪽, 약 33,000단어예요. 답은 글과 이미지를 함께 엮는 형식을 허용해요 [1].
채점의 핵심은 후보 조각을 섞는 방식이에요. 각 질문에는 15개 또는 20개의 후보 조각이 주어지는데, 정답(gold) 조각은 중앙값 2개(평균 2.7)뿐이고 나머지는 하드 네거티브예요. 하드 네거티브는 질문이나 답과 글자·그림이 비슷해 헷갈리게 만든 가짜 근거로, 상위 검색 결과에서 골라 넣었어요. 그래서 "많은 후보 중 진짜 근거만 골라낼 수 있는가"를 F1으로 잴 수 있어요 [1].
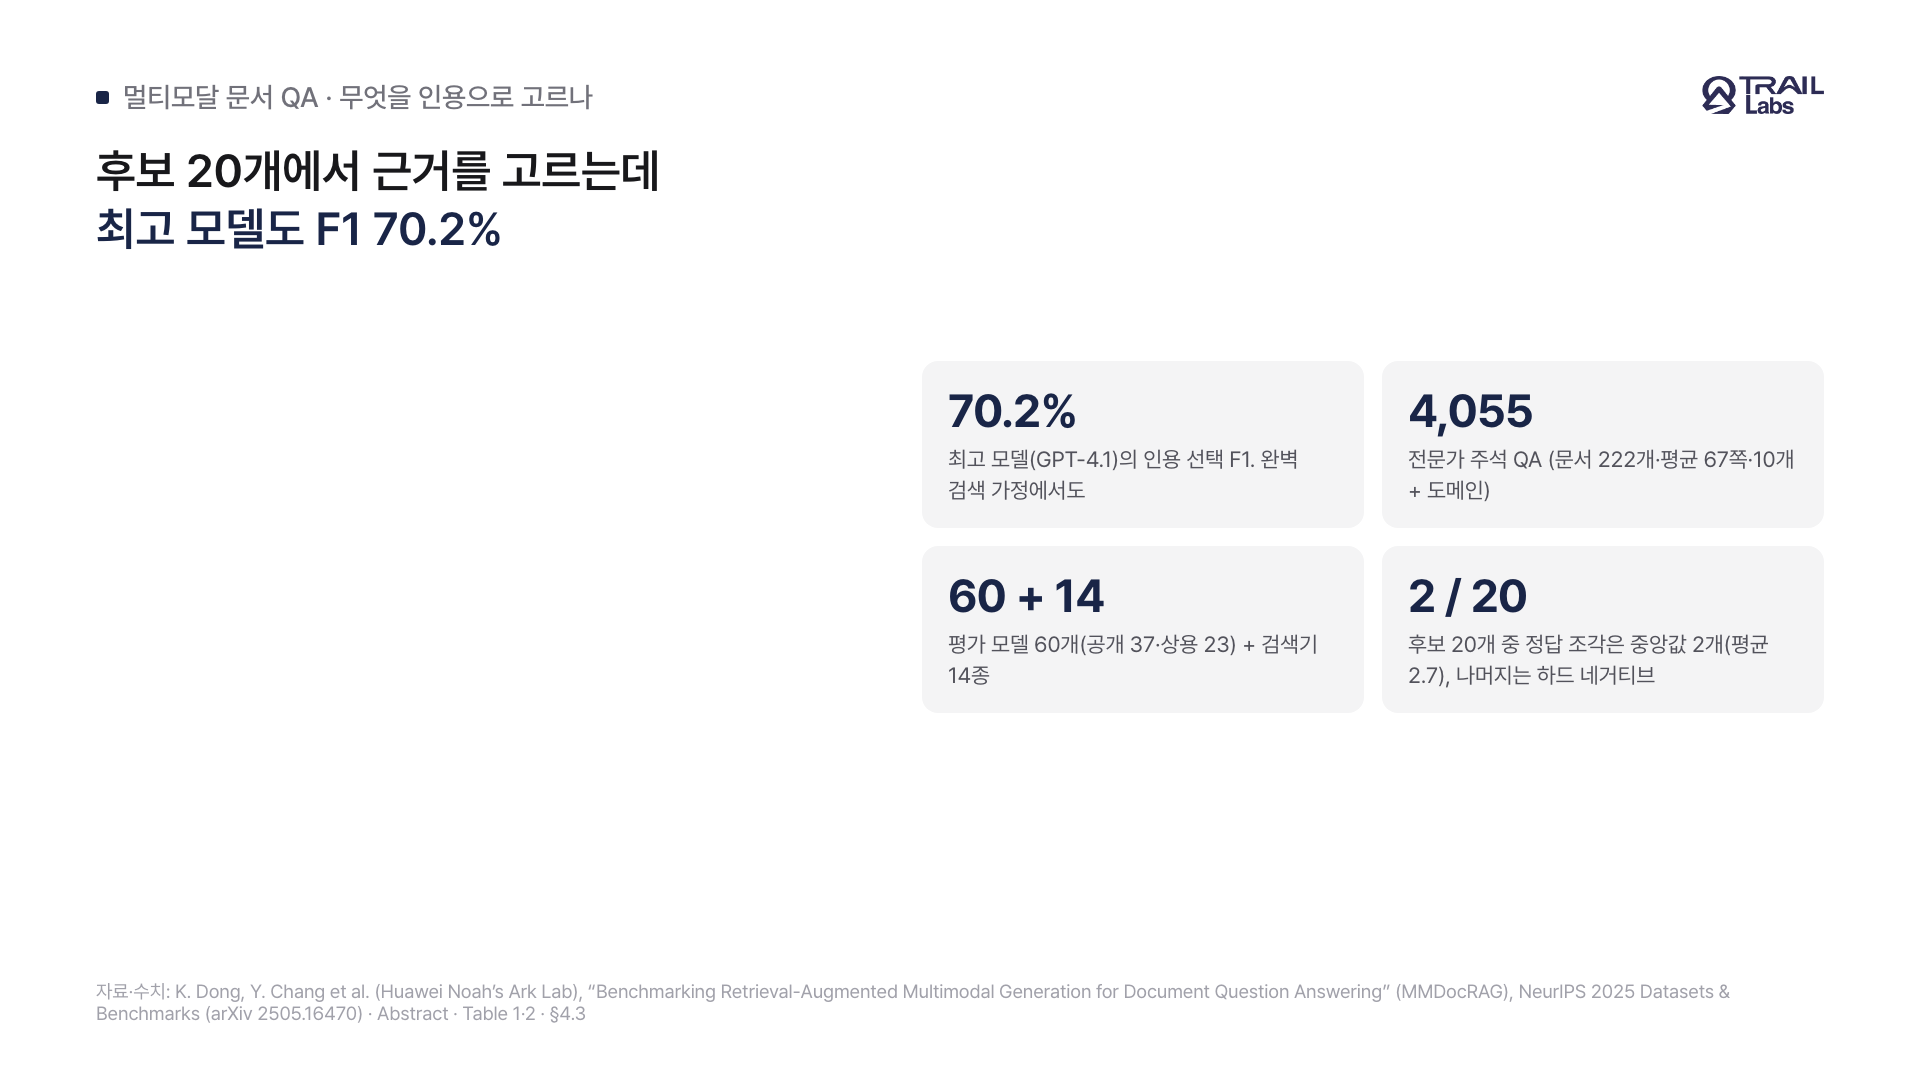
그림 1. MMDocRAG의 과제와 규모예요. 후보 20개에서 근거를 고르는데 완벽 검색을 가정해도 최고 모델의 F1이 70.2%에 그쳤어요 [1].
AI는 문서의 그림과 표에서 근거를 잘 고르나요
인용 선택부터 보면, 완벽 검색을 가정한 조건에서도 쉽지 않았어요. 검색 오류를 제거하려고 정답을 포함한 후보 조각을 고정으로 주고 선택만 재는데, 이 조건에서 최고 모델인 GPT-4.1의 선택 F1이 70.2%였어요. 저자들은 "최신 모델조차 70.2%에 그친다"고 적어요 [1].
유형별로 보면 차이가 커요. GPT-4.1은 텍스트 조각 선택 F1이 52.0, 이미지 조각이 80.7이었어요. 이미지 근거는 비교적 잘 고르는데 텍스트 근거를 더 못 골랐어요. 답 품질은 다섯 기준(유창성, 인용 품질, 글·이미지 일관성, 추론, 사실성)을 각각 채점해 평균 4.14점(5점 만점)으로 가장 높았어요 [1].
상용 모델과 공개 모델의 차이도 분명했어요. 논문은 상용 VLM이 공개 VLM·LLM을 크게 앞선다고 정리해요. 공개·소형 모델에서는 멀티모달 입력이 오히려 독이 됐어요. 같은 체급의 LLM이 동급 VLM보다 선택 F1이 높았는데, Qwen 계열에서 7B는 175.9%, 32B는 62.7% 더 높았어요. 작은 모델일수록 긴 멀티모달 입력을 버거워한다는 뜻이에요 [1].
문서 RAG에서 검색과 인용 선택 중 무엇이 병목인가요
지금까지는 정답을 포함한 완벽 검색을 가정했어요. 실제로는 검색기가 후보를 먼저 찾아 와야 하는데, 이 단계가 큰 병목이었어요. GPT-4.1로 끝까지 돌린 실험에서, 완벽 검색의 선택 F1 70.2가 기본 검색기(BGE)를 쓰면 54.4로 떨어졌어요. 질문을 여러 절로 확장하고 검색기 네 개(BGE, Qwen3-0.6B, BM25, E5)를 묶어 recall을 84.9%까지 올린 설정에서도 59.9에 머물렀어요 [1].
| 검색 조건 | 조각 검색 recall | 인용 선택 F1 | 답 품질(5점) |
|---|---|---|---|
| 완벽 검색 (오라클) | - | 70.2 | 4.14 |
| 기본 검색기 (BGE) | 71.0 | 54.4 | 3.53 |
| 검색기 4종 앙상블 + 질의 확장 | 84.9 | 59.9 | 3.79 |
표 1. 논문 표 6(GPT-4.1, 후보 20개)에서 옮긴 값이에요. recall을 85%까지 복구해도 선택과 답 품질이 완벽 검색에 못 미쳤어요 [1].
형식별 검색 난이도도 갈렸어요. 텍스트 조각 검색 recall은 설정에 따라 34.6–49.5%였는데, 이미지 조각은 77.8–86.8%로 훨씬 높았어요. 텍스트 근거가 검색에서도, 선택에서도 더 어려운 쪽이었어요 [1].
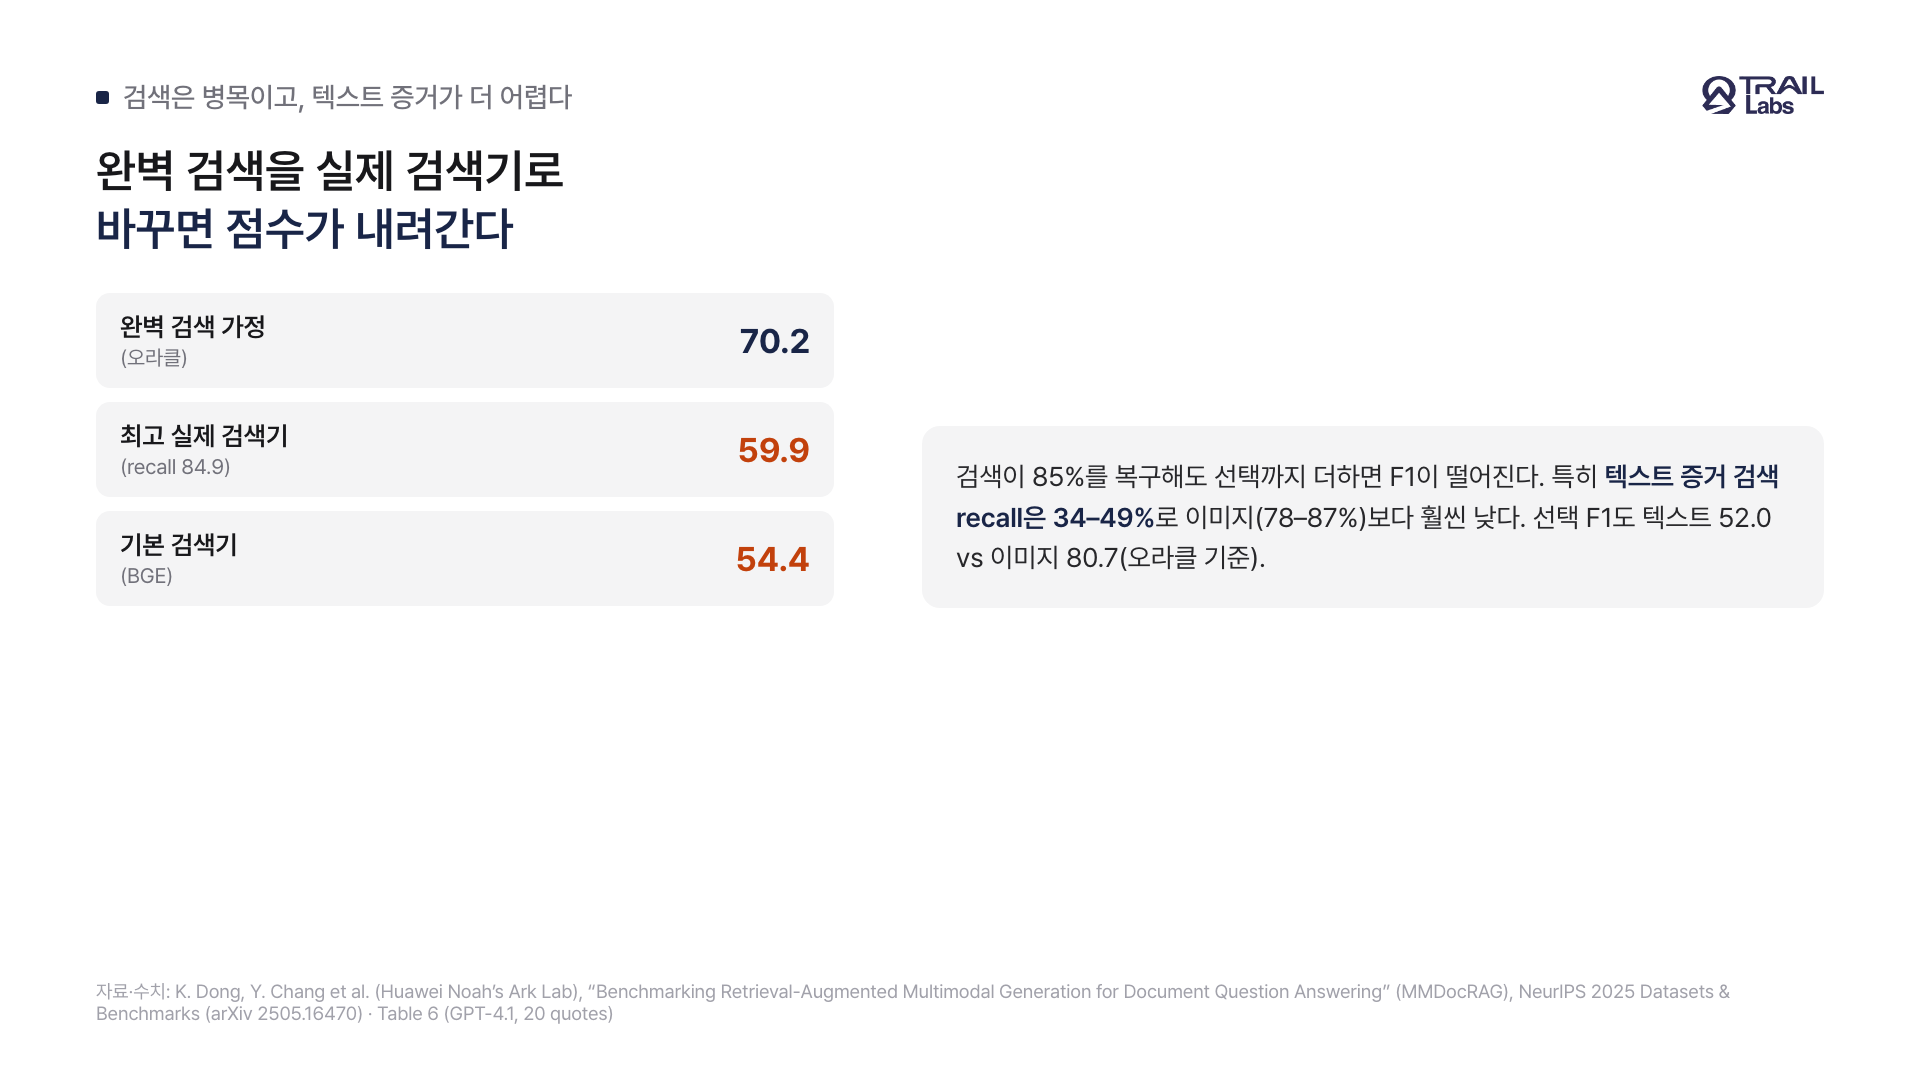
그림 2. 완벽 검색을 실제 검색기로 바꾸면 점수가 내려가요. 텍스트 조각 검색 recall(34–49%)이 이미지(78–87%)보다 낮아 검색이 병목이었어요 [1].
이미지를 OCR 텍스트와 VLM 설명 중 어느 쪽으로 주면 더 잘 쓰나요
문서의 이미지를 모델에 넘기는 방법은 두 가지예요. OCR로 글자를 뽑아 주거나, VLM(시각-언어 모델)이 그림을 설명한 텍스트로 바꿔 주는 거예요. 둘을 비교했더니 VLM 설명 텍스트가 더 나았어요. 인용 선택 F1이 평균 OCR 텍스트 59.8에서 VLM 설명 텍스트 66.3으로 올랐어요 [1].
이유는 길이와 정보량에 있었어요. VLM 설명은 OCR보다 표에서 0.5배, 그림에서 2.8배 길었어요. OCR은 그림 속 배치나 관계를 놓치기 쉬운데, VLM 설명은 그런 멀티모달 정보를 더 담았다는 거예요 [1].
위치도 선택에 영향을 줬어요. MMDocRAG는 정답 조각을 후보 안에 고르게 섞어 두는데도, Lost in the Middle에서 보고된 경향처럼 모델은 앞쪽 근거를 더 많이 골랐어요. 정답 조각이 첫 위치에 있을 때 선택 확률이 가장 높았고, 뒤로 갈수록 떨어졌어요. 특히 이미지 조각에서 이 경향이 컸어요 [1][3].
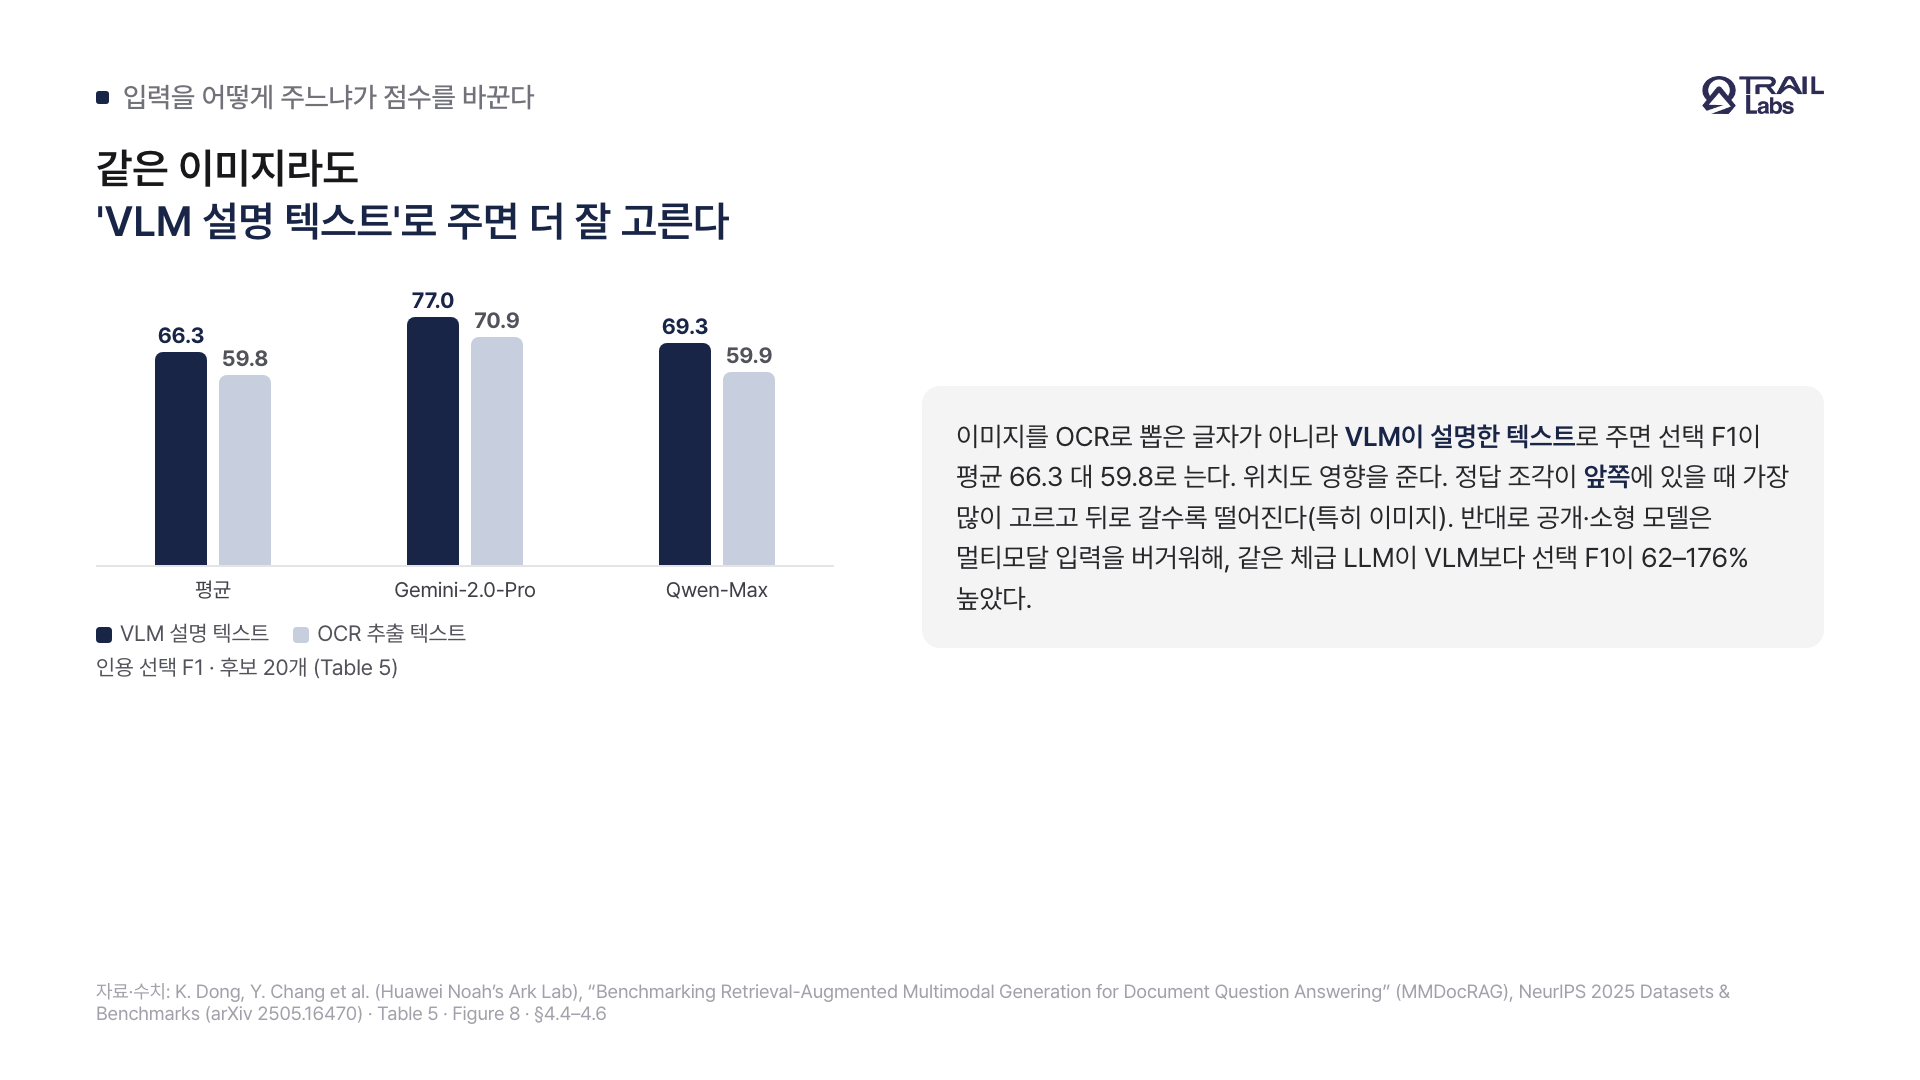
그림 3. 같은 이미지를 OCR 글자 대신 VLM 설명 텍스트로 주면 선택 F1이 올랐어요(평균 59.8 대 66.3) [1].
실험은 어떻게 설계했나요
평가 대상은 넓어요. 상용 23개와 공개 37개를 합친 60개 모델에, MMDocRAG 개발셋으로 미세조정한 9개를 더했어요. 검색기는 텍스트 6종, 시각 4종, 하이브리드 4종으로 14종을 비교했어요 [1].
채점은 두 축이에요. 인용 선택은 고른 조각과 정답 조각을 맞춰 F1으로 재고, 답 품질은 다섯 기준을 각각 LLM 심사로 채점해요. 조각 후보는 15개와 20개 두 설정으로 실험했고, 후보 20개는 평균 약 3.6K 토큰이에요. 하드 네거티브는 질문 또는 답과 유사도가 높은 가짜 근거를 상위 검색 결과에서 골라 넣었어요 [1].
이 벤치마크의 한계는 무엇인가요
이 글에서 함께 짚을 점은 세 가지예요. 첫째, 답 품질을 LLM 심사로 채점하는 부분은 자동 지표의 한계를 가져요. 저자들도 자동 지표를 넘어서는 세밀한 평가를 노렸다고 적지만, 심사 모델의 편향은 남아요. 둘째, 문서 222개는 10개 유형을 다루지만 특정 언어·도메인에 치우쳤는지는 원문에서 분포를 더 봐야 해요. 셋째, 하드 네거티브를 상위 검색 결과에서 고르는 방식은 현재 검색기의 특성을 반영하므로, 검색기가 바뀌면 난이도도 달라질 수 있어요. 벤치마크는 특정 시점의 어려움을 재는 자료로 읽는 게 맞아요 [1].
TRAIL에서는
이 논문의 결론은 우리가 AEO/GEO에서 다루는 문제와 닿아 있어요. "완벽 검색을 가정해도 선택이 어렵다"는 건, 근거를 잘 찾아 넣는 것만으로는 부족하고, AI가 그 근거를 실제로 고르게 만드는 표현이 중요하다는 뜻이에요.
특히 "이미지를 OCR 글자가 아니라 VLM이 설명한 텍스트로 주면 더 잘 고른다"는 결과가 눈에 띄어요. TRAIL Search는 브랜드 페이지가 AI 검색에 인용되는지를 진단하는데, 그림과 표로만 담긴 정보는 AI가 읽기 어렵다는 가설과 같은 방향이에요. 상품 사진과 상세페이지의 시각 정보를 AI가 읽을 수 있는 텍스트 속성으로 바꾸는 게 인용 가능성을 높이는지는 우리가 측정해야 할 몫이에요. 아직 수치로 확인하지는 않았어요.
여러 형식이 섞인 문서를 AI 검색에 올리실 때, 그림·표의 정보를 텍스트로 풀어 두는 쪽과 이미지 그대로 두는 쪽 중 어디가 더 인용되던가요. 실제로 비교해 보신 결과가 있다면 듣고 싶어요.
Kuicai Dong, Yujing Chang, Shijie Huang, Yasheng Wang, Ruiming Tang, Yong Liu, "Benchmarking Retrieval-Augmented Multimodal Generation for Document Question Answering" (MMDocRAG), NeurIPS 2025 Datasets & Benchmarks (arXiv 2505.16470).
#MMDocRAG #멀티모달RAG #문서질의응답 #DocVQA #NeurIPS2025 #논문리뷰 #TRAILLabs
Frequently asked questions
멀티모달 문서 RAG 벤치마크는 무엇을 재나요?
MMDocRAG는 그림·표·본문이 섞인 긴 문서에서 AI가 질문의 근거 조각을 고르고, 글과 이미지를 엮어 답하는 능력을 재요. 전문가가 주석한 QA 4,055개로, 후보 조각 중 정답(gold)과 하드 네거티브를 섞어 '무엇을 인용으로 고르는가'를 F1으로 채점해요 [1].
AI는 문서의 그림과 표에서 근거를 잘 고르나요?
완벽 검색을 가정해도 어려워요. 후보 20개에서 근거를 고를 때 최고 모델인 GPT-4.1의 인용 선택 F1은 70.2%였어요. 텍스트 조각 52.0, 이미지 조각 80.7로, 텍스트 근거를 더 못 골랐어요 [1].
문서 RAG에서 검색과 인용 선택 중 무엇이 병목인가요?
둘 다인데, 검색이 큰 병목이에요. 완벽 검색 가정의 선택 F1 70.2가 실제 검색기를 쓰면 54.4(BGE)까지 떨어졌어요. 특히 텍스트 조각 검색 recall은 34–49%로 이미지(78–87%)보다 훨씬 낮았어요 [1].
이미지를 OCR 텍스트와 VLM 설명 중 어느 쪽으로 주면 AI가 더 잘 쓰나요?
VLM이 설명한 텍스트가 더 나았어요. 인용 선택 F1이 평균 OCR 텍스트 59.8에서 VLM 설명 텍스트 66.3으로 올랐어요. VLM 설명은 표에서 0.5배, 그림에서 2.8배 길어 더 많은 정보를 담았어요 [1].
References
- [1]Kuicai Dong, Yujing Chang, Shijie Huang, Yasheng Wang, Ruiming Tang, Yong Liu (Huawei Noah's Ark Lab), "Benchmarking Retrieval-Augmented Multimodal Generation for Document Question Answering" (MMDocRAG), NeurIPS 2025 Datasets & Benchmarks (arXiv 2505.16470)
- [2]MMDocRAG 프로젝트 페이지
- [3]Nelson F. Liu et al., "Lost in the Middle: How Language Models Use Long Contexts", TACL 2024
Summary
- MMDocRAG는 그림·표·본문이 섞인 긴 문서(222개, 평균 67쪽)에서 멀티모달 RAG를 재는 NeurIPS 2025 벤치마크로, 전문가 주석 QA 4,055개를 담아요.
- 후보 20개에서 근거를 고르는 인용 선택에서 완벽 검색을 가정해도 최고 모델(GPT-4.1) F1이 70.2%, 텍스트 근거(52.0)가 이미지(80.7)보다 어려웠어요.
- 완벽 검색을 실제 검색기로 바꾸면 F1이 54.4까지 떨어졌어요. 텍스트 조각 검색 recall이 이미지보다 크게 낮아 검색이 병목이었어요.
- 이미지를 OCR 글자 대신 VLM이 설명한 텍스트로 주면 선택 F1이 평균 59.8에서 66.3으로 올랐고, 앞쪽에 놓인 근거를 더 많이 골랐어요.
- 공개·소형 모델은 멀티모달 입력에서 점수가 급락해, 같은 체급 LLM이 VLM보다 선택 F1이 더 높았어요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility