에이전트 메모리는 원본 대화를 그대로 검색하는 RAG보다 나을까
LLM이 대화를 미리 요약·재구성해 두는 메모리 시스템 11종 상당수가, 원본을 그대로 두고 질문 때 검색하는 RAG보다 정확도가 낮았어요. 요약 과정에서 숫자가 빠지고, 남은 정보도 찾기 어려워졌어요. 메모리의 득실을 질문 단위로 나눠 잰 2026년 arXiv 논문 읽기
LLM이 대화를 미리 요약하고 재구성해 두는 에이전트 메모리 시스템 11종 상당수가, 원본 대화를 그대로 두고 질문이 들어올 때 검색하는 RAG보다 정확도가 낮았어요. 벤치마크 3개와 모델 3개를 곱한 99개 조건 가운데 두 번 검색하는 RAG를 넘은 조건은 9개였어요 [1]. 일리노이대 어배너-섐페인(UIUC)과 칭화대 등 다섯 기관 연구진이 2026년 10월 25일 arXiv에 올린 논문이에요. 동료 심사 전 단계이고, 데이터 마이닝 분야의 Jiawei Han과 정보 검색 분야의 ChengXiang Zhai가 저자에 있어요 [1].
이 글은 arXiv 원문 v1의 본문과 표 1·2·4·19, 부록 사례 그림을 2026년 10월에 읽고 수치를 하나씩 대조해 정리했어요 [1]. 논문은 Hugging Face 논문 페이지에도 올라와 있고, 저자가 공개하겠다고 한 코드는 아직 돌려 보지 않았어요. 99개 조건 중 9개라는 숫자는 표 1의 칸을 직접 센 값이에요. 저자와 이해관계는 없어요.
에이전트 메모리가 RAG보다 나은가요
이 논문의 실험에서는 대체로 낫지 않았어요. 연구진은 메모리를 저장 방식에 따라 네 묶음으로 나눴어요. 평평한 저장소(A-Mem, SimpleMem, MemOS), 계층·수명 주기형(MemoryOS, LightMem, 볼케엔진의 OpenViking), 그래프형(HippoRAG2, PlugMem, MAGMA), 학습된 정책형(Mem-T, Memory-R2)이에요 [1]. 비교 기준은 원본 대화를 청크로 잘라 BM25와 임베딩 검색으로 함께 찾고 재순위를 매기는 단순 RAG예요. 한 번 검색하는 RAG(1rd)와, 모델이 첫 검색 결과가 충분한지 판단해 부족하면 후속 검색어로 한 번 더 찾는 RAG(2rd)를 같이 뒀어요 [1].
공정성을 위해 검색 범위도 맞췄어요. 시스템마다 메모리 단위 크기가 달라 같은 top-k라도 모델이 보는 정보량이 달라지기 때문에, 저자들은 모델에 노출된 토큰 비율(Retrieval Scope)이 1회 검색 RAG보다 낮지 않도록 시스템별 top-k를 늘렸어요 [1].
| 시스템 (LongMemEval-s, GPT-5.6 Luna) | 정확도 | 메모리 구축 시간 | 총 토큰 | LLM 호출 |
|---|---|---|---|---|
| RAG (2회 검색) | 90.0% | 0.11시간(색인) | 0.65M | 약 200회 |
| RAG (1회 검색) | 82.0% | 0.11시간(색인) | 0.27M | 약 100회 |
| A-Mem (평평한 저장소) | 84.0% | 117.0시간 | 174.7M | 약 9만 8천 회 |
| MemoryOS (계층형) | 80.0% | 126.5시간 | 71.9M | 약 10만 4천 회 |
| MAGMA (그래프형) | 76.0% | 103.2시간 | 80.6M | 약 9만 8천 회 |
| OpenViking (계층형) | 63.0% | 24.9시간 | 71.9M | 약 1만 1천 회 |
표 1. LongMemEval-s 대화 100개 합계 기준 정확도와 비용이에요. 총 토큰은 구축·유지·추론 토큰의 합이에요(논문 표 19에서 계산) [1].
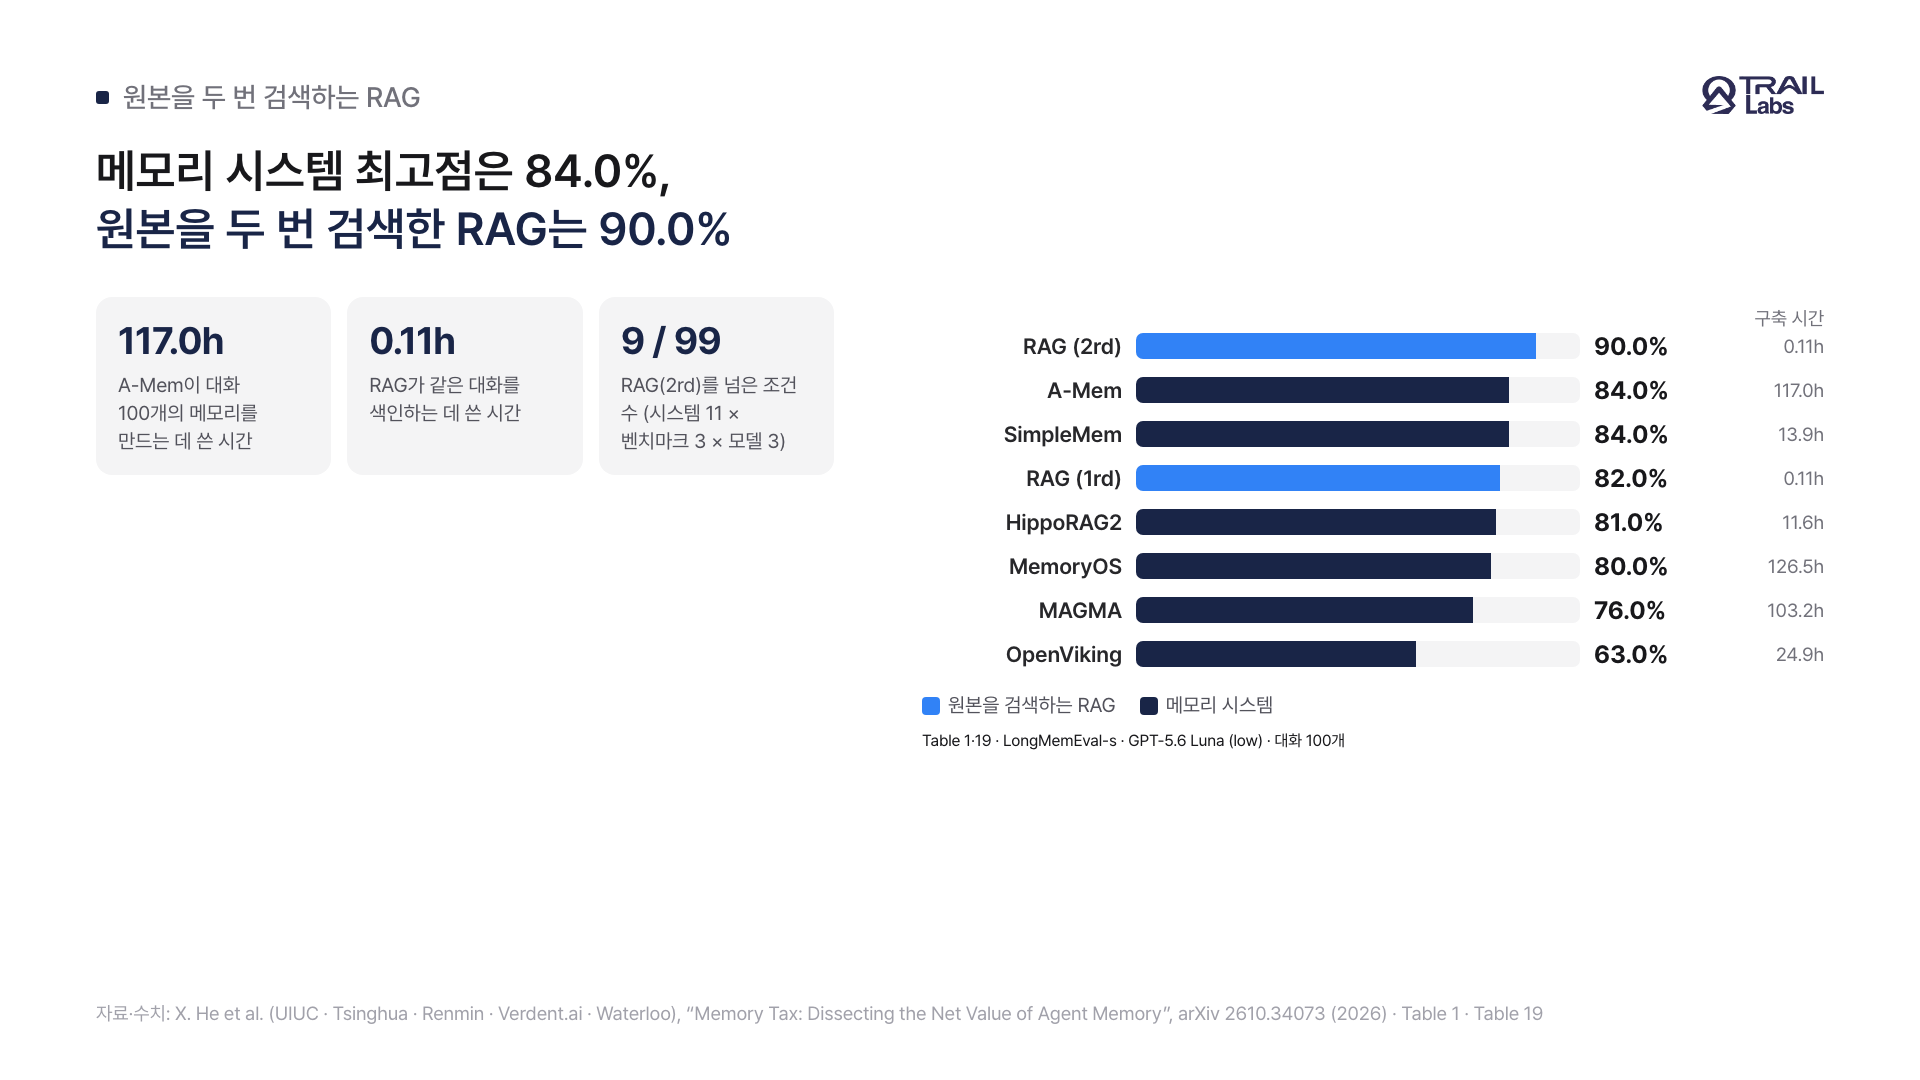
그림 1. 메모리 시스템 중 가장 높은 점수는 84.0%로, 두 번 검색하는 RAG(90.0%)보다 6점 낮았어요 [1].
LongMemEval은 사용자와 어시스턴트의 긴 대화 기록을 주고 그 안의 사실을 묻는 벤치마크이고, s는 대화가 짧은 판이에요. 여기서 1회 검색 RAG(82.0%)를 넘은 메모리는 A-Mem과 SimpleMem(둘 다 84.0%) 둘이었어요. 두 번 검색하는 RAG를 넘은 메모리는 없었어요 [1]. 다른 두 벤치마크(PersonaMem-v2, MINT-Eval)에서는 RAG를 소폭 넘은 조건이 몇 개 있었고, 그게 99개 중 9개예요.
에이전트 메모리 구축 비용은 얼마나 드나요
메모리를 미리 만드는 시스템은 질문이 오기 전에 대화 전체를 LLM으로 처리하느라 비용이 커졌어요. 표 1에서 A-Mem은 대화 100개의 메모리를 만드는 데 117.0시간과 LLM 호출 약 9만 8천 회를 썼어요. MemoryOS는 126.5시간, MAGMA는 103.2시간이었어요 [1]. 두 번 검색하는 RAG는 같은 대화를 색인하는 데 0.11시간, 질문에 답하는 데 7.7분을 썼고 총 토큰은 0.65M이었어요 [1].
비용이 시간에만 드는 것도 아니에요. 메모리를 만드는 모델과 쓰는 모델이 같은 회사의 같은 버전이라는 보장이 없어요. 저자들은 메모리를 한 모델로 만들고 답은 더 작은 모델로 하게 바꿔 봤는데, 여러 메모리 시스템에서 정확도 하락 폭이 RAG보다 컸어요 [1]. 메모리 구축과 해석이 모두 LLM 판단에 기대고 있어서, 모델이 바뀌면 흔들릴 지점이 하나 더 생기는 구조예요.
메모리의 순가치는 어떻게 재나요
메모리가 RAG보다 얼마나 나은지는 질문 단위로 득과 실을 나눠 쟀어요. 저자들은 메모리 시스템과 1회 검색 RAG를 같은 질문에 돌려, 메모리만 맞힌 질문을 메모리 이득(memory benefit), RAG만 맞힌 질문을 메모리 세금(memory tax)이라고 불렀어요 [1].
여기서 는 메모리의 순가치, 는 전체 질문 중 메모리 이득 비율, 는 메모리 세금 비율이에요. 흩어진 사실을 묶거나 선호를 정리해 RAG가 놓친 질문을 맞히면 가 커지고, 요약 과정에서 단서가 사라져 RAG가 쉽게 맞히던 질문을 틀리면 가 커져요. 많은 시스템에서 가 보다 커서 순가치가 음수였어요 [1].
이 식이 쓸모 있는 이유는 평균 정확도가 가리는 걸 드러내기 때문이에요. 두 시스템의 정확도가 같아도, 한쪽은 RAG와 같은 질문을 맞히고 다른 쪽은 서로 다른 질문을 맞힐 수 있어요. 저자들은 메모리 이득이 설계 의도대로 나오는 부분이라 보고, 덜 다뤄진 세금이 어디서 생기는지를 충실도·접근성·강건성 세 축으로 추적했어요 [1].
LLM이 대화를 요약해 저장하면 무엇을 잃나요
가장 먼저 빠지는 건 구체적인 숫자와 조건이었어요. 저자들은 원본 대화에서 사실을 표본으로 뽑아 각 사실이 메모리 단위에 어떻게 남았는지 손실 없음·부분 손실·큰 손실·메모리 단위 없음으로 표시했어요. OpenViking은 뽑은 사실의 38.0%를 아예 저장하지 않았고 13.0%를 크게 훼손했어요. 손실 없이 남은 사실은 39.4%였어요 [1].
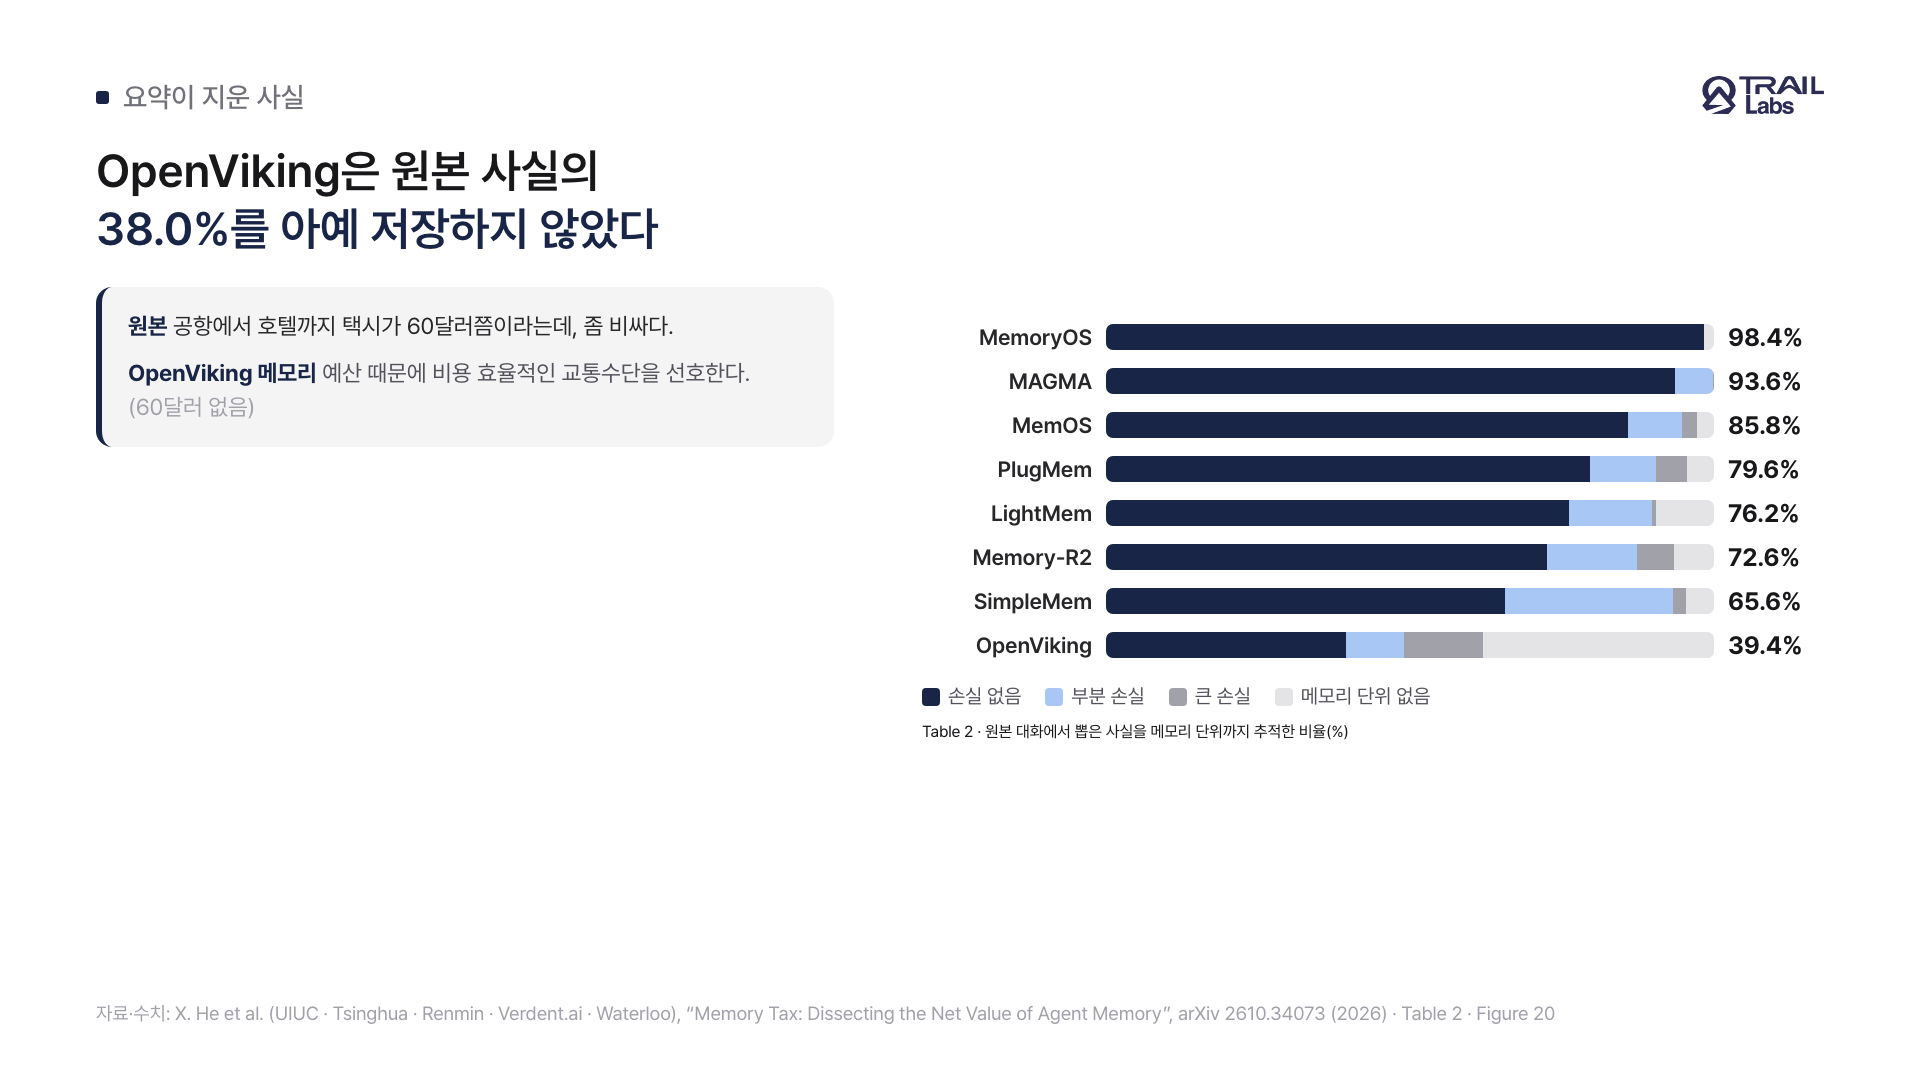
그림 2. 원본 사실이 손실 없이 남은 비율은 MemoryOS 98.4%부터 OpenViking 39.4%까지 시스템마다 크게 갈렸어요(표 2) [1].
부록 사례는 손실이 어떤 모양인지 보여 줘요. 사용자가 "공항에서 호텔까지 택시가 60달러쯤이라는데 좀 비싸다"고 말하자, OpenViking은 이를 "예산 때문에 비용 효율적인 교통수단을 선호한다"로 저장했어요. 나중에 "기차를 타면 얼마나 아끼나"를 물으면 60달러가 없어 답할 수 없어요 [1]. SimpleMem은 "노트북 가방이 1월 20일에 도착했다"는 말을 "1월 20일부터 쓰기 시작했다"로 바꿔 적었어요. 도착까지 며칠 걸렸냐는 질문의 근거가 바뀐 셈이에요 [1].
삭제 요청에서도 사고가 났어요. 사용자가 "결혼 압박에 관한 이야기는 잊어 달라"고 하자, SimpleMem은 그 요청을 같은 내용에 대한 새 사실로 저장했고 PlugMem은 요청은 버리고 잊어야 할 내용만 남겼어요 [1]. 요약형 메모리에서 지우기가 생각보다 어렵다는 걸 보여 주는 장면이에요.
정보가 남아 있어도 왜 못 찾나요
남은 정보도 쪼개지거나 섞이거나 바뀌어 적히면 검색에서 늦게 나왔어요. 자전거 관련 지출 총액을 묻는 사례에서 원본은 "4월 20일 정비 때 체인 교체 25달러, 라이트 설치 40달러"라는 한 문단이었어요. PlugMem은 이걸 세 개의 메모리 단위로 나눴고, 합계에 필요한 25달러 단위는 네 번째 검색 라운드에서야 돌아왔어요 [1].
저자들은 이걸 넓게 확인하려고 질문과 원본 대화 사이의 유사도, 질문과 해당 메모리 단위 사이의 유사도를 비교했어요. 메모리를 만들면서 같은 근거와 질문 사이의 유사도 분포가 옮겨 갔고, 여러 시스템이 첫 검색 라운드에서 RAG보다 적은 질문의 근거를 다 찾았어요 [1]. 근거를 다 넣어 준 정답 메모리 조건에서는 MAGMA와 LightMem 점수가 원본 정답 조건에 가까웠어요. 정보는 남아 있었고, 찾기가 어려웠다는 뜻이에요 [1].
앞서 읽은 RAG 검색 병목 논문은 원본 문서를 청크로 자를 때 근거가 흩어지는 문제를 다뤘어요. 이 논문은 같은 문제가 LLM 요약 단계에서 한 번 더 일어난다는 걸 보여 줘요.
벤치마크가 RAG에 유리한 건 아닌가요
저자들도 그 가능성을 직접 다뤘고, 일부 벤치마크가 검색에 유리하다고 인정했어요. 메모리 없이, 드문 키워드만 맞추는 IDF 키워드 방식, 임베딩 RAG, 하이브리드 RAG를 장기 기억 벤치마크 여러 개에 돌리자, 아주 단순한 키워드 방식이 일부 벤치마크에서 50%를 넘었고 하이브리드 RAG는 약 70%에 이르렀어요 [1]. 단순 검색으로 이미 풀리는 질문이 많으면 메모리가 더 얻을 여지가 적고, 작은 손실이 점수에 그대로 드러나요.
그렇다고 결과가 벤치마크 탓으로만 정리되지는 않아요. 실제 사용자 질문 상당수도 "그때 말한 그 숫자"를 정확히 되찾는 검색형 질문이에요. 저자들은 메모리를 발표할 때 RAG 점수를 같이 보고하면 남은 개선 여지가 분명해진다고 제안했어요 [1].
과제에 따라 결과가 갈린다는 점도 확인했어요. 과거 작업 궤적을 재사용하는 경험 메모리에서는 웹 과제(WebShop, Mind2Web)에서 긴 궤적을 워크플로·전략으로 정리한 메모리가 RAG를 앞서기도 했고, 도구 사용 과제(AppWorld, τ²-Bench)에서는 여러 메모리가 RAG보다 뒤졌어요 [1]. 비디오 월드 모델에서도 과거 프레임을 직접 다시 넣는 방식이 잠재 표현이나 캐시 기반 메모리보다 일관되게 밀리지 않았어요 [1].
에이전트 메모리를 만들 때 원본을 남겨야 하나요
원본으로 돌아가는 경로를 남기면 손실이 크게 줄었어요. 저자들은 새 구조를 만들지 않고 기존 시스템에 붙이는 방법 두 가지를 시험했어요. 하나는 답할 때 가공된 메모리와 원본 기록을 함께 검색해 다시 순위를 매기는 원본 복구 경로(src-aug)예요 [1].
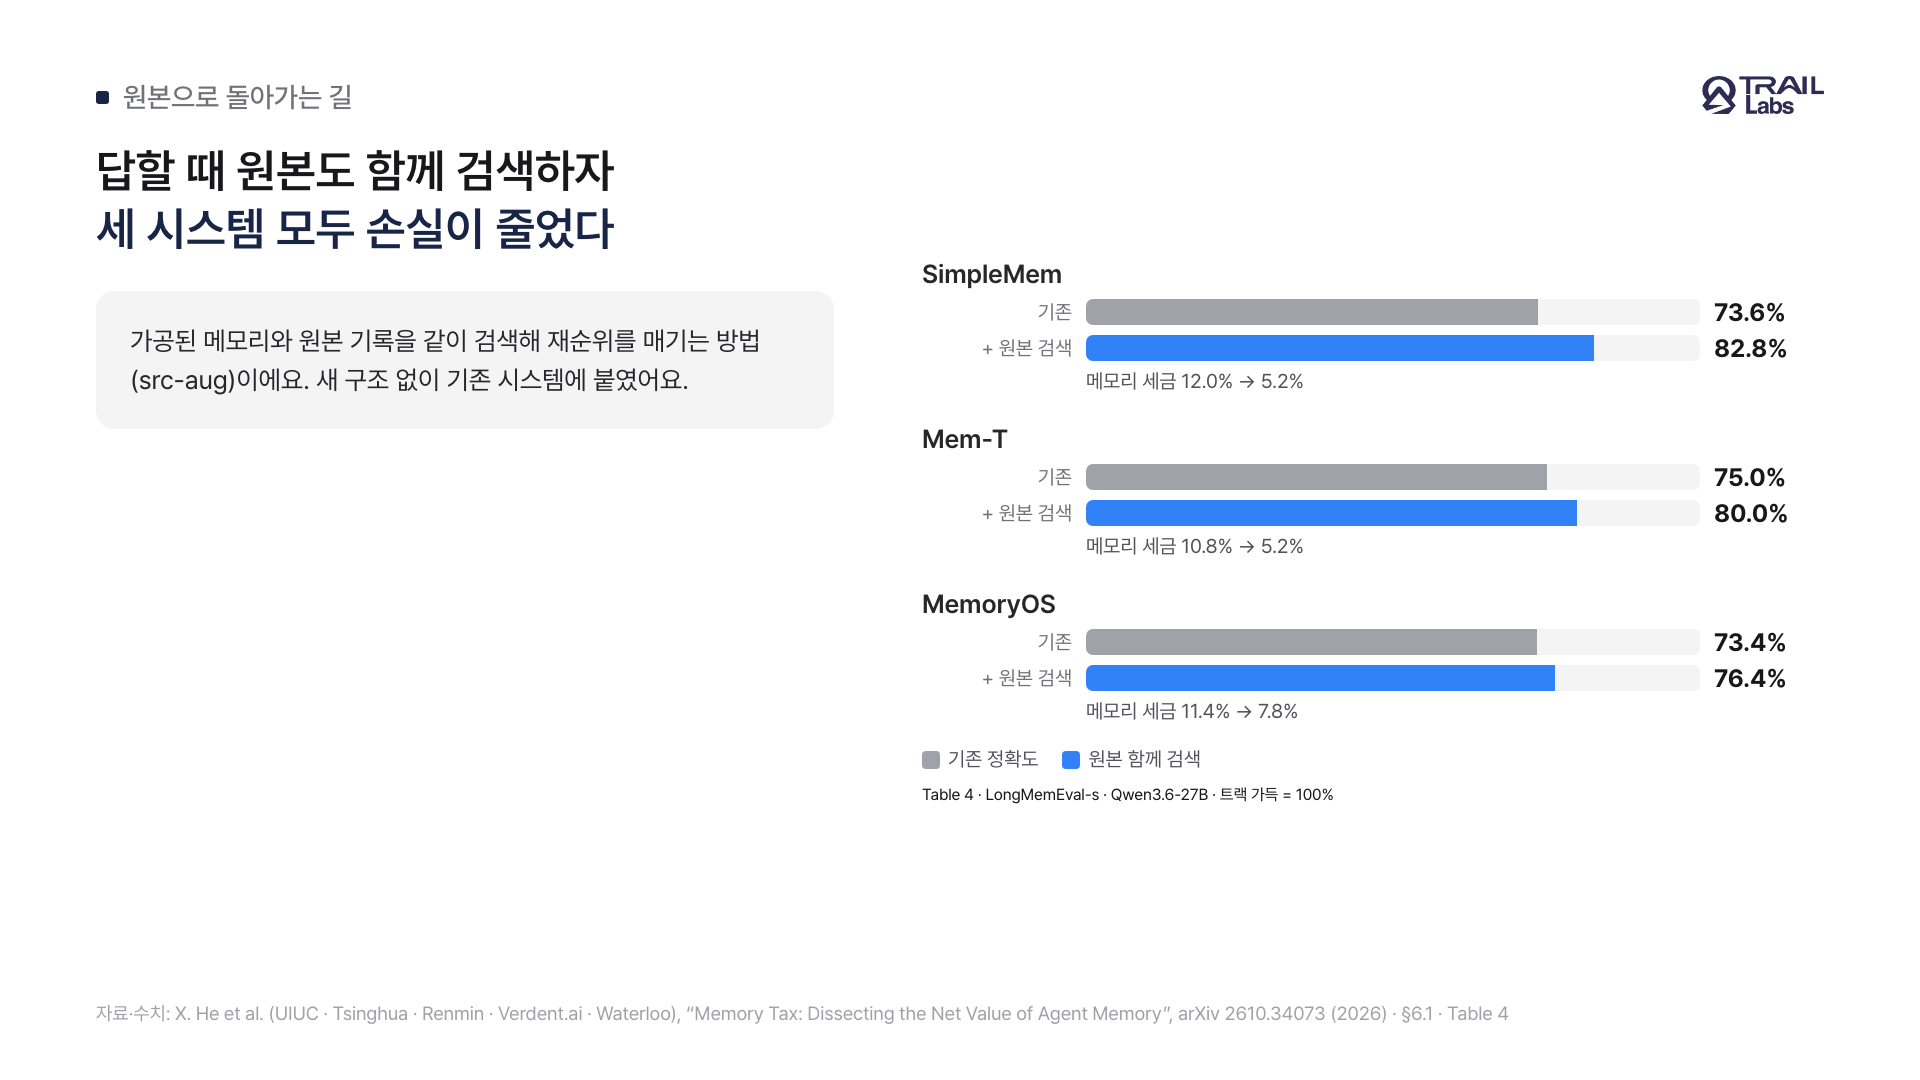
그림 3. 원본 기록을 함께 검색하자 세 시스템 모두 정확도가 오르고 메모리 세금이 줄었어요(LongMemEval-s, Qwen3.6-27B, 표 4) [1].
LongMemEval-s(Qwen3.6-27B)에서 SimpleMem은 정확도가 73.6%에서 82.8%로 올랐고 메모리 세금은 12.0%에서 5.2%로 내려갔어요. Mem-T는 75.0%에서 80.0%(세금 10.8%에서 5.2%), MemoryOS는 73.4%에서 76.4%(세금 11.4%에서 7.8%)였어요 [1]. 다른 하나는 과거 질문과 그때 찾아낸 근거를 메모리에 다시 넣는 재귀 방식(recursive)인데, PersonaMem-v2에서 세 시스템 모두 소폭 올랐어요. LongMemEval-s는 대화마다 질문이 하나라 이 방식을 적용할 수 없었어요 [1].
저자들은 더 근본적인 긴장도 짚었어요. 질문이 오기 전에 미리 가공하는 방식(ahead-of-time)은 어떤 가공이 도움이 될지 모르는 채로 처리하고, 질문이 온 뒤 가공하는 방식(just-in-time)은 정확하지만 응답이 느려져요. 개인 에이전트에서는 과거 관심사와 사용 패턴이 앞으로 무엇이 필요할지 알려 주는 신호가 될 수 있어서, 메모리를 일종의 추천 시스템으로 보자는 제안이에요 [1].
TRAIL은 이 결과를 어떻게 보나요
TRAIL Search의 브랜드 메모리를 이 논문의 기준으로 다시 읽었어요. 브랜드 메모리는 고객이 넣은 참고 자료의 원본(URL·파일·원문)을 저장해 두고, 거기서 무드·색·사업 분류 같은 항목을 LLM으로 추출해 둬요. 글을 생성할 때 모델이 받는 건 이 추출 항목을 정리한 지시 목록이고, 원본 발췌는 함께 넘어가지 않아요(2026년 10월 31일 코드 기준). 논문 용어로 보면 원본은 남아 있지만 생성 단계에서 돌아갈 경로가 없는 구조예요.
그래서 브랜드 메모리에서 생성 경로에 원본 발췌를 함께 검색해 넣는 방식을 점검 대상으로 올렸어요. 추출 항목이 놓친 수치나 표현을 원문이 보충할 수 있는지, 그게 생성 비용을 얼마나 늘리는지를 같이 재야 해요. 아직 측정한 결과는 없어요. 회사 사실 문서는 이미 원자료 폴더를 손대지 않고 두고, 사실 파일마다 출처를 각주로 다는 방식으로 운영하고 있어요. 이 방식은 LLM 위키와 Open Knowledge Format 글에 정리해 뒀어요.
근거를 남겨 두는 문제는 답변의 출처를 밝히는 문제와도 이어져요. RAG 출처 표시 글과 RAG 환각 방어 글에서 다룬 것처럼, 답의 근거를 원문 단위로 되짚을 수 있어야 틀린 답을 고칠 수 있어요.
한계
이 연구는 비용 때문에 표본을 줄였어요. PersonaMem-v2는 20%, MINT-Eval은 10%, GPT-5.6 Luna 조건의 LongMemEval-s는 20%(대화 100개)만 썼고, 질문 유형별 층화 표본이에요 [1]. 가장 강한 모델은 GPT-5.6 Luna(low)였고, 그보다 강한 프런티어 모델은 넣지 않았어요. 정답 판정은 Qwen3.6-27B 기반 LLM 판정이에요 [1].
벤치마크는 대부분 정적·오프라인·영어예요. 질문이 섞여 들어오는 장기 운영이나 다국어 대화는 다루지 않았어요 [1]. 메모리 시스템은 공식 설정을 따랐고 저자들도 시스템별로 더 조정하면 성능이 오를 수 있다고 밝혔어요. 메모리 세금은 1회 검색 RAG를 기준으로 정의한 값이라, 기준선을 바꾸면 크기도 달라져요 [1].
Frequently asked questions
에이전트 메모리가 RAG보다 나은가요?
이 논문의 실험에서는 대체로 그렇지 않았어요. 메모리 시스템 11종을 벤치마크 3개와 모델 3개로 잰 99개 조건 가운데, 원본 대화를 두 번 검색하는 RAG보다 점수가 높았던 조건은 9개였어요. LongMemEval-s에서 GPT-5.6 Luna를 쓰면 두 번 검색하는 RAG가 90.0%, 가장 좋은 메모리 시스템이 84.0%였어요 [1].
LLM이 대화를 요약해 저장하면 무엇을 잃나요?
구체적인 숫자와 조건이 먼저 빠졌어요. "공항에서 호텔까지 택시가 60달러쯤이라 좀 비싸다"는 말을 OpenViking은 "비용 효율적인 교통수단을 선호한다"로 저장해 60달러를 잃었어요. 원본에서 뽑은 사실을 추적하면 OpenViking은 38.0%를 아예 저장하지 않았고 13.0%를 크게 훼손했어요 [1].
에이전트 메모리를 만들 때 원본을 남겨야 하나요?
원본으로 돌아가는 경로를 남기면 손실이 크게 줄었어요. 답할 때 가공된 메모리와 원본 기록을 함께 검색해 다시 순위를 매기게 하자, SimpleMem의 정확도가 73.6%에서 82.8%로 오르고 메모리 손실 비율은 12.0%에서 5.2%로 내려갔어요(LongMemEval-s, Qwen3.6-27B) [1].
에이전트 메모리 구축 비용은 얼마나 드나요?
시스템마다 크게 달랐어요. LongMemEval-s 대화 100개 기준으로 A-Mem은 메모리 구축에 117.0시간과 LLM 호출 약 9만 8천 회를 썼고, 두 번 검색하는 RAG는 색인에 0.11시간을 쓰고 LLM 호출은 약 200회였어요 [1].
References
Summary
- 메모리 시스템 11종을 99개 조건에서 재면, 원본을 두 번 검색하는 RAG를 넘은 조건은 9개였어요.
- LongMemEval-s(GPT-5.6 Luna)에서 두 번 검색 RAG는 90.0%, 가장 좋은 메모리는 84.0%였고, 메모리 구축에는 100시간 넘게 든 시스템도 있었어요.
- 요약 과정에서 숫자·날짜·조건이 빠지거나 바뀌었고, 남은 정보도 여러 조각으로 쪼개져 검색에서 늦게 나왔어요.
- 답할 때 원본 기록을 함께 검색하는 경로를 붙이면 세 시스템 모두 정확도가 오르고 손실이 줄었어요.
- TRAIL은 브랜드 메모리 생성 경로에 원본 발췌를 함께 넣는 방식을 점검 대상으로 봐요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility