AI 검색은 사용자 질문을 그대로 검색할까: Perplexity 검색어 7만 개가 보여 준 것
AI 검색에서 웹을 뒤지는 검색어는 사람이 아니라 에이전트가 써요. 그중 82.3%는 사용자 의도를 다시 적은 주 검색어 밖의 보조 검색어였어요. 인용되지 않은 문서와 BM25, 임베딩 검색이 놓치는 문서까지 Perplexity의 벤치마크 논문으로 읽어요
AI 검색에서 웹을 뒤지는 검색어는 사람이 쓰지 않았어요. Perplexity 프로덕션 표본의 검색어 69,721개는 모두 에이전트가 썼고, 사용자 의도를 다시 적은 주 검색어는 17.7%, 에이전트가 덧붙인 보조 검색어는 82.3%였어요 [1]. Perplexity 연구진이 2026년 9월 arXiv에 올린 Q2D-Web 논문 v2의 수치예요. 동료 심사 전 단계이고, 저자 회사의 자체 임베딩 모델이 이 벤치마크의 주지표에서 1위를 했다는 점은 감안해서 읽어야 해요 [1].
이 글은 arXiv 원문 v2의 본문과 표 1·2·3, 그림 1–9를 2026년 11월에 읽고 수치를 대조해 정리했어요 [1]. 데이터는 비공개라 재현하지 않았고, 공개된 Q2D-Web 리더보드만 존재를 확인했어요. 저자와 이해관계는 없어요.
AI 검색은 사용자 질문을 그대로 검색하나요
이 표본에서는 그대로 검색하지 않았어요. 에이전트는 사용자 메시지, 앞선 대화, 이미 찾은 결과를 보고 검색어를 쓰고, 사용자는 검색어를 직접 넣지 않아요. 저자들은 한 번의 검색을 의도를 다시 적은 주 검색어(primary) 하나와, 표현을 바꾸거나 배경 자료와 인접 개체를 찾는 보조 검색어(support) 여러 개로 나눠요 [1].
필터링 뒤 남은 수는 주 검색어 12,365개, 보조 검색어 57,356개로, 주 검색어 하나에 보조 검색어가 평균 약 4개 붙어요. 언어는 10개이고 영어가 65.8%, 한국어가 2.2%예요 [1].
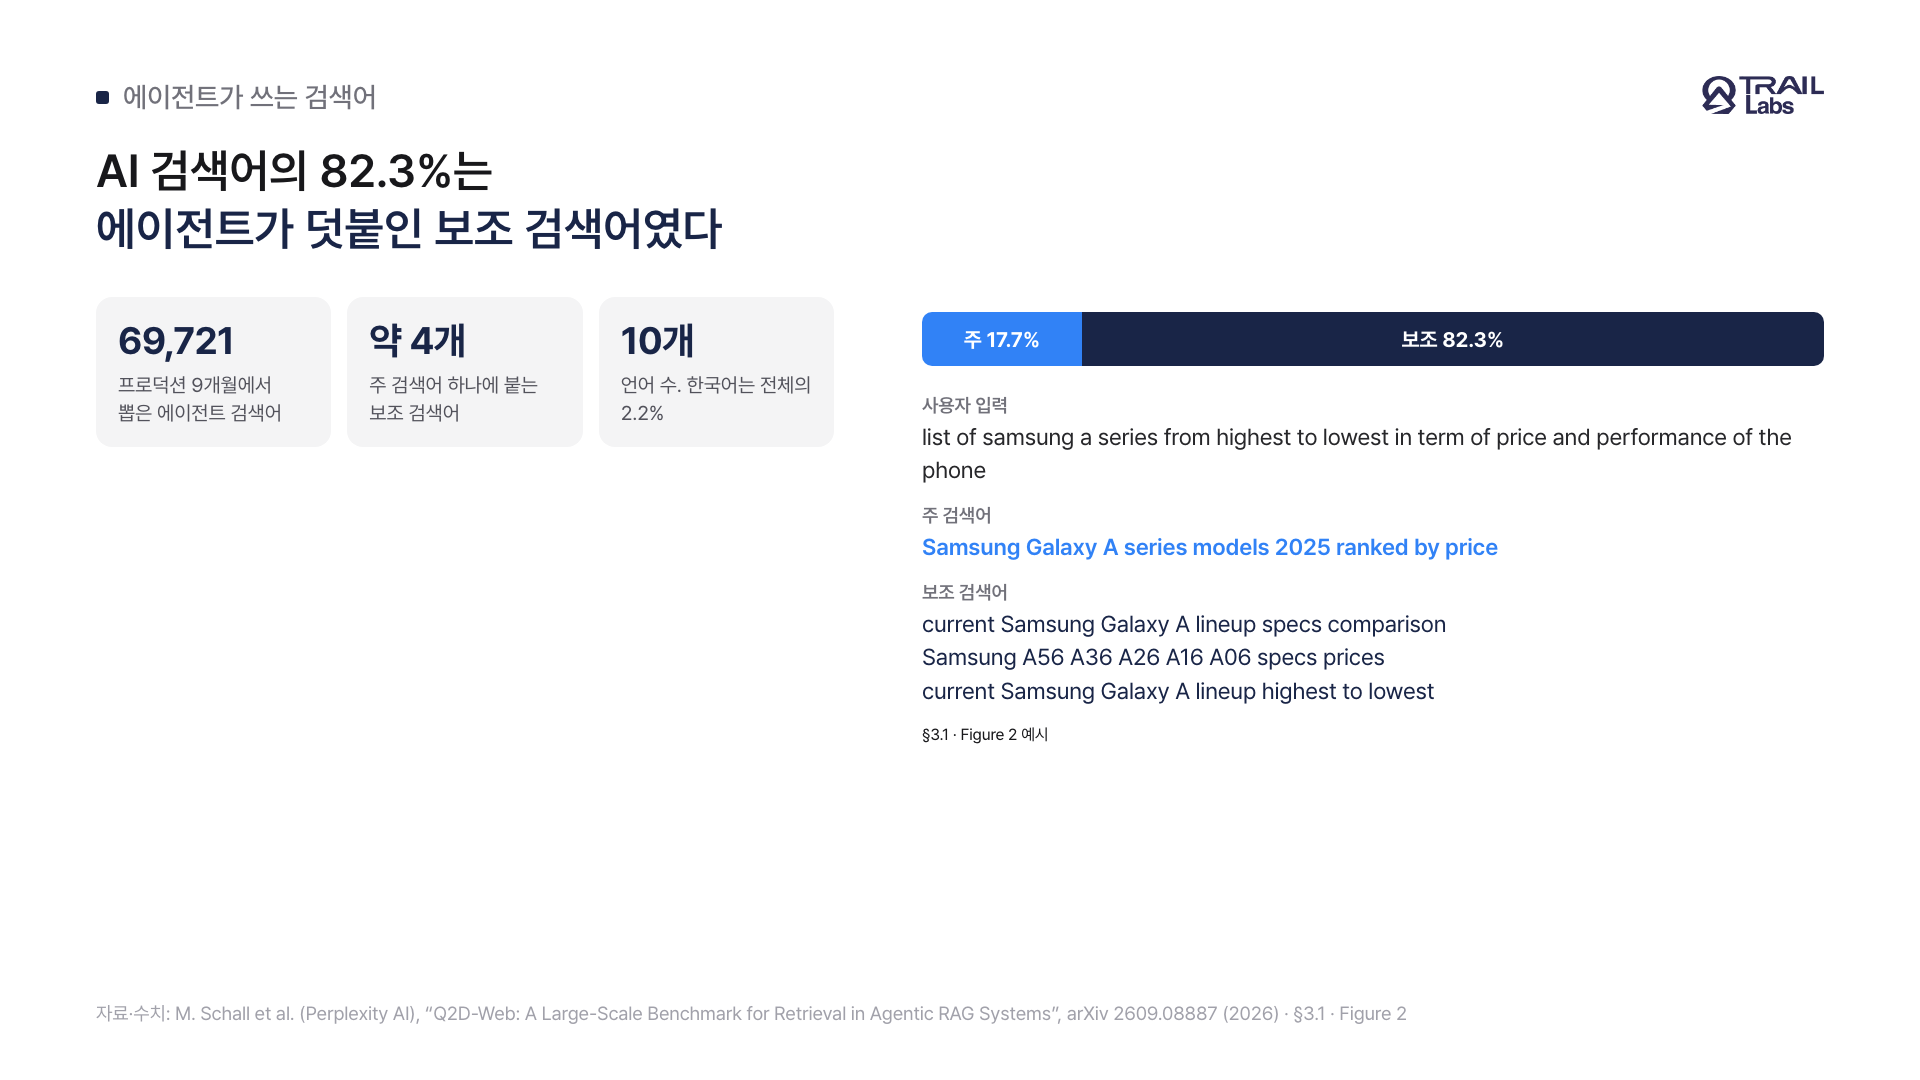
그림 1. 사용자 문장 하나가 주 검색어와 보조 검색어로 나뉘어요. 보조 검색어에는 사용자가 쓰지 않은 모델명이 들어가요 [1].
논문의 예시가 이 차이를 잘 보여 줘요. 사용자가 삼성 A 시리즈를 가격과 성능 순으로 알려 달라고 하면, 보조 검색어에는 "Samsung A56 A36 A26 A16 A06 specs prices"처럼 사용자가 말하지 않은 모델명이 등장해요 [1]. 표현 변화의 영향도 작지 않아요. 저자들이 인용한 ECIR 2022 연구는 의도를 유지한 재작성도 검색 파이프라인의 nDCG@10을 평균 약 20% 낮춘다고 보고했어요 [2]. 이 수치는 Q2D-Web의 측정값이 아니에요.
검색 모델은 어떻게 평가했나요
평가 대상은 BM25와 임베딩 모델 10종, late-interaction 모델 2종이고, 코퍼스는 약 1.9억 문서예요. 코퍼스는 검색어마다 프로덕션 시스템이 찾은 상위 5,000개를 합쳐 중복을 지운 결과라, 무작위 웹보다 그럴듯한 오답이 많아요 [1]. 첫 단계 검색의 역할은 뒤 단계에 넘길 후보를 빠짐없이 모으는 일이어서 주지표는 Recall@1000이에요 [1].
여기서 는 질문 의 관련 문서 집합, 는 retriever가 돌려준 상위 개 문서예요. 값이 높을수록 뒤 단계가 볼 수 있는 근거가 많아져요. 저자들은 첫 단계 retriever가 에이전트가 읽고 인용할 수 있는 범위를 정한다고 설명해요 [1].
| 모델 | Recall@1000 (인용) | Recall@1000 (프로덕션 랭킹) | Recall@1000 (합산) | 고유 관련 문서 |
|---|---|---|---|---|
| pplx-embed-v1-4b | 85.03 | 65.73 | 70.00 | 27,979 |
| Nemotron-3-Embed-8B | 83.14 | 61.73 | 69.33 | 10,506 |
| pplx-embed-v1-0.6b | 81.85 | 62.15 | 67.91 | 11,430 |
| EmbeddingGemma-300M | 80.10 | 58.93 | 66.24 | 17,033 |
| BM25 | 60.84 | 42.50 | 45.25 | 36,073 |
표 1. 전체 코퍼스 기준 13개 중 5개 모델의 결과예요(논문 표 3, §5.1) [1].
주지표 밖에서는 1위가 바뀌어요. 합산 판정의 Recall@100과 nDCG@10에서는 Nemotron-3-Embed-8B가 1위였어요 [1]. 어떤 모델이 최고인지는 지표를 함께 봐야 답할 수 있어요.
AI가 인용하지 않은 문서는 관련 없는 문서인가요
그렇게 볼 수 없어요. 저자들은 관련성을 세 가지로 따로 판정했어요. 에이전트가 인용한 문서, 프로덕션 랭킹 상위 문서(검색어당 평균 43.1개), 이 둘에 LLM 판정을 더한 합산 세트(검색어당 평균 88.5개)예요 [1].
저자들의 설명이 측정하는 쪽에 중요해요. 에이전트는 주장을 뒷받침하면 인용을 멈추기 때문에, 이미 인용된 출처와 내용이 겹치는 관련 문서는 인용되지 않고 비관련으로 라벨링돼요. 그래서 인용 라벨은 구조적으로 정밀도가 높고 재현율이 낮아요 [1]. 인용 수는 "뽑혔다"는 신호로는 쓸 수 있어도, 인용 0건을 "관련 없다"로 읽을 근거는 되지 못해요.
모델 간 상대 순위는 세 판정 세트에서 대체로 안정적이었어요 [1]. 단일 라벨의 편향을 걱정해 세트를 나눈 설계인데, 순위를 고르는 목적이라면 라벨 선택이 생각보다 덜 중요했다는 뜻이에요. 대신 절대값은 크게 달라요. 같은 모델도 인용 라벨 85.03, 프로덕션 랭킹 라벨 65.73이에요.
BM25 키워드 검색은 아직 필요한가요
이 논문만으로 단정할 수는 없어요. BM25는 Recall@1000 45.25로 13개 중 가장 낮았지만, 다른 12개가 찾지 못한 관련 문서를 36,073건 찾아 가장 많았어요. 2위 pplx-embed-v1-4b의 약 1.3배예요 [1]. 보조 검색어에서 BM25만 성능이 올랐다는 결과도 있어요(43.3%에서 45.7%). 임베딩 모델은 보조 검색어에서 0.5–3.2포인트 낮았어요 [1].
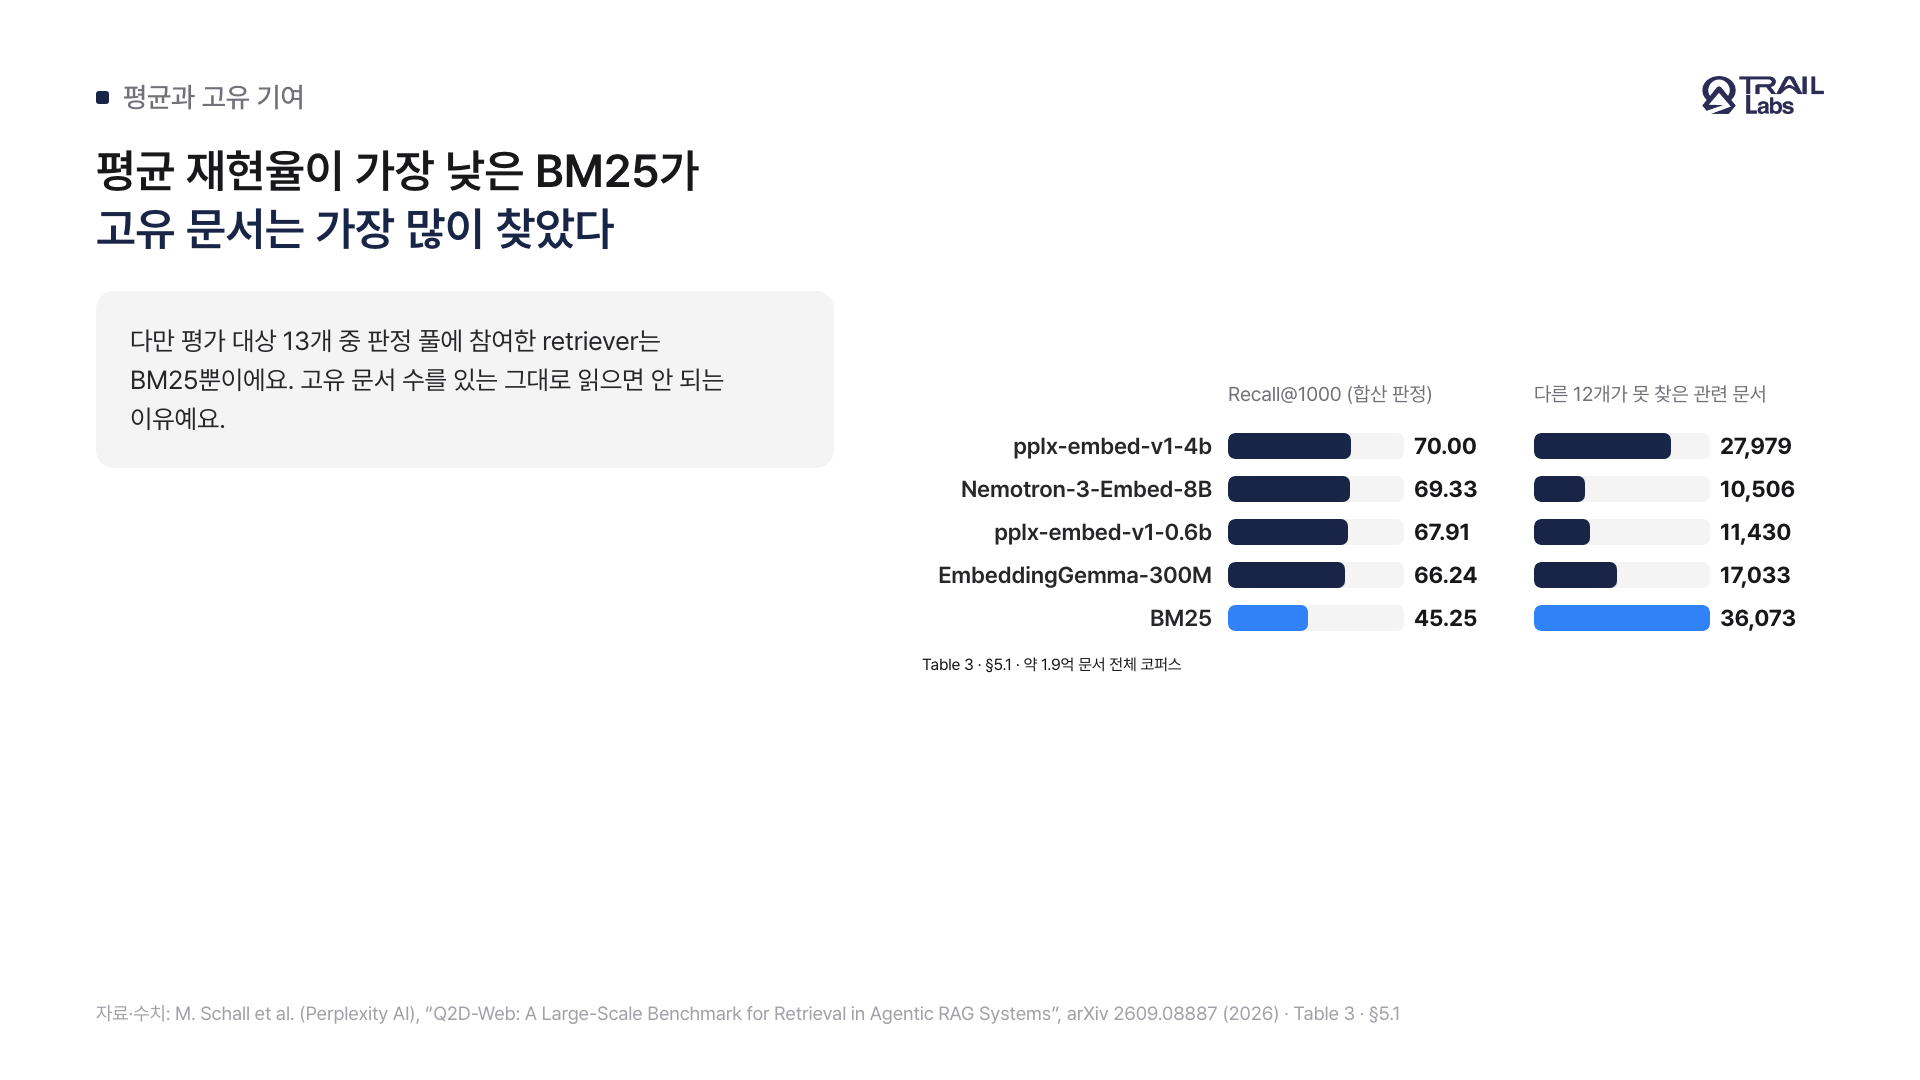
그림 2. BM25는 평균 재현율이 가장 낮으면서 고유 관련 문서는 가장 많았어요 [1].
그대로 믿기 전에 볼 단서가 두 가지 있어요. 판정 풀을 만든 retriever 9개 중 평가 대상과 겹치는 모델은 BM25뿐이고, 프로덕션 랭킹 라벨도 BM25와 임베딩을 함께 쓰는 사내 시스템에서 나왔어요 [1]. BM25가 찾은 문서가 관련 문서로 라벨링될 기회가 더 많았을 수 있다는 건 이 글의 해석이에요. 규모도 봐야 해요. 검색어 수와 검색어당 판정 수로 어림하면 합산 판정은 약 617만 쌍이고, 36,073건은 그 1%에 못 미쳐요(직접 계산).
저자들도 BM25를 조합에 넣으면 재현율이 오르는지는 검증하지 않았고, 후속 실험 제안으로 남겼어요 [1]. 이전에 읽은 쿼리 팬아웃과 다양성 보상 글과 이어지는 질문이지만, 이 논문이 답한 건 아니에요.
임베딩 검색이 놓치는 문서는 어떤 문서인가요
13개 모두 상위 1,000개에 넣지 못한 관련 문서가 298,868건으로, 관련 문서의 6.3%였어요. 저자들이 표본 4,000건을 DeepSeek-V4-Flash로 분류하자 검색어와 겹치는 단어가 거의 없는 문서가 28.3%로 가장 많았어요 [1].
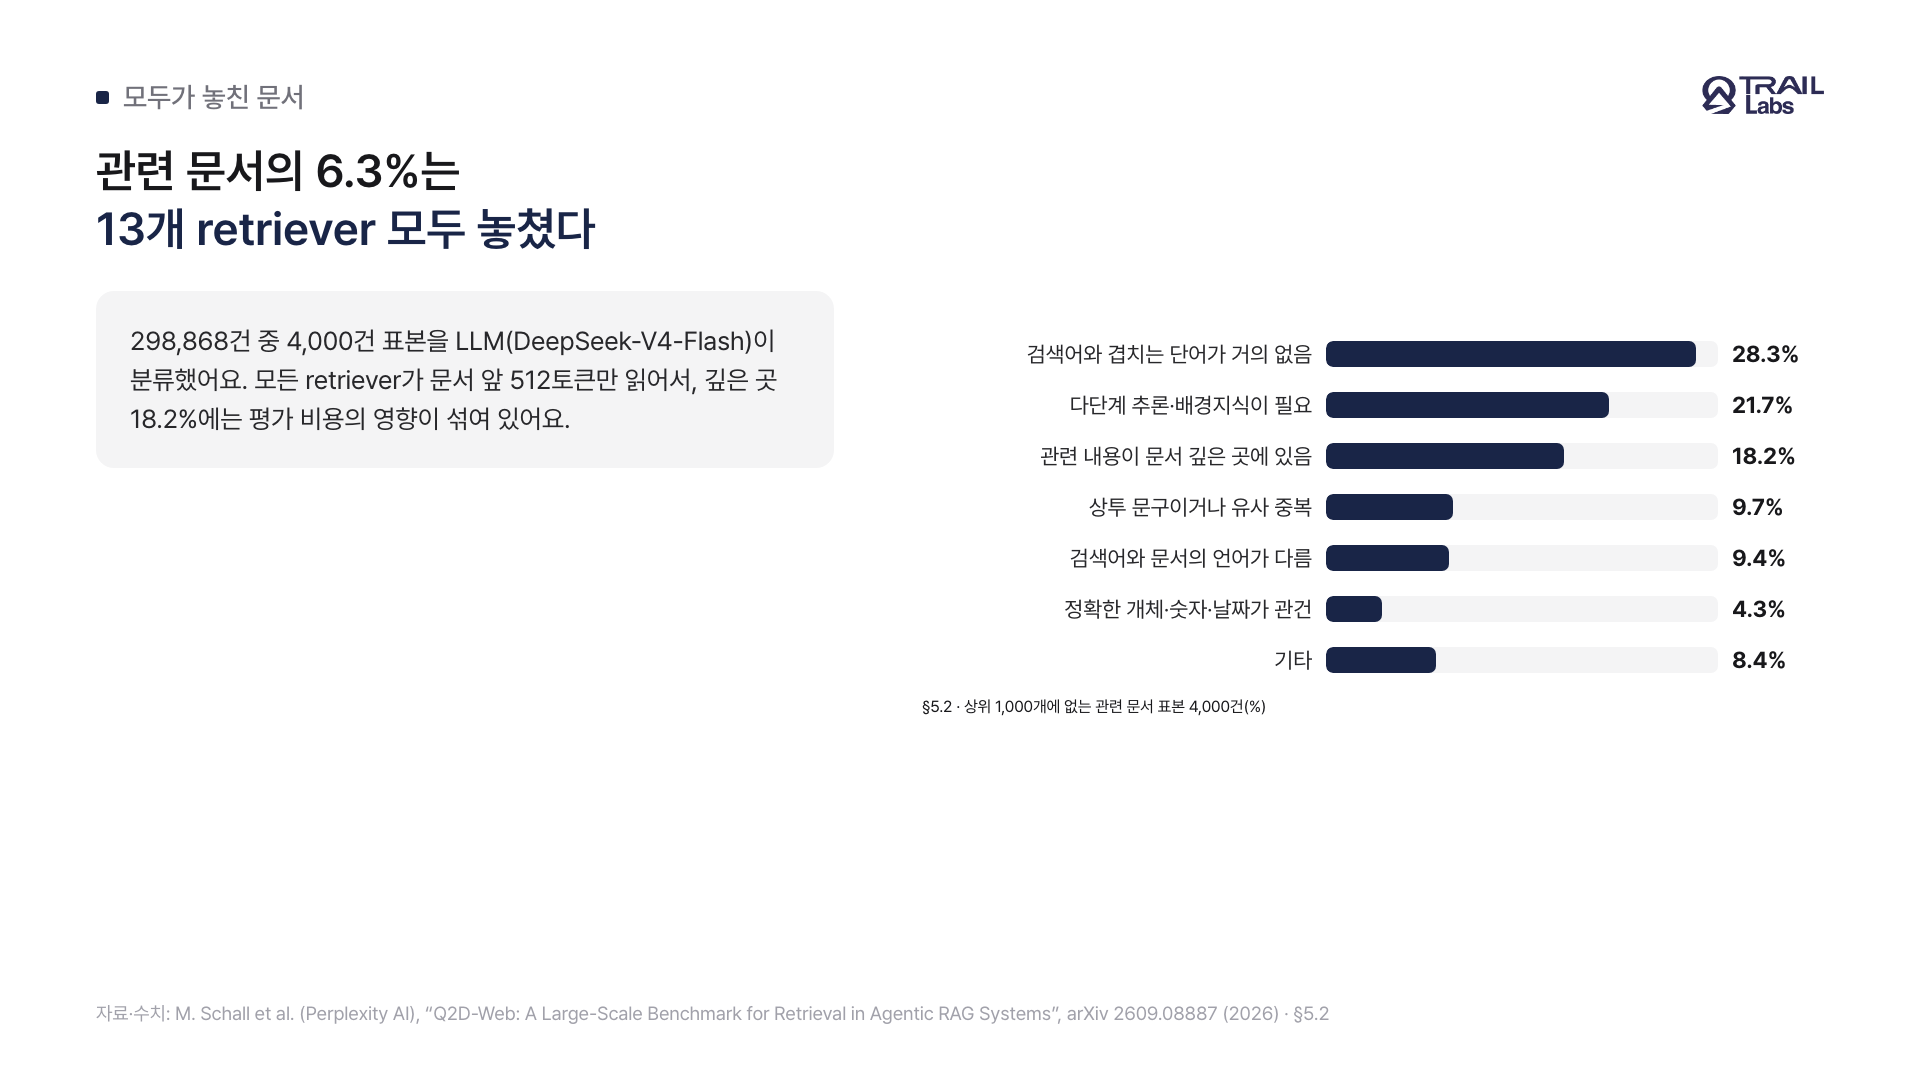
그림 3. 모두가 놓친 문서의 가장 큰 이유는 검색어와 문서의 어휘 차이였어요. 분류는 LLM 판정이에요 [1].
| 놓친 이유 | 비율 |
|---|---|
| 의미는 맞지만 검색어와 겹치는 단어가 거의 없음 | 28.3% |
| 연결에 다단계 추론이나 배경지식이 필요 | 21.7% |
| 관련 내용이 문서 깊은 곳에 있음 | 18.2% |
| 상투 문구이거나 유사 중복 | 9.7% |
| 검색어와 문서의 언어나 문자가 다름 | 9.4% |
| 정확한 개체·코드·숫자·날짜가 관건 | 4.3% |
| 기타 | 8.4% |
표 2. 논문 §5.2의 분류 결과예요. 분류 모델이 판정 라벨을 만든 모델과 같아요 [1].
깊은 곳 18.2%는 평가 조건과 함께 읽어야 해요. 비용 때문에 모든 retriever가 문서 앞 512토큰만 읽었고, 평균 문서는 약 3,300토큰이에요 [1]. 실제 서비스의 처리 방식은 논문 범위 밖이에요. 그럼에도 앞부분에 핵심을 두면 이런 잘림의 위험을 줄일 수 있다는 건 이 글의 해석이에요.
반대 방향의 오류도 있어요. 13개 모두 상위 1,000개에 넣었는데 비관련으로 라벨된 문서 표본에서, 같은 주제의 다른 측면을 다룬 문서가 35.6%, 일부만 다룬 문서가 19.6%, 비슷하지만 다른 제품·인물·버전을 다룬 문서가 14.5%였어요. 16.8%는 실제로 관련 있는 문서로 재판정됐어요 [1].
한국어 검색에서는 결과가 어떻게 다른가요
한국어에서는 BM25와 최상위 모델의 격차가 영어의 절반이었어요. 그림 7의 Recall@1000을 읽으면 영어는 최상위 pplx-embed-v1-4b 71%, BM25 45%로 26포인트 차이지만, 한국어는 68%와 55%로 13포인트 차이예요 [1].
| 검색어 언어 | pplx-embed-v1-4b | Nemotron-3-Embed-8B | EmbeddingGemma-300M | BM25 |
|---|---|---|---|---|
| 영어 | 71% | 70% | 67% | 45% |
| 일본어 | 72% | 71% | 68% | 54% |
| 한국어 | 68% | 68% | 62% | 55% |
| 중국어 | 68% | 67% | 63% | 50% |
표 3. 논문 그림 7에서 네 언어와 네 모델을 옮겼어요 [1].
저자들은 이 차이의 원인을 분석하지 않았어요. 한국어는 전체 검색어의 2.2%, 코퍼스의 3.0%이고 형태소 처리나 코퍼스 구성의 영향도 가려지지 않아서, 한국어에서 키워드 검색이 더 낫다는 결론으로 옮기면 안 돼요 [1]. 주제별로도 차이가 있어요. pplx-embed-v1-4b는 역사와 음식에서 74%였지만 지역(Local) 66%, 뉴스 61%였어요 [1].
TRAIL은 이 결과를 어떻게 보나요
TRAIL Search는 엔진 응답이 돌려주는 검색어를 저장해 CSV로 내보내는 경로를 갖고 있어요(2026년 11월 2일 코드 기준). 키워드 도메인의 fan-out은 우리가 자체 생성한 검색어라서 저장할 때 분리해 뒀어요. 다만 두 값을 비교하는 지표는 아직 없어요. API가 돌려준 검색어가 소비자 앱 내부 검색어 전체와 같다고 볼 근거도 없어요. 그래서 "자체 생성 fan-out이 엔진에서 관측된 검색어를 얼마나 덮는가"를 점검 항목으로 올렸어요. 아직 측정한 결과는 없어요.
이 질문은 앞서 쓴 추적 프롬프트와 fan-out 격차 글과 이어져요. 페이지 진단도 같은 점검 대상이에요. 청크 시뮬레이터는 질문 단어를 기준으로 채점할 수 있는데, 어휘 차이가 놓침의 가장 큰 이유라면 사용자 문장 대신 에이전트 검색어로 재는 값도 함께 봐야 해요. 측정 쪽의 흔들림은 반복 측정 글에서 다뤘어요.
한계
쿼리, 코퍼스, 판정은 비공개라 외부에서 재현할 수 없어요. 저자들은 학습 데이터 오염을 막기 위해서라고 밝혔고, 외부 평가는 공개 모델을 리더보드에 제출하는 방식이에요 [1]. 검색어도 한 상용 서비스의 분포이고, 다른 엔진의 보조 검색어 비율로 일반화할 근거는 없어요. 필터링은 검색어 단위라 주 검색어가 빠진 검색도 남아 있어요 [1].
인용과 랭킹 라벨은 Perplexity 자체 시스템에서 나왔고, LLM 판정은 DeepSeek-V4-Flash 하나에 기대요. 저자들도 각 라벨의 편향을 인정했고, 비관련 표본의 16.8%가 재판정됐어요 [1]. 자사 모델이 평가 대상에 포함돼 1위를 했고, 후속 분석 대부분은 합산 판정과 Recall@1000에 한정돼요. 이 논문은 첫 단계 검색만 평가해서, 콘텐츠를 어떻게 쓰면 인용되는지는 직접 답하지 않아요 [1].
Frequently asked questions
AI 검색은 사용자 질문을 그대로 검색하나요?
Perplexity 프로덕션 표본에서는 사용자가 검색어를 직접 넣지 않았어요. 에이전트가 사용자 메시지와 앞선 대화, 이미 찾은 결과를 보고 검색어를 썼어요. 검색어 69,721개 중 주 검색어가 17.7%, 보조 검색어가 82.3%였어요 [1].
AI가 인용하지 않은 문서는 관련 없는 문서인가요?
그렇게 볼 수 없어요. 저자들은 에이전트가 주장을 뒷받침하면 인용을 멈춘다고 설명하고, 그래서 인용 라벨은 정밀도는 높고 재현율은 낮다고 밝혔어요. 비슷한 내용의 다른 문서가 이미 인용됐다면 관련 문서도 인용되지 않아요 [1].
BM25 키워드 검색은 아직 필요한가요?
이 논문만으로 단정할 수는 없어요. BM25는 Recall@1000이 45.25로 13개 중 가장 낮았지만 다른 모델이 못 찾은 관련 문서를 36,073건 찾아 가장 많았어요. 다만 BM25는 평가 대상 중 유일하게 판정 풀에 참여했고, BM25를 넣은 조합이 실제로 재현율을 올리는지는 저자들도 후속 과제로 남겼어요 [1].
임베딩 검색이 놓치는 문서는 어떤 문서인가요?
13개 retriever가 모두 상위 1,000개에 넣지 못한 관련 문서가 6.3%였어요. 표본 4,000건을 LLM으로 분류하면 검색어와 겹치는 단어가 거의 없는 문서가 28.3%, 다단계 추론이 필요한 문서가 21.7%, 관련 내용이 문서 깊은 곳에 있는 문서가 18.2%였어요 [1].
References
- [1]Maximilian Schall, Sedigheh Eslami, Markus Krimmel, Antoine Chaffin, Louis Milliken, Bo Wang, Denis Bykov, "Q2D-Web: A Large-Scale Benchmark for Retrieval in Agentic RAG Systems", arXiv 2609.08887v2 (2026-09-28)
- [2]Gustavo Penha, Arthur Câmara, Claudia Hauff, "Evaluating the Robustness of Retrieval Pipelines with Query Variation Generators", ECIR 2022
Summary
- Perplexity 프로덕션 검색어 69,721개는 모두 에이전트가 쓴 것이고, 82.3%가 보조 검색어였어요.
- 인용 라벨은 정밀도는 높고 재현율은 낮아서, 인용되지 않았다고 무관한 문서로 볼 수 없어요.
- BM25는 평균 재현율이 가장 낮으면서 고유 문서는 가장 많이 찾았지만, 판정 풀 참여라는 단서가 붙어요.
- 한국어 검색어에서 BM25와 최상위 모델의 격차는 13포인트로, 영어의 26포인트보다 작았어요.
- TRAIL은 엔진이 돌려준 검색어와 자체 생성 fan-out을 비교하는 작업을 점검 항목으로 봐요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility