쿼리 팬아웃에 다양성 보상을 넣으면: 구글 R4T 논문 읽기
질의를 펴는 층이 중복을 줄이도록 학습되고 있어요. 그 다양성이 검색에서도 옳은지는 별개의 질문이에요
구글 리서치의 R4T 논문은 쿼리 팬아웃을 근거성·다양성·원질문 정렬이라는 집합 단위 보상으로 학습한 뒤, 그 행동을 5,390만 파라미터짜리 확산 모델에 옮겨 질의 묶음을 한 번에 만들게 했어요. 질의를 펴는 층이 중복을 줄이도록 명시적으로 학습되고 있다는 신호이고, 그 다양성이 사실형 검색에서도 옳은지는 이 논문이 보여주지 않았어요. 논문은 Pengcheng Jiang, Judith Yue Li 등 구글 리서치와 일리노이대(UIUC) 연구진 11명이 쓴 "Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion"이에요 [1]. ICML 2026 포스터로 발표됐고 [3], 구글 리서치 블로그가 2026년 9월에 해설 글을 냈어요 [2].
이 글의 근거 범위와 평가 방법부터 밝혀 둘게요. 2026년 10월 기준 공개 자료인 arXiv 2603.06397 v1 원문(2026-03-06 제출)과 구글 리서치 블로그 해설을 대조해 정리했고, 수치는 전부 논문 본문과 표에서 옮겼어요 [1][2]. 우리는 실험을 직접 재현하지 않았고, 보고된 속도 향상은 집합형 추천 과제의 지연 시간 결과예요. 논문은 웹 검색 순위나 AI 답변 인용에 대한 결과를 내지 않았으니, 이 글의 실무 해석은 그 간극을 전제로 읽어 주세요. 저자들과 이해관계는 없고, AI 검색 가시성 진단 제품을 운영하는 입장에서 읽었다는 편향은 밝혀 둘게요.
쿼리 팬아웃은 왜 집합 문제인가
팬아웃 검색의 좋고 나쁨은 하위 질의 하나가 아닌, 묶음 전체에서 정해져요. 논문은 이를 "집합값(set-valued)이고 분해되지 않는(non-decomposable)" 검색 문제라고 불러요 [1]. 넓은 의도를 받으면 시스템은 결과 하나 대신 묶음을 돌려줘야 하고, 그 묶음은 다양성, 의도 커버리지, 상호보완성 같은 고차 속성을 만족해야 해요. 동시에 실제 데이터베이스에 있는 항목에 근거해야 해요.
구글 리서치 블로그는 이 문제를 캠핑 장비 예시로 설명해요. "캠핑 장비"를 검색한 사람은 4인용 텐트의 미세한 변형 열 개를 원하지 않아요 [2]. 텐트, 침낭, 버너, 헤드램프처럼 서로 보완하는 묶음이 좋은 답이에요.
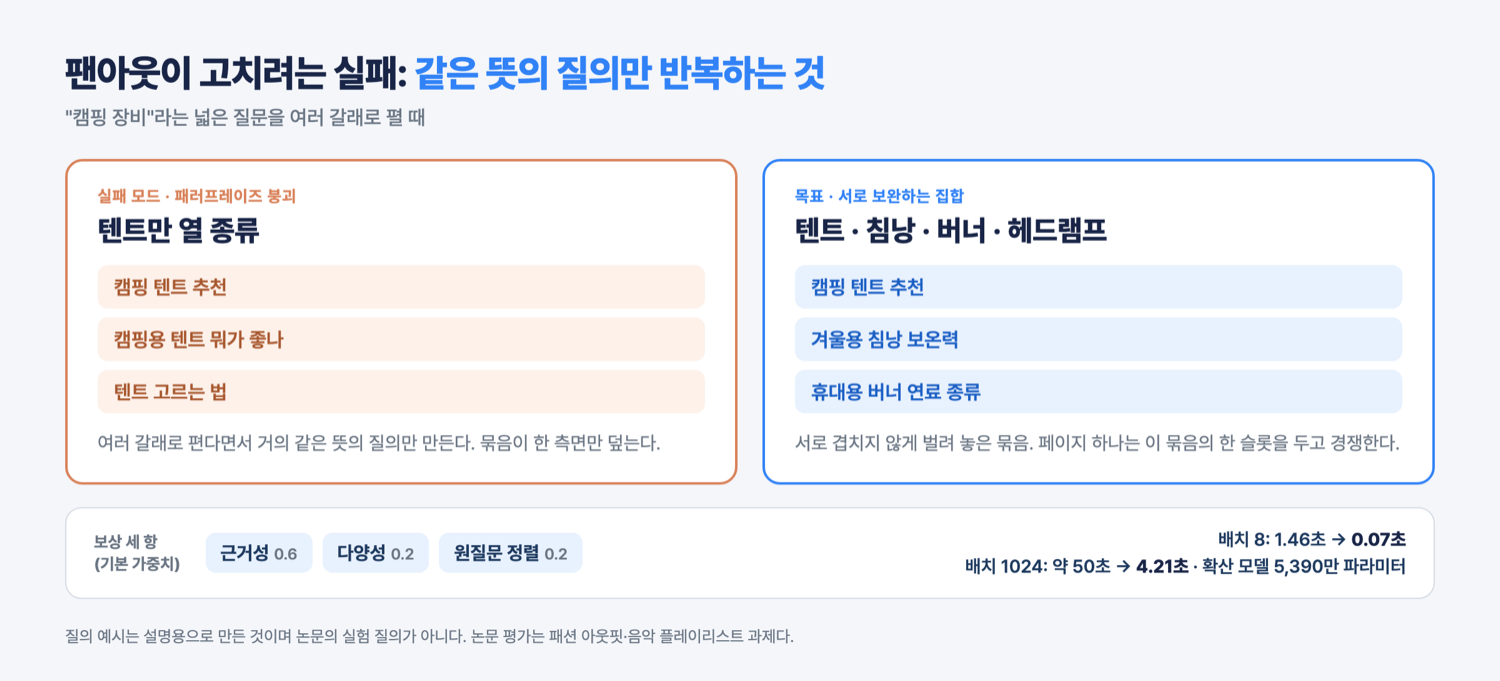
그림 1. 왼쪽은 거의 같은 뜻의 하위 질의만 만드는 패러프레이즈 붕괴, 오른쪽은 서로 겹치지 않게 벌린 질의 집합이에요. 아래 띠는 보상 세 항의 기본 가중치와 배치 8, 배치 1024에서의 지연 시간을 정리했어요. 질의 예시는 설명용으로 만든 것이에요.
여기서 기존 학습 방식의 한계가 드러나요. 지도학습 데이터는 보통 (질의, 정답 하나) 쌍이라 top-1 검색만 학습시켜요 [1]. "이 질의들이 서로를 보완해야 한다"는 조건은 개별 질의에 붙는 레이블로 쓸 수가 없어요. 정답 묶음도 하나로 정해지지 않아요. 같은 넓은 의도에 맞는 묶음이 여러 개 있을 수 있으니, 정답 레이블을 모으는 것 자체가 비싸고 주관적이에요.
강화학습은 묶음 단위 보상을 직접 최적화할 수 있어서 이 문제에 맞아요. 대신 강화학습으로 튜닝한 언어모델을 추론 시점에 매번 돌리면 너무 느려요. 하위 질의를 순서대로 생성하고, 질의마다 검색을 호출하기 때문이에요. 논문의 출발점은 이 두 요구를 떼어 놓는 데 있어요.
R4T의 3단 구조: 강화학습은 한 번만, 추론은 확산 모델로
R4T(Retrieve-for-Train)는 강화학습을 배포용 추론 엔진 대신 "목적 변환기"로 한 번만 써요 [1]. 비싼 탐색을 오프라인에서 한 번 해 두고, 그 결과를 작은 모델에 증류하는 방식이에요. 논문 제목의 "RL-Compiled"가 이 뜻이에요.
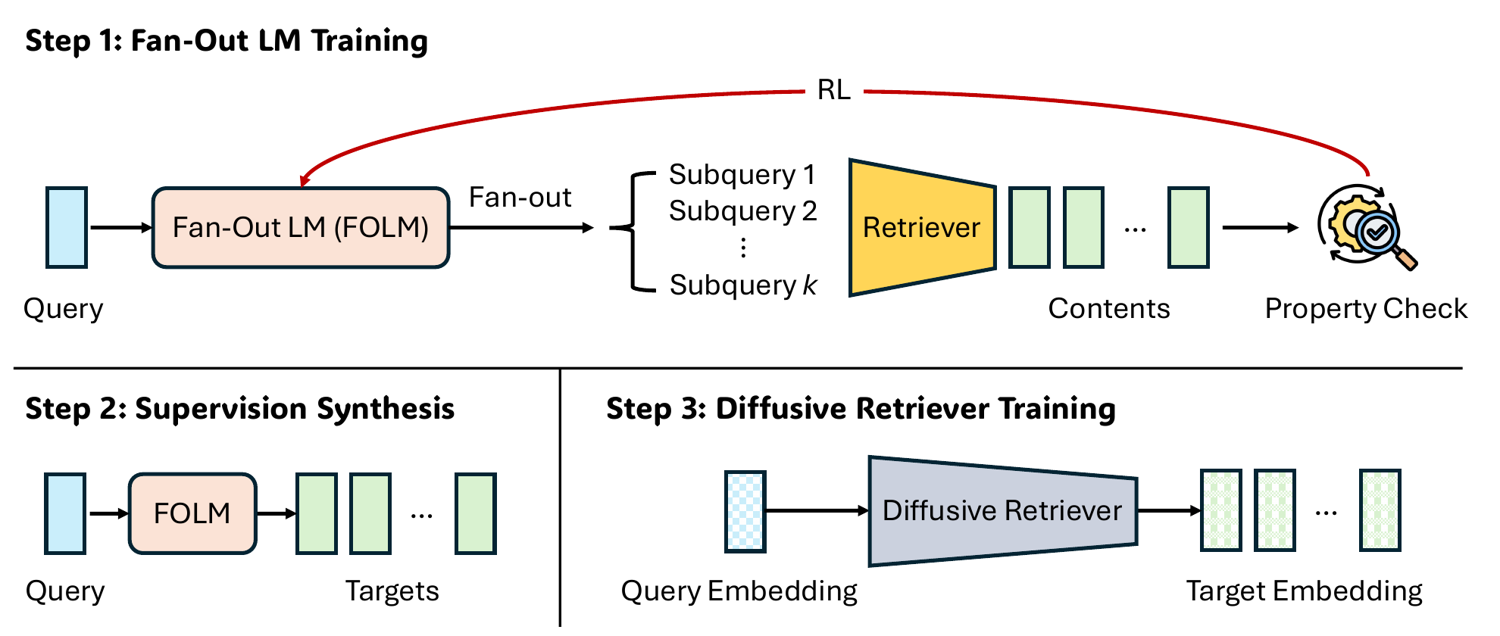
그림 2. R4T의 세 단계. 1단계에서 팬아웃 언어모델(FOLM)이 하위 질의를 만들고 검색 결과의 속성 점검으로 강화학습 보상을 받아요. 2단계에서 학습된 FOLM으로 질의와 타깃 쌍을 합성하고, 3단계에서 질의 임베딩을 받아 타깃 임베딩 묶음을 내놓는 확산 검색기를 학습해요 [1].
| 단계 | 하는 일 | 논문 설정 |
|---|---|---|
| 1. 팬아웃 언어모델 학습 | 넓은 질의에서 하위 질의 k개를 생성, 고정된 검색기로 검색, 묶음 보상으로 강화학습 | Gemma3-4B·Qwen3-4B, GRPO와 Soft-PPO 정규화, 그룹 크기 8 |
| 2. 학습 데이터 합성 | 학습된 FOLM을 돌려 보상이 높은 궤적을 모아 (질의 임베딩, 타깃 임베딩 묶음) 쌍으로 변환 | 질의당 128개 샘플, 온도 0.9 |
| 3. 확산 검색기 학습 | 질의 임베딩을 조건으로 타깃 임베딩 묶음 전체를 한 번에 생성 | 6층 16헤드 트랜스포머, 임베딩 128차원, 묶음 길이 12, 샘플링 256스텝 |
표 1. R4T의 세 단계와 논문이 밝힌 주요 설정 [1].
배포 형태는 둘이에요. R4T-FOLM은 강화학습한 언어모델을 그대로 추론에 쓰는 변형이고, R4T-Diffusion은 그 행동을 증류한 확산 모델을 쓰는 변형이에요 [1]. 두 변형을 비교하면 "보상으로 최적화한 팬아웃의 품질"과 "그걸 배포하는 비용"을 따로 볼 수 있어요. 확산 모델의 학습 타깃을 만들 때는 묶음 안의 행 순서를 무작위로 섞어요. 집합에는 순서가 없으니 모델이 순서에 의존하지 않게 하려는 장치예요.
보상 세 항: 근거성, 다양성, 원질문 정렬
R4T의 보상은 근거성, 다양성, 원질문 정렬 세 항의 가중합이고, 기본 가중치는 0.6, 0.2, 0.2예요 [1]. 정답 묶음이 없는 개방형 추상 검색(OAR) 과제에서 쓰는 보상은 다음과 같아요.
는 원래의 넓은 질의, 는 생성된 하위 질의 묶음이에요. 근거성 는 각 하위 질의 임베딩이 데이터베이스의 가장 가까운 항목과 얼마나 가까운지를 재요. 실제로 존재하는 것을 가리키는 질의일수록 점수가 높아요. 정렬 은 각 하위 질의와 원질의의 코사인 유사도 평균이라, 질문에서 벗어난 질의를 깎아요.
다양성 는 하위 질의마다 대표 검색 결과 하나(, 예를 들어 top-1 항목)를 뽑고 그 임베딩 묶음에 Vendi Score를 계산해요 [1][4]. Vendi Score는 유사도 행렬 고유값의 섀넌 엔트로피에 지수를 취한 값이라, 묶음 안에 사실상 서로 다른 것이 몇 개 있는지를 세는 지표로 읽혀요 [4]. 질의 문자열 대신 검색된 결과의 다양성을 잰다는 점이 중요해요. 표현만 바꾼 질의가 같은 항목을 가져오면 다양성 점수가 오르지 않아요.
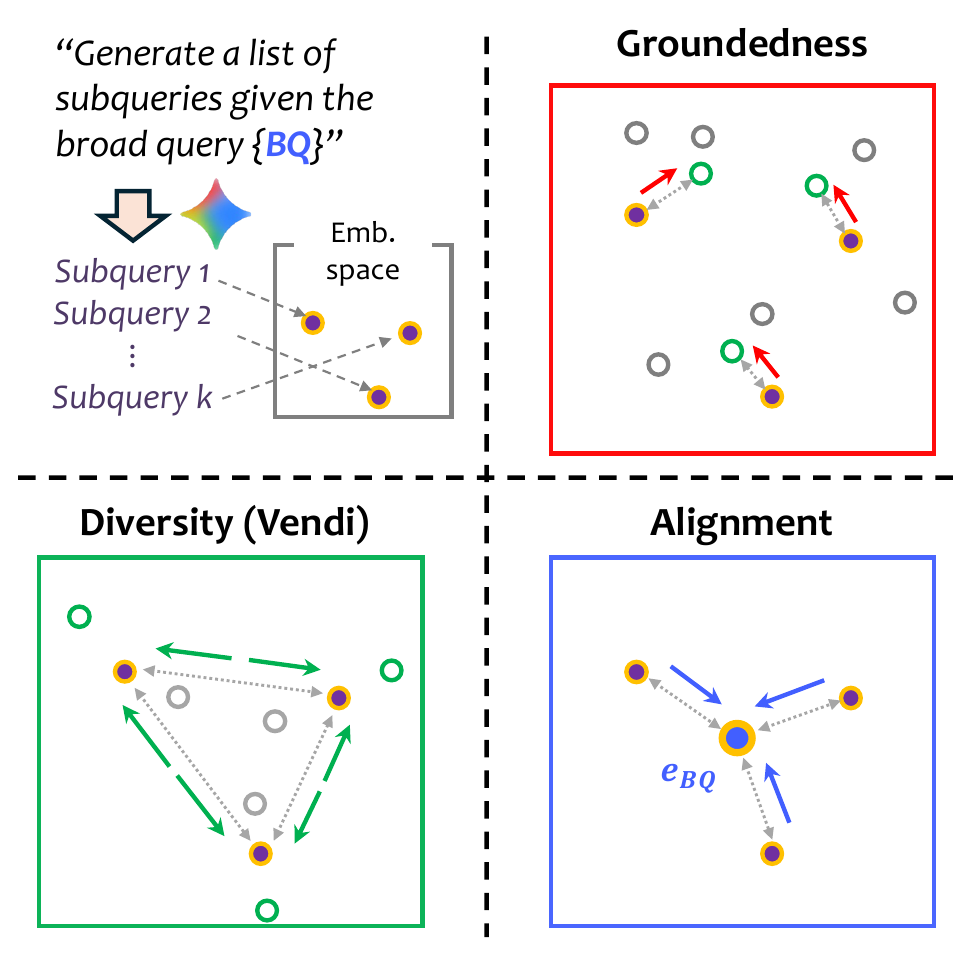
그림 3. OAR 과제의 보상 세 항. 근거성은 하위 질의 임베딩을 실제 데이터베이스 항목 쪽으로 당기고, 다양성(Vendi)은 대표 결과끼리 서로 벌리고, 정렬은 각 하위 질의를 원질의 임베딩 쪽으로 당겨요 [1].
정답 묶음의 일부가 주어지는 약지도 조합 검색(WSCR) 과제에서는 보상이 달라요. 참조 묶음 중 팬아웃 결과에 들어간 비율을 보상으로 줘요 [1]. 논문은 이 참조 묶음을 "유일한 정답이 아닌, 그럴듯한 실현 하나"로 다뤄요. 그래서 이 과제의 재현율도 정답률보다는 의미 커버리지의 대리 지표로 해석해요.
다양성 항을 빼면 정책이 무너졌다
다양성 항이 들어간 이유는 절제 실험에 있어요. 근거성 보상만으로 학습하면 정책이 "line ending line ending line ending" 같은 의미 없는 문자열로 수렴했어요 [1]. 우연히 특정 데이터베이스 항목과 임베딩 거리가 가까워지는 문자열을 찾아낸 거예요. 근거성과 정렬을 같이 주면 붕괴가 더 빨리 왔어요. 정책이 원질문을 바꿔 말한 질의만 반복해서 정렬 점수를 손쉽게 채웠기 때문이에요.
저자들은 이 실패를 패러프레이즈 붕괴라고 불러요. "보헤미안 페스티벌 스타일"이라는 질의에 기준 모델(Qwen3-4B 제로샷)은 "bohemian festival style", "bohemian festival fashion"처럼 거의 같은 표현을 냈고, R4T는 "bohemian festival dress", "straw boots festival style", "lace bohemian festival"처럼 서로 다른 방향으로 갈라졌어요 [1]. 세 항을 함께 최적화해야 지름길이 막히고 학습이 안정됐어요.
가중치를 바꾼 실험도 있어요. 근거성 비중이 크면 다양성은 오르지만 정렬이 떨어졌고, 정렬과 다양성 비중을 키우면 탐색이 줄어 다른 해석을 덮는 범위가 좁아졌어요 [1]. 논문은 다양성과 정렬이 서로를 붙잡는 "상호 닻" 역할을 한다고 정리해요. 실무로 옮기면 이 시스템의 다양성은 무한정 벌리는 쪽이 아닌, 원질문에서 벗어나지 않는 범위 안에서 벌리는 쪽으로 조율돼 있어요.
결과: 품질 점수는 오르고 지연은 12–20배 줄었다
R4T는 두 데이터셋, 두 기반 모델에서 제로샷 팬아웃과 Best-of-N 기준선보다 높은 점수를 냈어요 [1]. 데이터셋은 사용자가 꾸린 아웃핏 묶음인 Polyvore 패션 벤치마크와 전문가가 만든 음악 플레이리스트로 구성된 비공개 산업 데이터셋이에요 [1][5]. 후보 풀은 Polyvore가 과제 1에서 21,888개, 과제 2에서 142,472개, 음악이 8,522개였어요. 모든 팬아웃 방법은 하위 질의 10개를 만들었고, Best-of-N은 제로샷 팬아웃을 5번 돌려 보상이 가장 높은 것을 골랐어요.
| 방법 (Polyvore, Gemma3-4B) | 근거성 | 다양성 | 정렬 | 평균 |
|---|---|---|---|---|
| 팬아웃 없음 | 22.4 | 34.4 | 21.4 | 26.1 |
| 제로샷 팬아웃 | 28.4 | 56.0 | 31.2 | 38.5 |
| Best-of-N | 28.9 | 61.0 | 32.7 | 40.9 |
| R4T-FOLM | 30.8 | 76.8 | 39.8 | 49.1 |
| R4T-Diffusion | 해당 없음 | 74.3 | 37.6 | 해당 없음 |
표 2. 개방형 추상 검색(OAR) 과제의 Polyvore 결과 일부. LLM 심판이 매긴 점수이고, 확산 변형은 중간 하위 질의가 없어 근거성을 재지 않았어요 [1].
같은 과제에서 음악 데이터셋의 Gemma3-4B 평균은 제로샷 48.1, Best-of-N 49.2, R4T-FOLM 58.1이었어요 [1]. Qwen3-4B로 바꾸면 Polyvore 평균이 28.1, 30.4, 42.6 순이었어요. 팬아웃을 아예 하지 않는 기준선은 모든 조건에서 가장 낮았어요. 논문은 이를 "팬아웃은 필요하지만 충분하지 않다"로 요약해요. 질의 확장이 다양한 의미 측면을 더 덮는다는 오래된 가설은 확인됐고, 제로샷 팬아웃은 데이터베이스에서 벗어나거나 거의 같은 질의로 무너지는 약점을 보였어요.
약지도 조합 검색(WSCR) 과제에서는 커버리지와 다양성 사이의 교환이 드러났어요. Qwen 기반 R4T-FOLM은 Recall@5K 20.9, Hit@5K 64.6으로 커버리지가 가장 높았지만 Vendi Score는 27.5로 제로샷 Qwen(46.4)보다 낮았어요 [1]. 확산 변형은 Recall@5K 16.5, Hit@5K 57.5, Vendi 34.7로 그 사이에 있었어요. 참조 묶음과의 겹침을 보상으로 줄수록 결과가 소수의 지배적인 의미로 몰리는 경향이 보인 거예요. 논문은 참조 묶음이 유일한 정답이 아니므로 낮은 재현율이 곧 낮은 품질은 아니라고 덧붙여요.
| 배치 크기 | 자기회귀 언어모델 팬아웃 | 확산 모델 팬아웃 |
|---|---|---|
| 8 | 약 1.46초 | 0.07초 |
| 1024 | 약 50초 | 4.21초 |
표 3. 하위 질의 10개 분량의 팬아웃 생성 지연 시간. 확산 모델은 5,390만 파라미터이고, 논문은 배치 크기 전반에서 12–20배 속도 향상으로 요약해요 [1].
속도 수치는 정확히 읽어야 해요. 작은 배치에서는 1초 아래를 유지했지만, 배치 1024에서 확산 모델도 4.21초가 걸렸어요 [1]. "50초가 1초 아래로"는 과장이고, "같은 배치에서 한 자릿수 초로, 12–20배"가 논문이 실제로 보인 결과예요.
왜 확산 모델인가: 집합에는 순서가 없다
확산 모델을 고른 이유는 출력의 모양에 있어요. 자기회귀 생성은 하위 질의를 하나씩 순서대로 뱉어요. 텐트와 침낭 중 무엇이 먼저인지는 정해져 있지 않은데, 순차 생성은 없는 순서를 만들어 그 순서대로 출력해요. 확산 모델은 노이즈에서 출발해 묶음 전체를 동시에 다듬어 한 번에 내놓으니, 순서 없는 집합이라는 출력 구조와 맞아요 [1].
논문은 이 전환을 무거운 "시스템 2" 자기회귀 생성에서 가벼운 "시스템 1" 병렬 샘플링으로 옮기는 것이라고 표현해요 [1]. 확산 모델은 질의 임베딩을 교차 어텐션으로 받고, 확률 흐름 미분방정식을 풀어 임베딩 묶음을 만든 뒤, 각 임베딩을 최근접 이웃 검색으로 실제 항목에 연결해요. 12–20배 속도는 이 설계의 결과로 읽혀요. 목표는 "묶음 단위 속성을 프로덕션 지연 안에서 지키는 것"이었어요.
한계: 다양성이 검색에서도 옳은지는 보여주지 않았다
논문이 스스로 밝힌 한계는 네 가지예요 [1]. 첫째, 강화학습 단계가 고정 검색기와 반복 상호작용을 해야 해서 아주 크거나 자주 바뀌는 데이터베이스에서는 초기 학습 비용이 커요. 둘째, 원하는 속성을 스칼라 보상으로 쓸 수 있다고 가정해요. 창의성이나 문화적 민감도 같은 주관적 선호는 보상으로 옮기기 어려워요. 셋째, 개방형 과제의 품질을 LLM 심판으로 평가했으니 심판 모델의 편향이 섞일 수 있어요. 넷째, 특정 팬아웃 구조와 확산 검색기 하나로 실험해서 다른 기반 모델이나 임베딩 공간에서는 결과가 달라질 수 있어요.
우리가 보기에 더 큰 한계는 평가 영역이에요. 패션 아웃핏과 음악 플레이리스트에서 상호보완은 취향의 문제를 넘어 정답의 조건이에요. 상의 네 벌이 들어 있는 아웃핏은 심심한 아웃핏이 아니라 틀린 아웃핏이에요. 그러니 이 두 영역에서 다양성을 보상에 넣는 건 당연한 설계예요. 웹 검색이 그런 영역인지는 따로 보여야 하고, 이 논문은 그 주장을 하지 않아요.
사실을 묻는 질문을 생각하면 차이가 분명해져요. 서로 다른 말을 하는 문서 열 개보다 같은 말을 하는 믿을 만한 문서 세 개가 더 나은 답의 근거예요. 거기서는 중복이 곧 교차검증이고, 다양성 보상은 그 교차검증을 깎는 방향으로 작동해요. 다양성이 좋다는 전제가 평가 영역에 업혀 들어온 것인지 검색 일반에 성립하는 것인지는 이 결과만으로 구분되지 않아요.
세부 기록에도 확인할 점이 있어요. 본문은 LLM 심판을 Gemini-2.5-Pro로, 부록은 Gemini-2.5-Flash로 적고 있어요 [1]. 음악 데이터셋은 비공개라 외부에서 재현할 수 없고, 결론 문단은 패션 벤치마크만 언급해요. 다양성 점수와 근거성 점수를 매긴 것도 같은 계열의 LLM 심판이에요.
AEO/GEO 실무 함의: 내 카테고리의 좋은 답은 보완형인가 합의형인가
이 논문에서 가져갈 결론은 헤드라인보다 좁아요. "엔진이 다양성에 보상을 준다"까지는 말할 수 없어요. 정답이 서로 보완하는 집합이어야 하는 영역에서 검색 층이 그걸 명시적으로 강제하도록 만들어지고 있고, 그게 프로덕션 지연 안에 들어올 만큼 가벼워졌다는 것까지가 근거 있는 결론이에요.
그래도 방향 하나는 분명해요. 팬아웃이 집합 단위로 최적화되면 페이지 하나는 질문 하나와 대조되지 않아요. 서로 겹치지 않도록 일부러 벌려 놓은 질의 묶음과 대조되고, 그 묶음의 한 슬롯을 차지하거나 못 해요. 가장 흔한 표현 하나에만 답하는 글은 잘 써도 한 슬롯까지예요. 팬아웃이 실제 AI 검색에서 어떻게 관측되는지는 쿼리 팬아웃이란? AI가 질문 하나를 여러 검색으로 쪼개는 방식을 직접 관찰하기에, 하위 질의를 제목과 H2에 반영하는 방법은 쿼리 팬아웃 GEO 콘텐츠 전략에 정리해 뒀어요.
여기서 익숙한 콘텐츠 질문 하나가 실험 가능한 질문으로 바뀌어요.
- 내 카테고리의 좋은 답이 어떤 모양인지 먼저 정해요. 캠핑 장비 추천처럼 서로 보완하는 출처의 묶음이 좋은 답인 카테고리가 있고, 사실 확인처럼 같은 말을 하는 출처의 묶음이 좋은 답인 카테고리가 있어요.
- 보완형 카테고리라면 비슷한 글을 여러 개 두는 전략은 부채가 돼요. 같은 측면을 다루는 글이 늘어도 다양성으로 벌린 묶음에서는 한 슬롯만 다퉈요. 측면마다 다른 글을 두는 쪽이 묶음과 맞아요.
- 합의형 카테고리라면 중복 커버리지는 보험이 돼요. 여러 출처가 같은 사실을 확인해 주는 구조에서는 일관된 정보가 여러 곳에 있는 편이 교차검증 신호가 돼요.
- 가정하지 말고 재요. 같은 질문에 AI 답변이 인용하는 출처들이 서로 다른 측면을 덮는지, 같은 내용을 반복하는지는 관측할 수 있어요.
팬아웃을 둘러싼 도구와 측정 방식의 지형은 AI 검색 쿼리 팬아웃이란? 허브 쿼리를 찾고 콘텐츠를 바꾸는 법에서 이어서 볼 수 있어요. 이 논문이 보여준 것은 검색 층의 설계 방향이고, 그 설계가 내 카테고리에서 어느 쪽으로 작동하는지는 각자 재야 할 질문으로 남아요.
Frequently asked questions
R4T는 무엇을 하는 방법인가요?
넓은 질문 하나를 여러 하위 질의로 펴는 쿼리 팬아웃을 강화학습으로 먼저 학습하고, 그 행동을 5,390만 파라미터짜리 확산 모델에 옮겨 담는 3단계 방법이에요. 추론 시점에는 언어모델 대신 확산 모델이 질의 임베딩 하나에서 검색 방향 여러 개를 한 번에 만들어요.
다양성 보상은 왜 필요했나요?
논문 실험에서 근거성 보상만 주면 정책이 의미 없는 문자열로 무너졌고, 근거성과 원질문 정렬만 주면 원질문을 바꿔 말한 질의만 반복했어요. 다양성 항이 들어가야 이런 지름길이 막히고 학습이 안정됐어요.
이 결과를 웹 검색이나 AI 답변 인용에 그대로 적용해도 되나요?
아직은 안 돼요. 평가 과제가 패션 아웃핏과 음악 플레이리스트라서 상호보완이 정답의 조건인 영역이에요. 사실을 묻는 질문에서는 같은 말을 하는 믿을 만한 문서 여러 개가 교차검증이 되는데, 논문은 웹 검색이나 인용에 대한 결과를 내지 않았어요.
속도는 실제로 얼마나 빨라졌나요?
논문 그림 5 기준으로 배치 8에서 자기회귀 방식 약 1.46초가 확산 모델 0.07초로, 배치 1024에서 약 50초가 4.21초로 줄었어요. 논문은 이를 12–20배 속도 향상으로 요약해요. 큰 배치에서 1초 아래로 내려간 것은 아니에요.
References
- [1]Jiang, Li, Ryu et al., "Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion", arXiv 2603.06397 (ICML 2026)
- [2]Google Research Blog, "Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train" (2026-09-15)
- [3]ICML 2026 포스터 세션 페이지, "Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion"
- [4]Friedman & Dieng, "The Vendi Score: A Diversity Evaluation Metric for Machine Learning", arXiv 2022
- [5]Han, Wu, Jiang & Davis, "Learning Fashion Compatibility with Bidirectional LSTMs", ACM MM 2017 (Polyvore 데이터셋)
Summary
- 구글 리서치와 UIUC 연구진의 R4T는 강화학습으로 팬아웃 언어모델을 학습하고, 그 출력으로 학습 데이터를 합성한 뒤, 작은 확산 모델에 그 행동을 옮기는 3단계 구조예요.
- 보상은 근거성·다양성·원질문 정렬 세 항이고 기본 가중치는 0.6·0.2·0.2예요. 다양성은 Vendi Score로 쟀어요.
- 다양성 항을 빼면 정책이 무의미한 문자열이나 원질문의 바꿔 말하기로 무너졌다는 절제 실험이 이 설계의 근거예요.
- 확산 모델은 질의 10개 분량의 검색 방향을 한 번에 내놓아 배치 크기에 따라 12–20배 빨랐고, 품질 점수도 기준선보다 높았어요.
- 평가 영역이 아웃핏과 플레이리스트라서, 다양성 보상이 사실형 웹 검색에서도 옳은지는 이 논문으로 판단할 수 없어요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility