강화학습 정렬의 한계는 어디인가, 학습 전에 계산하는 보상의 천장
KL 제약 안에서 정렬로 얻을 최대 보상을 베이스 모델 샘플만으로 계산하고, 그 천장에 Best-of-N은 붙고 PPO와 GRPO는 아래에 머문 Apple 연구 읽기
KL 제약 안에서 강화학습으로 얻을 수 있는 보상의 최대치는 학습을 돌리기 전에 베이스 모델 샘플만으로 계산되고, 그 천장에 Best-of-N은 98% 이상 붙은 반면 PPO와 GRPO는 안전 정렬 기준 77%와 75%에 머물렀어요 [1]. Apple 연구진이 KL 정규화 정렬의 최적 보상 이득을 제프리스 발산으로 닫힌 형태로 풀고, 그 식을 베이스 모델의 공분산으로 바꿔 학습 전에 추정하는 방법을 제시한 논문이에요 [1]. 보상 해킹이 왜 생기고 보상 모델 앙상블이 왜 먹히는지도 같은 틀에서 증명했어요 [1].
이 글은 arXiv에 올라온 원문의 본문과 정리, 부록의 표를 2026년 10월에 읽고 숫자를 하나씩 대조해 정리한 글이에요 [1]. 실험에 쓰인 모델과 데이터는 공개 자산이지만 우리가 직접 돌려 보거나 재현하지는 않았고, 저자들과 이해관계도 없어요.
강화학습 정렬의 한계는 어디인가요
최적으로 정렬된 모델이 베이스 모델보다 더 얻는 보상은 KL 벌점 λ에 두 모델 사이의 제프리스 발산을 곱한 값이에요 [1]. 출발점은 RLHF 계열이 공통으로 푸는 KL 정규화 문제예요. 보상 모델 이 답 에 점수를 매기고, 베이스 모델 에서 너무 멀어지지 않도록 KL 발산에 벌점을 붙여요 [1].
이 문제의 해는 닫힌 형태로 알려져 있어요. 베이스 모델의 확률에 보상의 지수를 곱해 다시 정규화한 분포예요 [1].
여기서 는 KL 벌점의 세기, 는 정규화 상수예요. 이 해가 얻는 보상 이득이 얼마인지는 그동안 상한으로만 알려져 있었어요. Gao 등은 보상 이득이 KL의 제곱근에 대략 비례한다는 경험 법칙을 보고했고 [2], Mroueh와 Nitsure는 보상이 서브가우시안이라는 가정 아래 그 제곱근 식이 상한임을 증명했어요 [3]. 이 논문의 정리 1은 가정 없이 등식을 줘요 [1].
여기서 는 제프리스 발산, 곧 순방향 KL과 역방향 KL의 합이에요. 보상 이득은 "베이스에서 얼마나 멀리 갔는가"를 양방향으로 잰 양에 벌점 λ를 곱한 값이고, 한쪽 방향 KL의 제곱근으로는 설명되지 않아요 [1].
정렬로 얻을 보상을 학습 전에 계산할 수 있나요
있어요. 정리 1의 우변은 정렬된 모델이 있어야 계산되지만, 같은 양을 베이스 모델의 공분산으로 다시 쓰면 정렬된 모델 없이 계산돼요 [1]. 정리 2는 평가에 쓰는 보상 과 학습에 쓰는 보상 을 구분해 두 경우를 한 식으로 다뤄요 [1].
여기서 는 베이스 모델에서 뽑은 답들에 대한 공분산이고, 둘째 인자는 답마다 붙는 지수 가중치예요. 최적 정렬은 베이스 모델이 이미 만들 수 있는 답들 가운데 보상이 높은 쪽에 가중치를 더 주는 재가중이고, 그래서 베이스 샘플과 보상 점수만 있으면 재가중이 얼마나 보상을 올릴지 미리 보여요.
이 공분산을 몬테카를로로 추정하는 식(정의 1)과 같은 재료로 KL 발산을 추정하는 식(정의 2)이 따라오고, 둘 다 샘플 수가 늘면 참값으로 수렴한다는 것이 증명돼 있어요 [1]. 논문 실험에서는 질문당 1,000개 안팎의 베이스 샘플에서 보상 이득 추정치가 수렴했고, λ가 작을수록 지수 가중치의 분산이 커져 수렴이 느렸어요 [1]. λ를 0.01부터 10까지 바꿔 가며 계산하면 KL 예산별 최대 보상, 곧 파레토 곡선 전체가 학습 전에 나와요 [1].
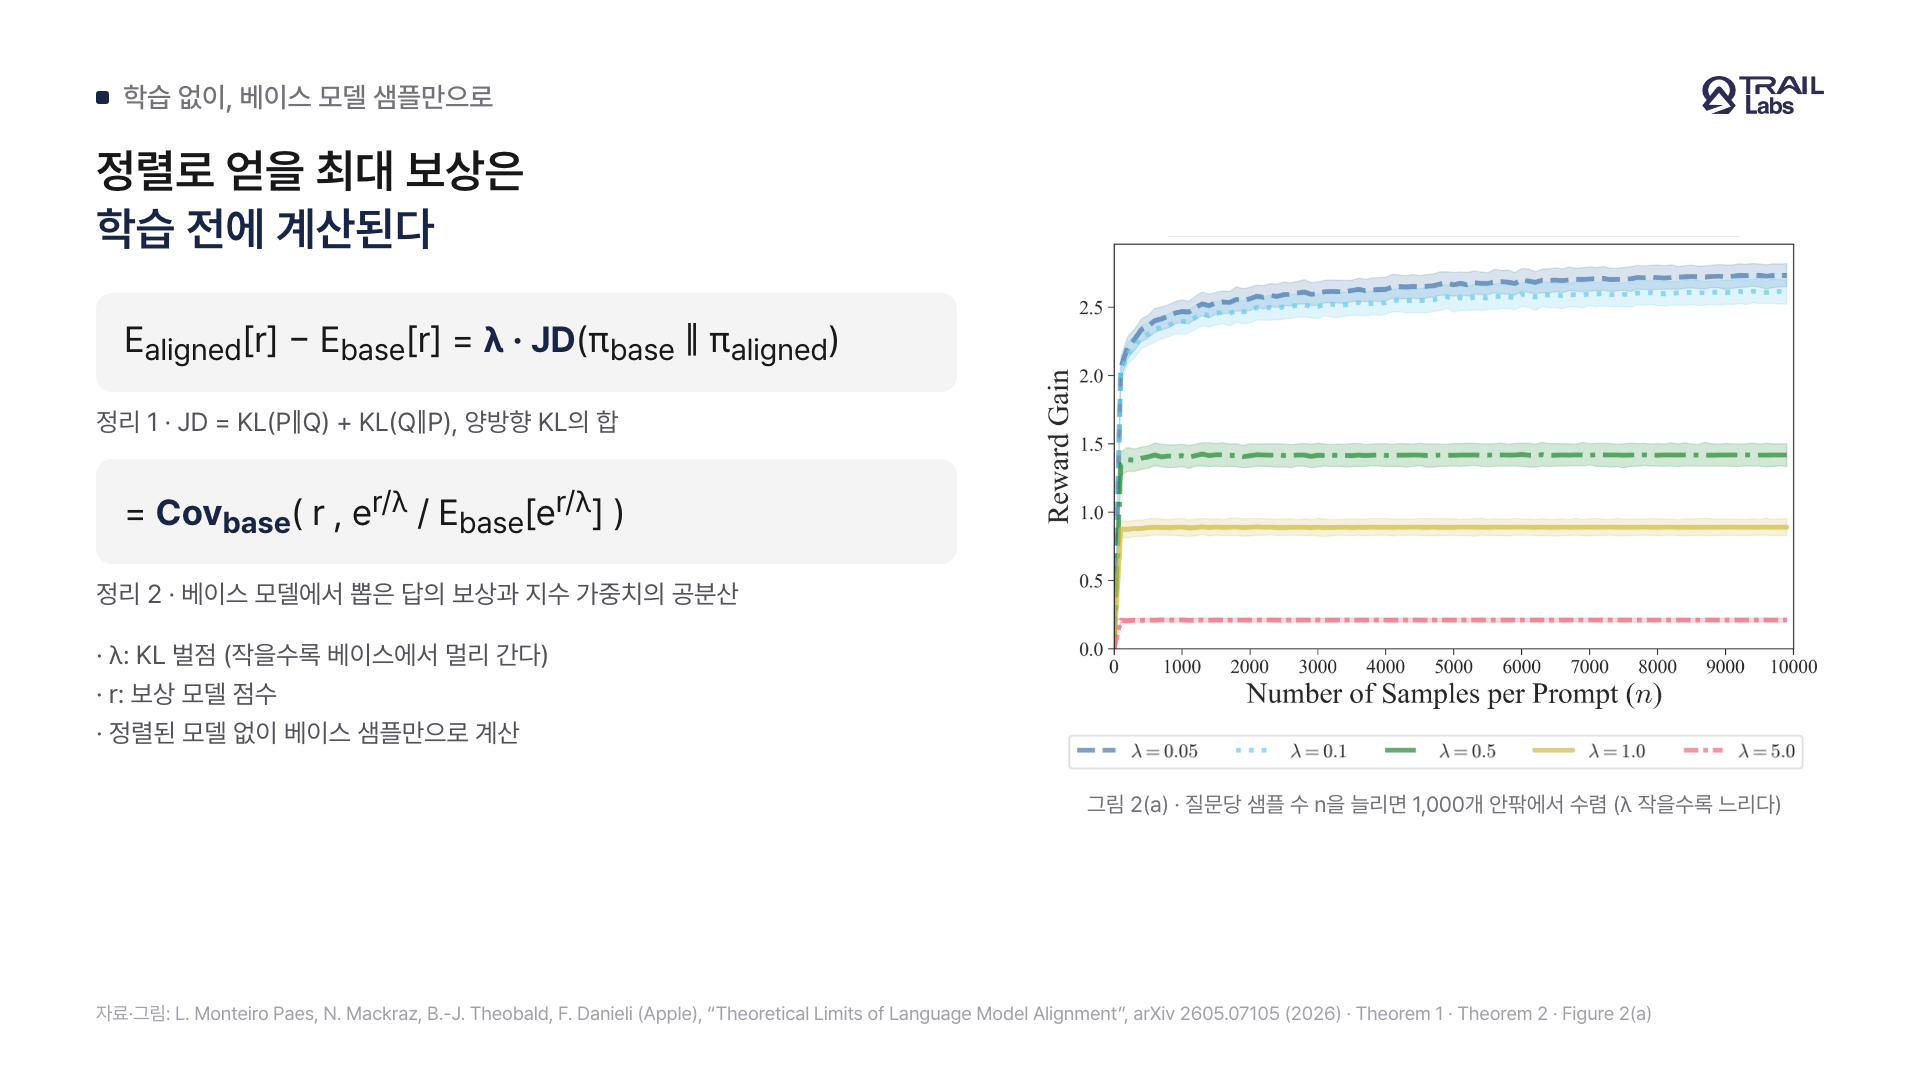
그림 1. 정렬로 얻을 최대 보상은 베이스 모델 샘플의 공분산으로 학습 전에 계산되고, 추정치는 샘플 수가 늘면 수렴해요 [1].
PPO와 GRPO는 왜 Best-of-N보다 보상이 낮은가요
두 과제 모두에서 Best-of-N은 천장 곡선에 거의 붙었고, PPO와 GRPO는 모든 KL 구간에서 그 아래에 머물렀어요 [1]. 실험은 안전 정렬과 요약 두 가지예요. 안전 과제는 Zephyr-7B(Mistral-7B를 UltraChat으로 지도 미세조정한 모델)를 베이스로, PKU-SafeRLHF 선호 데이터로 학습한 Zephyr-7B 기반 보상 모델을 썼어요 [1]. 요약 과제는 Reddit TL;DR 데이터에 지도 미세조정한 Pythia-1B를 베이스로, 같은 데이터의 선호로 학습한 Pythia-1B 보상 모델을 썼어요 [1]. 비교 대상은 PPO, GRPO, Best-of-N 세 가지이고, 명시적 보상 모델을 쓰지 않는 DPO는 제외했어요 [1]. PPO와 GRPO는 하이퍼파라미터를 폭넓게 바꿔 본 뒤 KL 대비 보상이 가장 좋은 실행을 본문에 실었고, Best-of-N은 N을 1부터 10,000까지 바꾸며 Beirami 등의 추정식으로 KL을 계산했어요 [1][4].
| 과제 | 이론 천장 | Best-of-N | GRPO | PPO |
|---|---|---|---|---|
| 안전 (Zephyr-7B · BeaverTails) | 2.764 | 2.722 | 2.117 | 2.084 |
| 요약 (Pythia-1B · TL;DR) | 0.387 | 0.385 | 0.282 | 0.187 |
표 1. 이론 천장이 계산된 KL 범위(안전 9.14 이하, 요약 7.96 이하) 안에서 각 방법이 낸 최대 보상 이득이에요 [1]. GRPO와 PPO는 본문 그림에 쓰인 실행의 값이고, 요약 과제의 PPO는 더 높은 두 실행이 잡음 때문에 제외됐어요 [1].
표 1의 값으로 비율을 계산하면 Best-of-N은 천장의 98.5%와 99.5%, GRPO는 76.6%와 72.9%, PPO는 75.4%와 48.3%예요 [1]. 저자들은 GRPO와 PPO가 모든 KL 예산에서 천장 아래에 머문 것을 현재 RL 방법의 구조적 한계로 읽고, 높은 추론 비용 없이 최적에 닿으려면 알고리즘 개선이 필요하다고 적었어요 [1]. 왜 경사 기반 방법이 최적 재가중에 못 미치는지에 대한 원인 분석은 논문에 없어요.
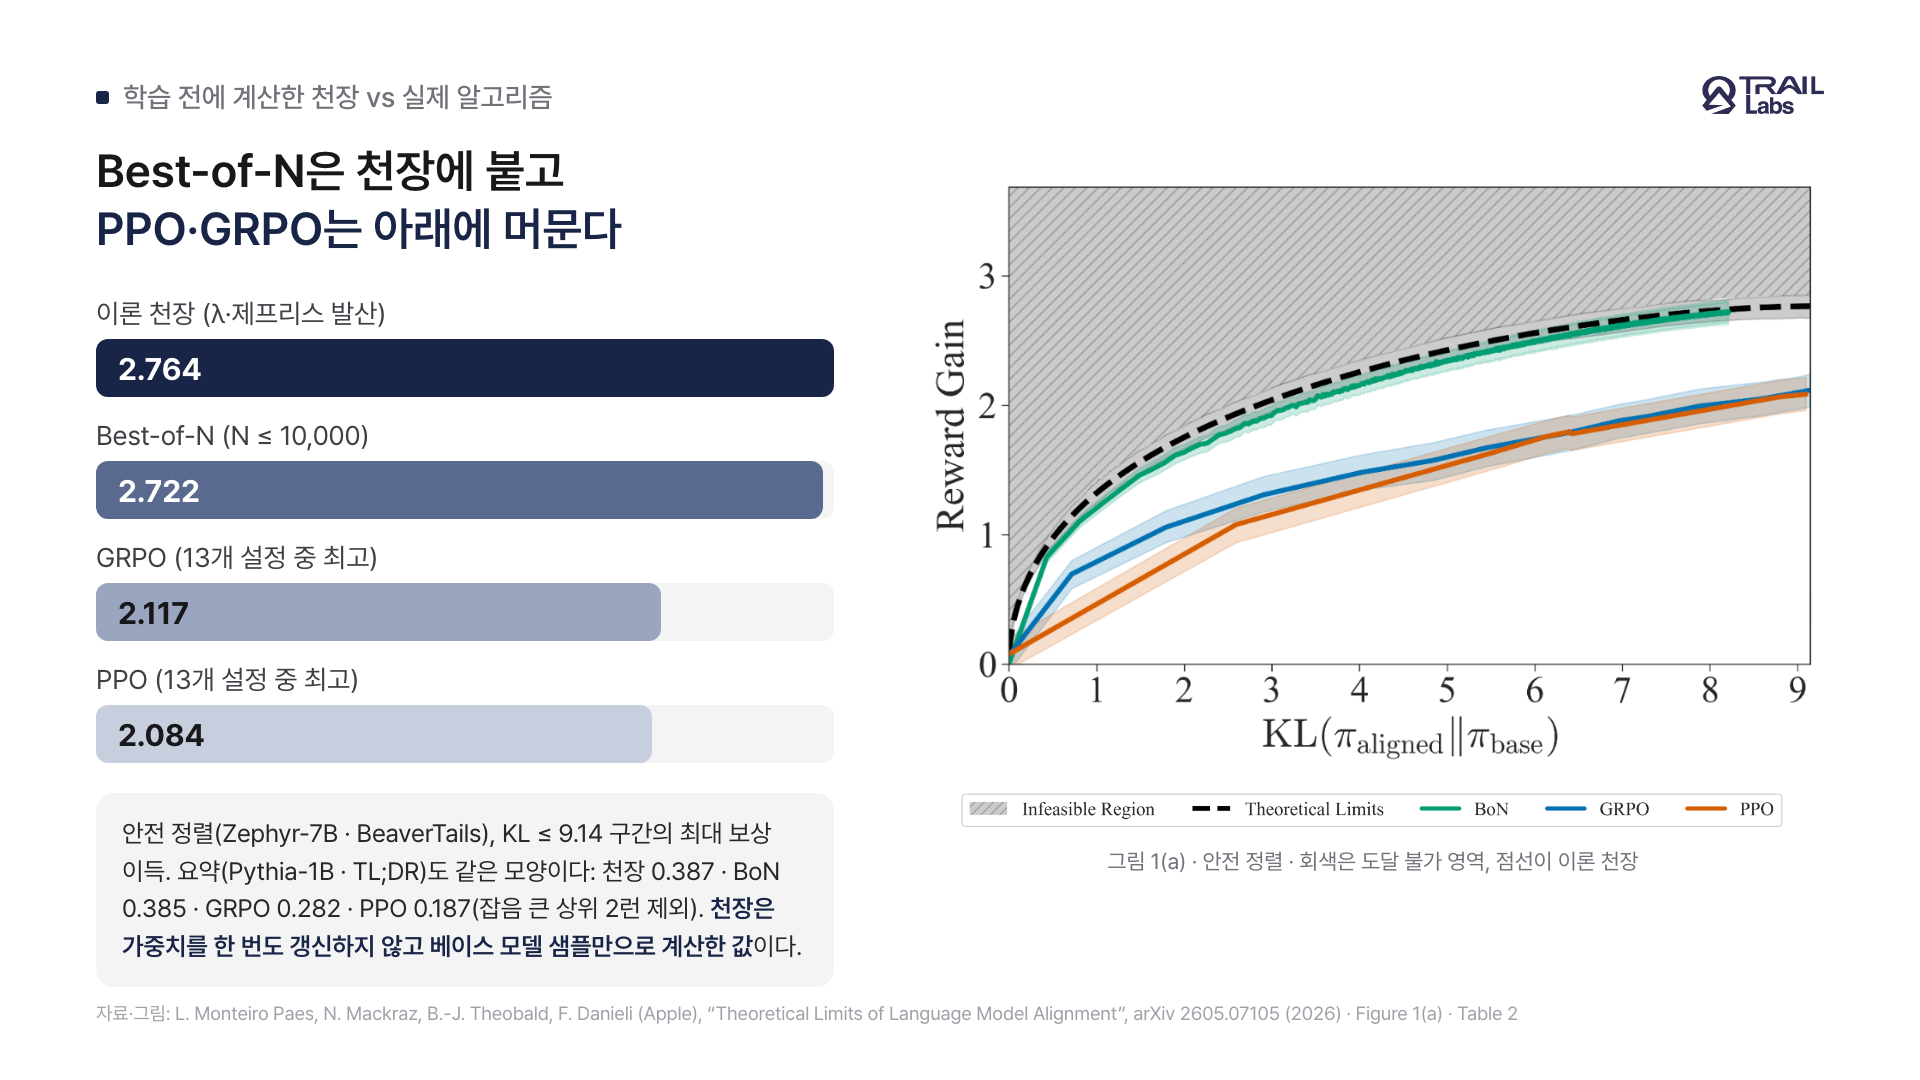
그림 2. 안전 정렬에서 Best-of-N은 점선 천장에 붙고 GRPO와 PPO는 모든 KL 구간에서 아래에 머물러요 [1].
부록의 스윕에서도 격차는 그대로였어요. 안전 과제에서 GRPO의 β, 학습률, 생성 수를 13가지로 바꿨을 때 최대 보상 이득은 1.886에서 2.117 사이, 천장 아래 같은 띠에 모였고, PPO 13가지는 0.918에서 2.084 사이에 흩어졌지만 모두 천장 아래였어요 [1].
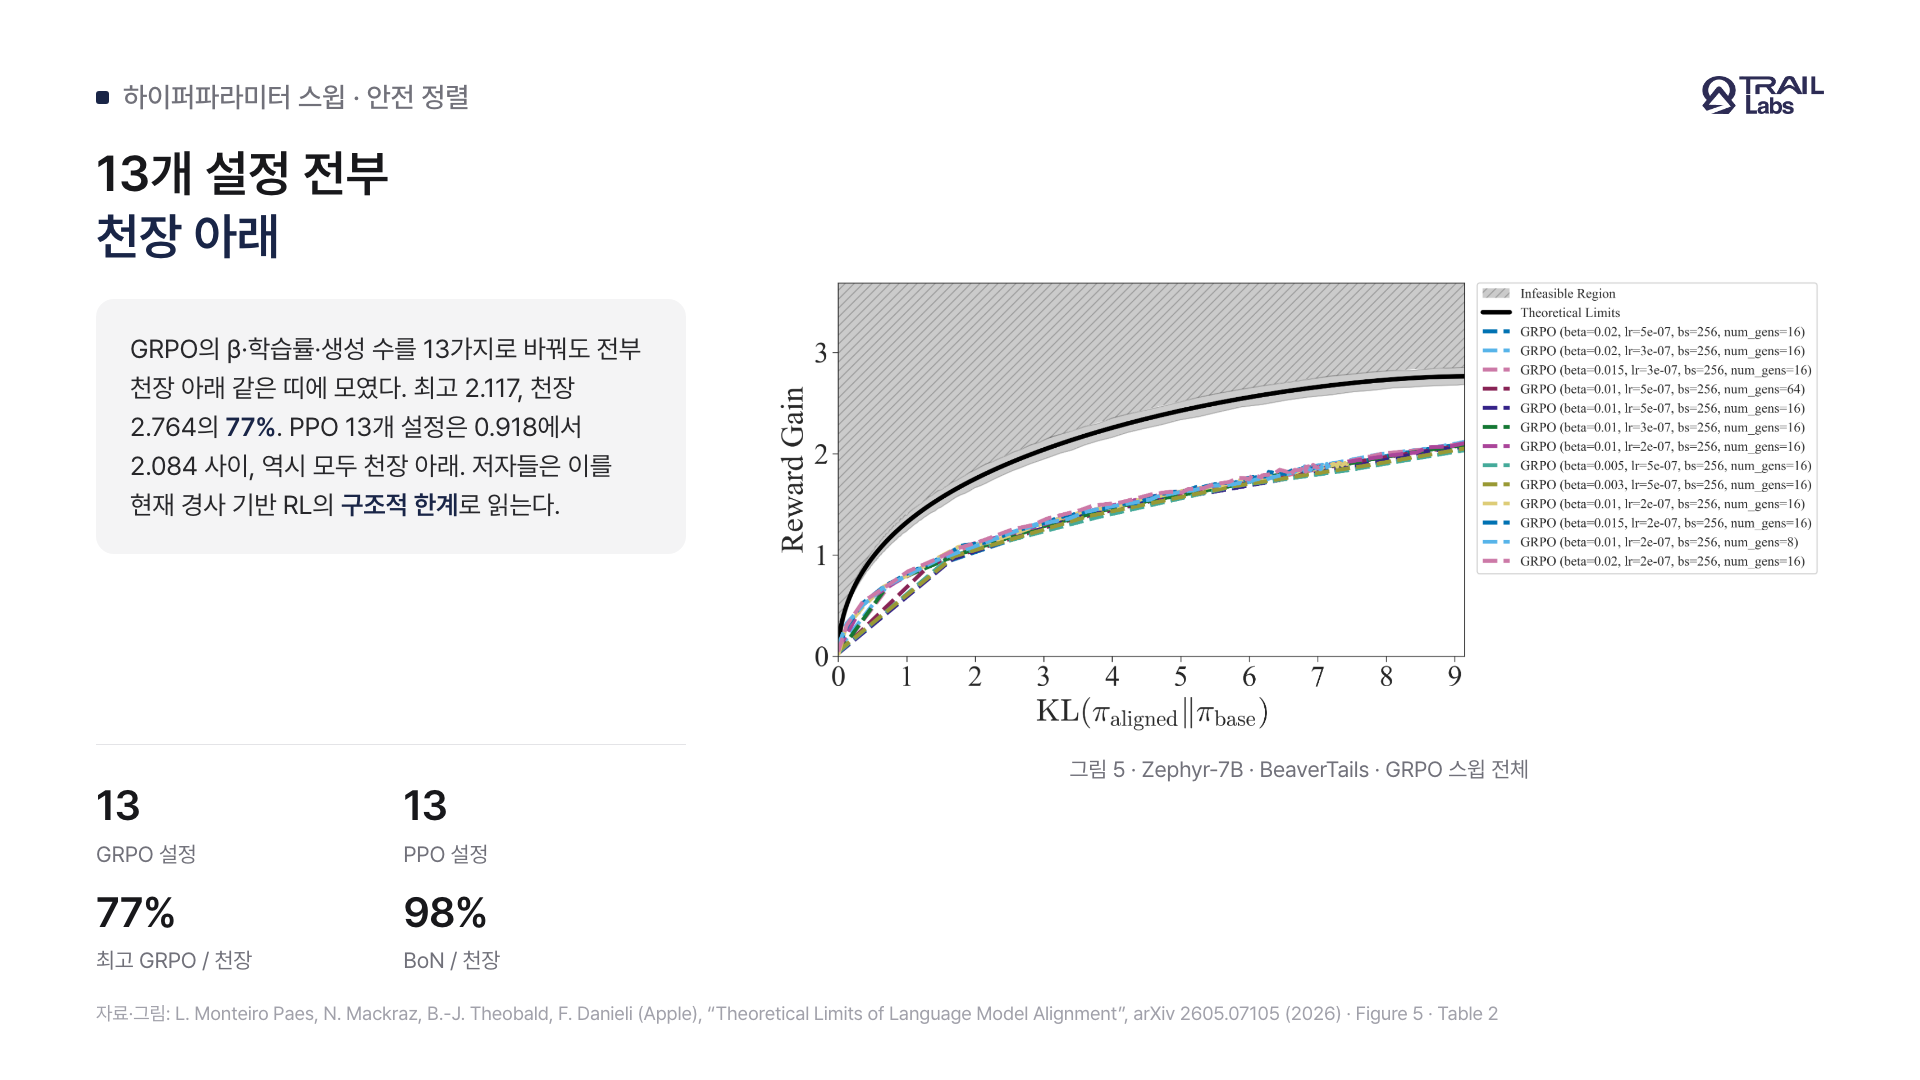
그림 3. GRPO 하이퍼파라미터 설정 전부가 천장 아래 같은 띠에 모여요 [1].
보상 해킹은 왜 생기고 앙상블은 왜 효과가 있나요
보상 해킹은 프록시 보상의 오차가 KL 벌점 λ로 나뉘어 지수 안에 들어가기 때문에 생겨요 [1]. 실제 학습에 쓰는 보상 모델 은 사람 선호를 완벽히 반영하는 진짜 보상 의 근사이고, 둘의 차이 를 논문은 선호 잔차라고 불러요 [1]. 명제 3은 진짜 보상으로 정렬한 모델과 프록시로 정렬한 모델 사이의 진짜 보상 격차를 공분산으로 쓰고, 그 안에 항이 들어 있음을 보여요 [1]. λ를 줄여 베이스에서 멀리 갈수록 같은 크기의 오차가 지수적으로 증폭되고, 이것이 Gao 등이 관찰한 과최적화 곡선의 설명이에요 [1][2].
같은 틀에서 보상 모델 앙상블의 효과도 증명돼요. 명제 4는 프록시로 정렬했을 때의 손실이 프록시와 진짜 보상의 거리에 비례해 묶인다는 립시츠 꼴의 상한이고, 정리 3은 독립적으로 학습한 보상 모델 n개를 평균하면 정렬 결과의 진짜 보상이 n의 제곱근에 반비례하는 속도로 이상적인 값에 수렴한다는 결과예요 [1]. Coste 등이 경험적으로 보고한 앙상블 효과에 이론적 근거가 붙은 셈이에요 [5]. 단, 각 보상 모델이 평균적으로 진짜 보상과 같다는 비편향 가정이 들어가요 [1].
부록 C는 보상 모델을 학습하는 방식까지 짚어요. 지금의 보상 모델은 대부분 브래들리-테리 손실로 학습하는데, 이 손실은 "어느 답이 더 좋은가"의 순서만 맞추고 "얼마나 더 좋은가"는 제약하지 않아요 [1]. 그래서 손실을 완벽히 최소화해도 선호 잔차는 얼마든지 커질 수 있어요 [1]. 저자들이 든 예는 도움 되는 답과 안전한 거절처럼 서로 다른 묶음 안에서만 비교가 이뤄지는 데이터예요. 묶음 사이의 점수 차이는 손실에 나타나지 않아 임의로 벌어질 수 있고, 그 차이가 명제 3의 지수 항을 키워요 [1]. 선호의 강도를 함께 학습하는 보상 모델링이 필요하다는 것이 저자들의 제안이에요 [1].
이 연구의 한계는 무엇인가요
저자들이 밝힌 한계는 세 가지예요. 결과는 KL 정규화 목적 함수의 최적해에 대한 것이라 f-발산 정규화, 승률 최대화, 토큰 단위 KL 같은 다른 목적 함수에는 그대로 적용되지 않아요 [1]. 추정기는 λ가 작은 구간에서 수렴이 느려요 [1]. 보상 해킹과 앙상블 분석은 프록시 보상이 평균적으로 편향이 없다는 가정에 기대고, 체계적 편향의 영향은 다루지 않았어요 [1].
우리가 읽으며 더한 한계도 있어요. 실험은 Zephyr-7B와 Pythia-1B 두 조합, 단일 턴 과제 두 개에서만 이뤄졌고, 다중 턴 에이전트나 코딩 과제는 없어요 [1]. 보상 이득은 학습에 쓴 보상 모델 자체로 쟀기 때문에, 천장에 붙었다는 말이 사람 평가 기준의 품질이 가장 높다는 뜻은 아니에요. Best-of-N의 KL 값은 추정식으로 계산한 값이에요 [1][4]. PPO와 GRPO는 저자들이 돌린 스윕의 최고 실행이라, 다른 구현이나 더 큰 모델에서 격차가 어떻게 변하는지는 열려 있어요. arXiv 프리프린트라 동료심사는 확인되지 않았어요.
이 결과를 어떻게 쓰나요
학습을 돌리기 전에 천장을 재는 것이 첫 쓰임이에요. 베이스 모델에서 질문당 1,000개 안팎의 답을 뽑아 보상을 매기면 KL 예산별로 얻을 수 있는 최대 보상이 나오고, 목표 보상에 필요한 KL 예산도 역으로 읽혀요 [1]. 우리 해석으로는, 천장이 낮으면 알고리즘보다 베이스 모델이나 보상 모델 쪽이 제약이에요.
둘째는 막혔을 때 볼 곳을 좁히는 거예요. 천장은 베이스 샘플로 추정할 수 있고, 실제 실행과 천장 사이의 격차는 같은 축에 찍어 보면 그대로 보여요 [1]. 프록시 보상의 잔차는 진짜 보상이 있어야 계산되기 때문에 직접 재지는 못하지만, λ를 줄일수록 지수적으로 커진다는 방향과 앙상블이라는 완화책은 식으로 주어져요 [1].
셋째는 Best-of-N을 기준선으로 두는 거예요. 논문 실험 기준으로 Best-of-N은 천장에 붙었으므로, 새 알고리즘의 성과는 Best-of-N과의 거리로 읽으면 돼요 [1]. 저자들은 높은 추론 비용 없이 최적에 닿는 알고리즘 개선을 남은 과제로 적었어요 [1].
Frequently asked questions
강화학습으로 언어 모델을 정렬할 때 성능 한계는 어디인가요?
KL 제약 아래에서 최적으로 정렬된 모델이 얻는 보상 이득은 KL 벌점 λ에 베이스 모델과 정렬된 모델 사이의 제프리스 발산(양방향 KL의 합)을 곱한 값이에요. 이전에는 보상 이득이 KL의 제곱근에 비례한다는 상한만 있었는데, 이 연구는 보상 분포에 가정을 두지 않고 등식으로 풀었어요.
정렬로 얻을 보상을 학습 전에 계산할 수 있나요?
있어요. 같은 이득을 베이스 모델에서 뽑은 답의 보상과 지수 가중치 사이의 공분산으로 다시 쓰면 정렬된 모델이 없어도 계산돼요. 논문 실험에서는 질문당 1,000개 안팎의 베이스 샘플에서 추정치가 수렴했고, λ를 바꿔 가며 계산하면 KL과 보상의 파레토 곡선 전체가 학습 전에 나와요.
PPO와 GRPO는 왜 Best-of-N보다 보상이 낮은가요?
논문 실험 기준으로 Best-of-N은 두 과제 모두에서 이론 천장의 98% 이상에 붙었고, GRPO는 안전 과제에서 77%, 요약 과제에서 73%, PPO는 75%와 48%에 머물렀어요. 안전 과제의 GRPO 13가지 설정은 천장 아래 같은 띠에 모였고, 저자들은 이를 현재 경사 기반 RL의 구조적 한계로 읽어요. 왜 그런지에 대한 원인 분석은 논문에 없어요.
보상 해킹은 왜 생기고 보상 모델 앙상블은 왜 효과가 있나요?
프록시 보상과 진짜 보상의 차이(선호 잔차)가 λ로 나뉘어 지수 안에 들어가기 때문이에요. λ를 줄여 베이스에서 멀리 갈수록 작은 오차가 지수적으로 커져요. 독립적으로 학습한 보상 모델 n개를 평균하면 오차가 n의 제곱근에 반비례해 줄어든다는 것도 같은 틀에서 증명됐어요. 단, 각 보상 모델이 평균적으로 편향이 없다는 가정이 붙어요.
References
- [1]Lucas Monteiro Paes, Natalie Mackraz, Barry-John Theobald, Federico Danieli (Apple), "Theoretical Limits of Language Model Alignment", arXiv 2026
- [2]Leo Gao, John Schulman, Jacob Hilton, "Scaling Laws for Reward Model Overoptimization", ICML 2023
- [3]Youssef Mroueh, Apoorva Nitsure, "Information Theoretic Guarantees for Policy Alignment in Large Language Models", TMLR 2025
- [4]Ahmad Beirami et al., "Theoretical Guarantees on the Best-of-n Alignment Policy", ICML 2025
- [5]Thomas Coste, Usman Anwar, Robert Kirk, David Krueger, "Reward Model Ensembles Help Mitigate Overoptimization", ICLR 2024
Summary
- Apple 연구진이 KL 정규화 정렬의 최적 보상 이득을 λ 곱하기 제프리스 발산으로 닫힌 형태로 풀어, 이전의 제곱근 상한을 등식으로 바꿨어요.
- 그 식을 베이스 모델 샘플의 공분산으로 다시 써서, 학습을 돌리지 않고 KL과 보상의 파레토 곡선 전체를 추정하는 방법을 제시했고 질문당 1,000개 안팎의 샘플에서 수렴했어요.
- 안전과 요약 두 과제에서 Best-of-N은 천장의 98% 이상에 붙었고, GRPO는 77%와 73%, PPO는 75%와 48%에 머물렀으며 안전 과제의 GRPO 13가지 설정도 천장 아래 같은 띠에 모였어요.
- 보상 해킹은 프록시 보상 오차가 λ로 나뉘어 지수 안에 들어가기 때문에 생기고, 보상 모델 앙상블은 오차를 n의 제곱근에 반비례해 줄인다는 것이 같은 틀에서 증명됐어요.
- 두 모델·데이터 조합의 단일 턴 과제에서만 쟀고, 보상 이득을 학습에 쓴 보상 모델로 쟀으며, 프리프린트라 동료심사는 확인되지 않았어요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility