DeepSeek V4.1 Flash 해부, KV 캐시는 줄고 사후학습 레시피는 그대로
기술 보고서 51쪽을 읽고 이전 모델과 무엇이 달라졌는지 구조·추론 비용·학습 방법으로 나눠 정리했어요
DeepSeek V4.1 Flash는 이전 V4-Flash보다 두 배 가까이 큰 모델인데도 토큰당 KV 캐시를 4분의 1로 줄였고, 사후학습은 SFT, 강화학습(RL), 온폴리시 증류(OPD)로 이어지는 V4 레시피를 알고리즘 수정 없이 그대로 썼어요 [1]. 구조와 추론 비용, 사전학습 데이터는 크게 바뀌었고, 사후학습 방법은 그대로 둔 채 데이터와 환경을 키운 버전이에요 [1]. 보고서는 사후학습이 잘 알려진 관행을 넘는 수정 없이 진행됐고 "실질적인 변화는 모두 데이터 파이프라인에 있다"고 적었어요 [1].
이 글은 Hugging Face에 공개된 기술 보고서 원문 51쪽을 2026년 10월에 읽고 본문, 표, 그림의 숫자를 하나씩 대조해 정리했어요 [1]. 그림은 보고서에서 그대로 가져왔어요(MIT 라이선스). 모델을 직접 돌려 재현하지는 않았고, DeepSeek과 이해관계는 없어요. 벤치마크 점수는 모두 DeepSeek의 자체 보고 값이에요.
DeepSeek V4.1 Flash는 이전 모델과 무엇이 다른가요
크기는 커졌는데 한 번에 쓰는 부분과 기억하는 양은 줄었어요 [1]. 보고서 표 1 기준으로 V4.1 Flash의 본체 파라미터는 552B로 V4-Flash(284B)의 두 배 가까이 되지만, 토큰 하나를 처리할 때 실제로 쓰는 파라미터는 입력 처리(prefill) 때 8B, 답을 생성(decode)할 때 16B예요 [1]. V4-Flash는 13B, 더 큰 V4-Pro는 49B를 썼어요 [1].
| 항목 | V4-Flash | V4-Pro | V4.1-Flash |
|---|---|---|---|
| 본체 파라미터 | 284B | 1.6T | 552B |
| 토큰당 활성 파라미터 | 13B | 49B | 8B(입력) / 16B(생성) |
| 토큰당 전역 KV 캐시 | 3,514바이트 | 보고서 미기재 | 890바이트 |
| 입력 형태 | 텍스트 | 텍스트 | 텍스트와 이미지를 처음부터 함께 학습 |
표 1. 보고서 표 1과 그림 1(b)의 값을 옮겼어요 [1]. V4.1 Flash는 이 밖에 196B 크기의 Engram 메모리 파라미터를 따로 가져요.
여기서 KV 캐시는 모델이 앞서 읽은 토큰을 다시 계산하지 않으려고 층마다 저장해 두는 중간 결과예요. 에이전트가 도구를 수십 번 부르며 긴 대화를 이어 가면, 새로 생성하는 글자보다 다시 읽어야 하는 입력이 훨씬 많아져요 [1]. 보고서는 이 상황에서 비용을 막는 것이 연산보다 KV 캐시의 저장 공간과 전송 대역이라고 보고, 모델 전체를 그 병목에 맞춰 다시 설계했어요 [1].
세대별로 보면 줄어든 폭이 커요. 토큰당 전역 KV 캐시는 V1(2023년 11월) 389,120바이트, V3.2(2025년 12월) 48,068바이트, V4-Flash(2026년 4월) 3,514바이트, V4.1-Flash(2026년 9월) 890바이트예요 [1]. V1 대비 437분의 1이에요 [1].
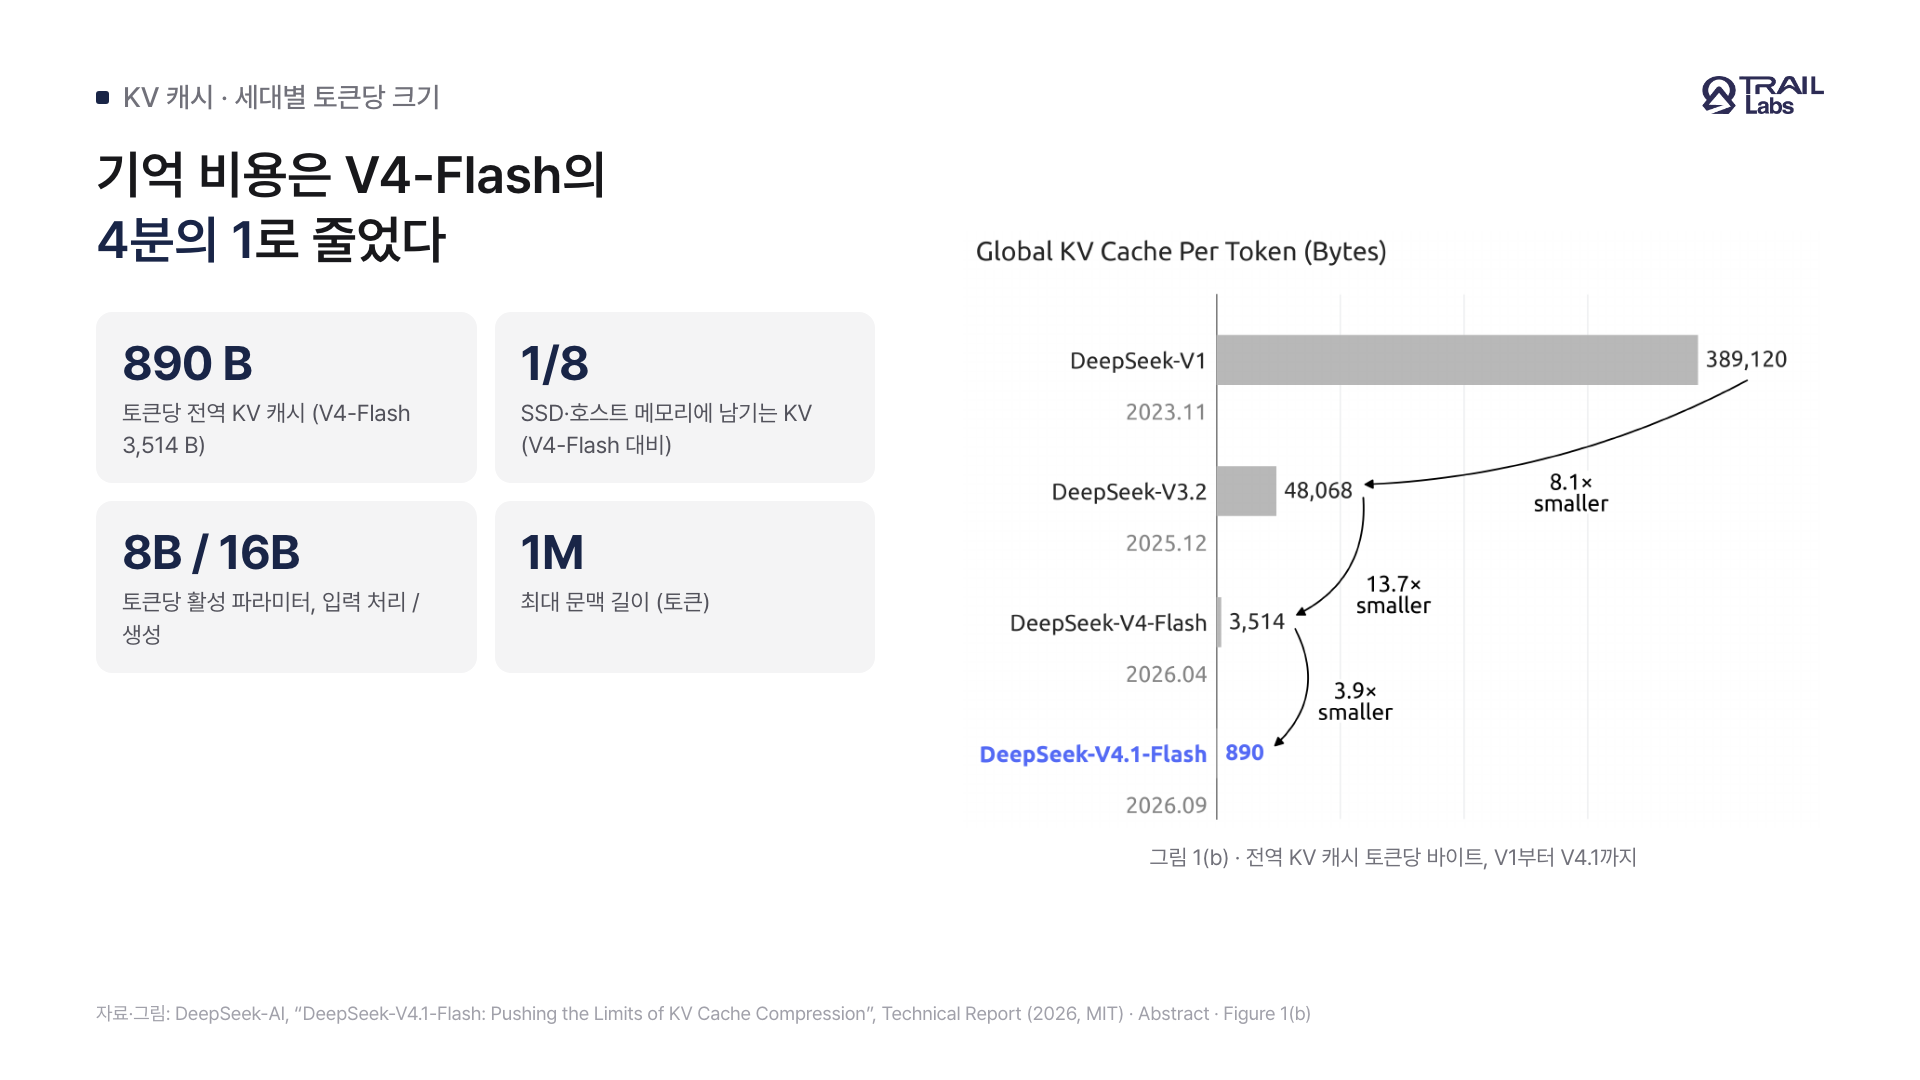
그림 1. 토큰당 전역 KV 캐시가 V4-Flash의 3,514바이트에서 890바이트로 줄었어요 [1].
DeepSeek V4.1은 KV 캐시를 어떻게 줄였나요
네 가지 장치를 겹쳐서 줄였어요. 층 수, 층 간 공유, 저장 정밀도, 다시 계산하는 범위를 각각 건드렸어요 [1].
인과 인코더-디코더(CED). 40개 층을 아래 20층 인코더와 위 20층 디코더로 나누고, 디코더 층의 전역 KV를 각자의 은닉 상태가 아니라 인코더 마지막 층의 은닉 상태에서 바로 투영해 만들어요 [1]. YOCO의 아이디어를 발전시킨 구조라고 보고서가 밝혀요 [1][2].
여기서 은 층 수(40), 는 20번째 층(인코더 마지막 층)의 은닉 상태, 과 은 디코더 번째 층이 쓸 KV와 압축 가중치예요. 입력을 처리할 때 인코더 20층만 끝까지 계산하면 디코더 KV가 나오니, 입력 처리 연산이 약 절반으로 줄어요 [1]. 입력 처리 때 활성 파라미터가 8B로 생성 때(16B)의 절반인 이유가 이 구조예요 [1].
CSA2의 세 가지 모드. V4는 압축 희소 어텐션(CSA)과 강한 압축 어텐션(HCA)을 섞어 썼는데, V4.1은 이를 CSA2 하나로 정리했어요 [1]. 각 층은 Full, Reindex, Reuse 셋 중 하나로 고정돼요. Full은 자기 KV를 만들고 읽을 위치를 직접 고르고, Reindex는 앞 층의 KV를 빌려 읽을 위치만 새로 고르고, Reuse는 KV와 고른 위치를 둘 다 앞 층 것을 그대로 써요 [1]. 인코더는 6개 층마다 Full 1개에 Reuse 5개, 디코더는 4개 층마다 Full 또는 Reindex 1개에 Reuse 3개라, 대부분의 층이 KV를 따로 저장하지 않아요 [1]. 디코더에서는 첫 Full 층이 후보 위치 최대 16,384개를 미리 추려 두고, 뒤쪽 Reindex 층들은 그 안에서만 읽을 위치를 골라 선택 비용이 문맥 길이와 무관해져요. 첫 Full 층은 여전히 전체 문맥을 채점해요 [1].
FP4 KV 캐시. 주 KV를 4비트(E2M1, 16채널마다 E4M3 스케일 1개)로 저장해, V4의 8비트 저장 대비 공간이 약 절반이 됐어요 [1]. 사후학습 단계에서 양자화를 미리 반영해 학습했고, 정밀도에 민감한 로컬 창 KV는 8비트로 남겼어요 [1].
SWA Bounded Replay. 모든 층에는 최근 128토큰만 보는 로컬 창 어텐션(SWA)이 함께 있어요 [1]. V4는 이 로컬 KV까지 SSD에 저장해 두었고, 저장 공간의 절반 가까이를 차지했어요 [1]. V4.1은 로컬 KV를 SSD 영구 캐시에서 빼서 각 서버 호스트 메모리의 10%로 만든 풀에 몇 분만 두고, 풀에서 놓친 경우에만 최근 128토큰을 다시 계산해 근사적으로 복원해요 [1]. 정확히 복원하려면 층 수 × 128토큰을 다시 계산해야 하지만, 실제 영향 범위가 그보다 훨씬 좁다는 선행 관찰을 근거로 범위를 잘랐고, 보고서는 품질 저하가 무시할 수준이었다고 적었어요 [1]. 로컬 KV를 빼서 절반, 전역 KV가 4분의 1로 줄어든 효과가 곱해져, 오래 저장해 두는 KV가 V4-Flash의 8분의 1이 됐어요 [1].
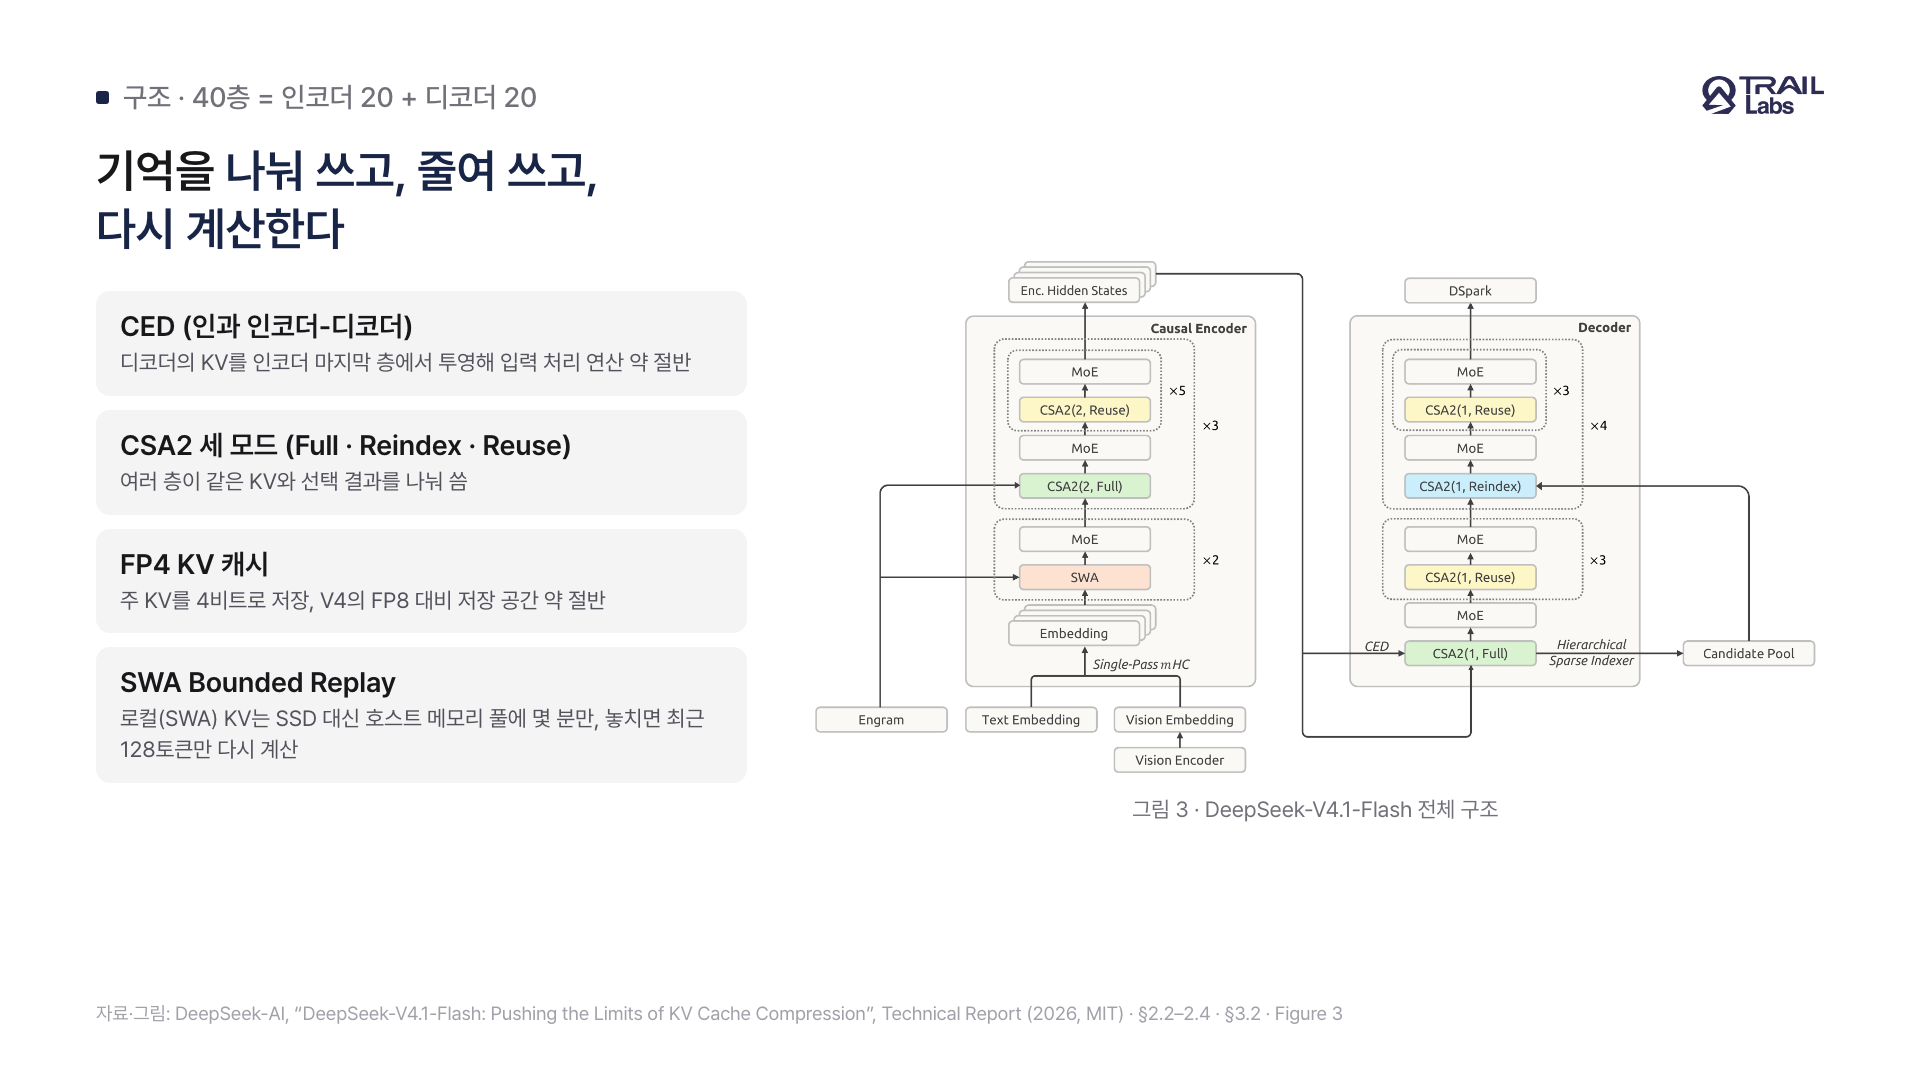
그림 2. 인코더 20층의 출력으로 디코더 KV를 만들고, 대부분의 층이 앞 층의 KV를 재사용하는 구조예요 [1].
이 장치들을 합친 결과, 생성할 때 토큰 하나에 드는 연산량이 문맥 길이에 거의 영향을 받지 않게 됐어요. 문맥을 4K에서 1M으로 256배 늘려도 연산량은 4분의 1만큼만 늘었어요 [1].
그 밖에 구조에서 바뀐 것은 무엇인가요
KV 외에도 세 가지가 들어갔어요 [1]. Engram은 "외우는 일"과 "계산하는 일"을 떼어 놓는 조건부 메모리 모듈로, 2·3·4 토큰 묶음을 해시로 찾아 쓰는 196B 크기의 임베딩 표를 0부터 센 1번과 14번 층에 붙였어요 [1]. 찾는 주소가 입력 토큰만으로 정해져서, 계산 중에 호스트 메모리에서 미리 끌어올 수 있어요 [1]. DSpark는 초안을 5개 위치씩 한 번에 만들고 확신도에 따라 검증 길이를 고르는 추측 디코딩 모듈로, V3의 다중 토큰 예측(MTP)처럼 본체와 함께 학습하지 않고 사전학습 뒤에 따로 붙였어요 [1]. Single-Pass mHC는 V4에서 도입한 다중 잔차 스트림의 계수를 한 블록씩 미뤄 써서, 배포 커널 하나로 메모리 왕복을 절반으로 줄였어요 [1].
학습 쪽에서는 어텐션 헤드마다 따로 전처리를 하는 head-wise Muon과, Engram과 임베딩 표에 Adam 대신 Sinkhorn 정규화 갱신을 써서 옵티마이저 메모리를 줄인 변경이 있어요 [1]. 사전학습 데이터는 이미지와 텍스트를 섞은 45T 토큰이고, 희소 어텐션을 64K 길이에서 처음부터 학습한 뒤 34T 토큰 시점에 100만 토큰으로 늘렸어요 [1].
DeepSeek V4.1의 사후학습 방법은 바뀌었나요
사후학습 방법은 바뀌지 않았어요 [1]. 보고서 5.1절은 이번 버전에서 새 사후학습 알고리즘을 도입하지 않았고, 지도 미세조정(SFT) 뒤에 강화학습(RL)과 온폴리시 증류(OPD)를 잇는 표준 레시피를 잘 알려진 관행을 넘는 수정 없이 V4 개발 때 쓰던 방식 그대로 따랐다고 적어요 [1]. 대신 "어떻게 최적화하느냐"보다 "무엇으로 학습하느냐"에 거의 모든 노력을 썼고, 고정된 평범한 최적화 절차 아래에서 합성 데이터와 환경의 규모, 다양성, 검증 가능성을 키운 것이 사후학습에서 관찰된 향상의 거의 전부를 설명한다고 밝혀요 [1]. 사전학습은 달랐어요. 45T 토큰 멀티모달 코퍼스, Engram, head-wise Muon이 들어갔고, 보고서는 기반 모델의 향상을 데이터 정제 개선의 결과로 설명해요 [1].
온폴리시 증류는 학생 모델이 직접 생성한 답을 교사 모델이 토큰 단위로 채점해 그 분포를 따라가게 하는 방식이에요 [3][4]. 학생이 실제로 갈 길 위에서 배우기 때문에, 교사의 답만 보고 따라 쓰는 일반 증류보다 실제 사용 분포와 어긋나는 문제가 작아요 [4]. V4.1은 이 단계를 사후학습의 마지막에 두고, 도메인마다 가장 잘하는 교사 모델 40개 이상을 구조가 서로 달라도 그대로 붙여 썼어요 [1].
| 바뀐 것 | 내용 |
|---|---|
| 과제 생성 | (문제, 환경, 검증 시스템) 묶음을 모델이 만들고, 난이도와 정확성을 보상으로 과제 생성 능력을 학습 |
| 일반 에이전트 환경 | 사내외 사용 기록에서 실제 도구 인터페이스를 본뜬 모의 도구를 대량 생성, 실패 사례를 재현해 학습 |
| 코딩 에이전트 환경 | 공개 저장소를 여러 에이전트가 컨테이너 과제로 만들고 별도 검수·수리 에이전트가 검증 |
| 추론 노력 조절 | 시스템 프롬프트에 1부터 100까지 노력 값을 넣고 길이 벌점을 그 값에 맞춰 바꿔 학습 |
| 학습 인프라 | 롤아웃과 학습을 비동기로 돌리고, 오래된 샘플 토큰은 손실에서 제외 |
| 최종 증류 | 전 도메인 데이터로 교사 40개 이상을 쓰는 전체 어휘 온폴리시 증류 |
표 2. 사후학습에서 바뀐 것은 모두 데이터, 환경, 인프라 쪽이에요 [1]. 정리는 보고서 5.1–5.2절을 읽고 우리가 묶은 것이에요.
성능 변화는 에이전트 작업에서 컸어요. 보고서 표 3의 최대 노력 설정 기준으로 V4-Flash에서 V4.1-Flash로 오면서 DeepSWE v1.1은 54.4에서 74.2로, Terminal-Bench 2.1은 82.7에서 90.6으로, Automation-Bench는 37.7에서 54.8로 올랐어요 [1]. 이 차이에는 본체 파라미터 증가(284B에서 552B)와 사전학습 변경이 함께 들어 있고, 보고서가 명시하는 것은 사후학습 알고리즘이 바뀌지 않았다는 점이에요 [1].
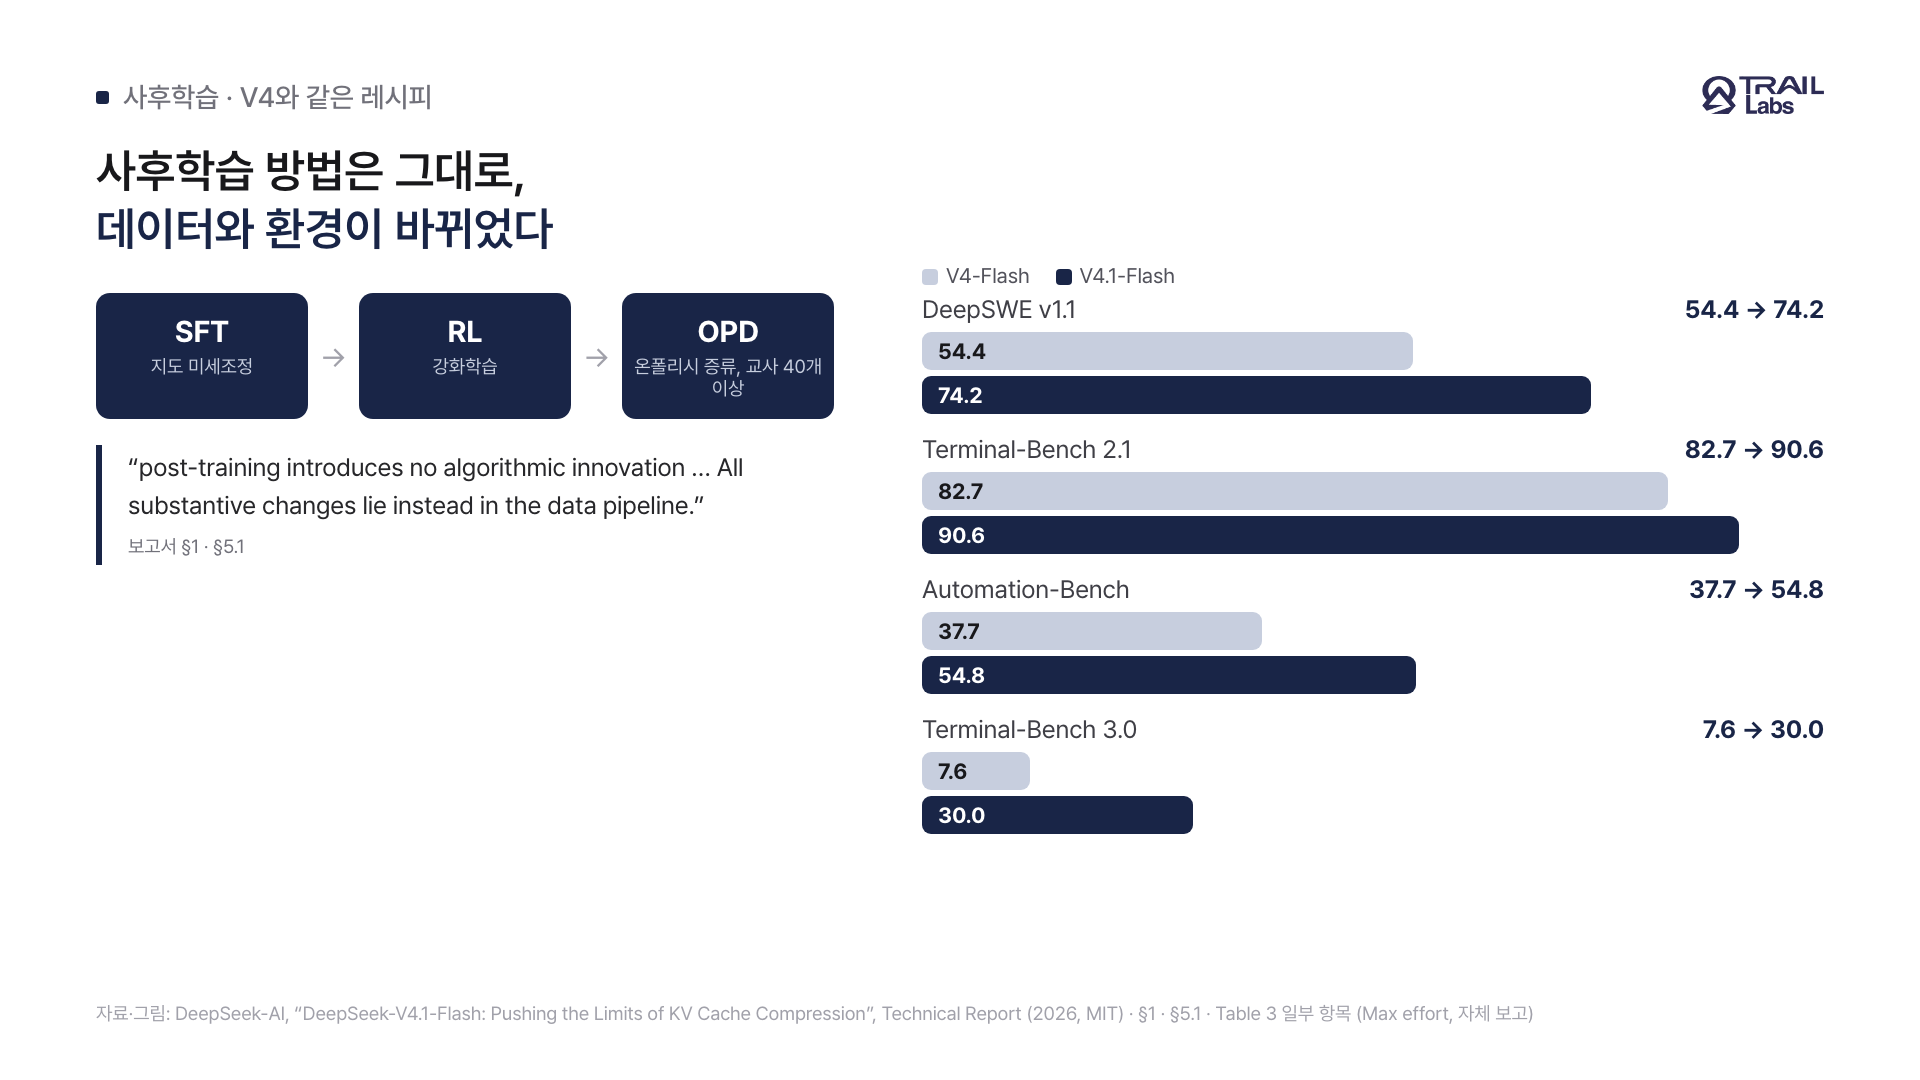
그림 3. 사후학습 레시피는 V4와 같고, 에이전트 벤치마크 점수는 크게 올랐어요(자체 보고, 일부 항목) [1].
추론 노력 값은 실제 비용 손잡이로도 쓰여요. 공개 API의 low, high, max는 노력 값 50, 75, 100에 대응하고, 노력을 25에서 100으로 올리면 출력 토큰이 약 2.5배 늘면서 DeepSWE 점수가 66.0에서 74.2로 올랐어요 [1]. 보고서는 60에서 80 구간이 최대 설정 정확도의 대부분을 절반 이하 토큰으로 얻는다고 적었어요 [1].
이 보고서의 한계는 무엇인가요
저자들이 밝힌 한계부터 보면, CSA2가 읽을 위치를 잘못 고르거나 SWA 상태를 근사로 복원하는 과정이 시험하지 않은 극단 조건에서 성능을 떨어뜨릴 수 있다고 적었어요 [1]. 벤치마크가 포화 상태라 점수가 비슷해도 가장 어려운 작업에서는 최상위 폐쇄형 모델과 격차가 남는다고도 밝혔어요 [1].
우리가 읽으며 더한 한계도 있어요. 모든 점수는 DeepSeek의 자체 보고이고, 구조 변경과 데이터 변경이 각각 성능에 얼마나 기여했는지 나눈 실험은 없어요. 외부 실사용 측정 두 건은 모두 토큰 사용량이나 속도에서 불리했어요. 10월 17일 업데이트 버전을 직접 비교한 한 실사용 테스트에서는 화면 구현 점수가 올랐지만 토큰을 40% 더 썼고, DeepSeek은 반대로 주장한다고 적었어요 [5]. PR 리뷰 벤치마크에서는 V4.1 Flash의 PR당 비용(0.42달러)은 낮은 축이었지만 6분 32초가 걸려 GPT-6 Sol(2분 17초)보다 느렸어요 [6]. 이 측정을 낸 회사는 모델 라우팅 서비스를 팔고 있어요. 두 측정 모두 표본과 과제가 제한적이라 방향으로 읽어야 해요.
오픈 모델 기술 보고서를 왜 읽어야 하나요
보고서는 사후학습에 새 알고리즘이 없다고 스스로 밝혀요 [1]. SFT, RL, 온폴리시 증류로 이어지는 사후학습 흐름은 V4와 같고, 바뀐 것은 비용 구조를 다시 짠 아키텍처, 사전학습 데이터, 사후학습에 넣는 데이터와 환경이에요 [1]. 보고서는 비용 절감을 구조 변경의 결과로, 성능 향상을 사전학습 데이터 정제와 사후학습 데이터·환경 파이프라인의 결과로 설명하고, 파라미터가 두 배 가까이 늘어난 영향은 따로 나누지 않았어요 [1]. 벤치마크 표만 봐서는 이 구분이 보이지 않아요.
폐쇄형 모델은 대체로 층 배치, 캐시 크기, 학습 단계를 이 수준까지 공개하지 않아요. 그래서 DeepSeek처럼 구조와 가중치를 함께 여는 보고서가 나올 때마다 내부를 뜯어보고 공부해 두는 것이, 모델을 직접 만들지 않는 팀이 모델 쪽 흐름을 따라가는 가장 직접적인 방법 중 하나예요. 우리처럼 모델 위에서 제품을 만드는 팀은 입력이 긴 에이전트 작업에서 비용이 입력 처리와 KV 저장에서 생긴다는 점, 추론 노력 값 하나로 비용과 정확도를 바꿀 수 있다는 점을 설계에 그대로 반영할 수 있어요 [1].
Frequently asked questions
DeepSeek V4.1 Flash는 이전 모델과 무엇이 다른가요?
보고서 기준으로 전체 파라미터는 V4-Flash의 284B에서 552B로 커졌지만, 토큰당 전역 KV 캐시는 3,514바이트에서 890바이트로 4분의 1이 됐어요. 입력 처리 때는 8B, 생성 때는 16B 파라미터만 쓰고, 이미지를 처음부터 함께 학습한 멀티모달 모델이며 최대 100만 토큰 문맥을 받아요. 사후학습 방법은 V4와 같고, 자체 보고 기준 에이전트 벤치마크 점수가 크게 올랐어요.
DeepSeek V4.1은 KV 캐시를 어떻게 줄였나요?
네 가지를 겹쳤어요. 위쪽 절반 층이 아래쪽 마지막 층에서 KV를 만들어 쓰는 인과 인코더-디코더(CED), 여러 층이 같은 KV와 선택 결과를 나눠 쓰는 CSA2, 주 KV를 4비트로 저장하는 FP4 캐시, 로컬 창 KV를 SSD 영구 캐시에서 빼 호스트 메모리 풀에 몇 분만 두고 놓치면 최근 128토큰만 다시 계산하는 SWA Bounded Replay예요. 그 결과 GPU 메모리에 늘 올라가는 KV는 V4-Flash의 4분의 1, 오래 저장해 두는 KV는 8분의 1이 됐어요.
DeepSeek V4.1의 사후학습 방법은 바뀌었나요?
사후학습 방법은 바뀌지 않았어요. 보고서는 지도 미세조정(SFT), 강화학습(RL), 온폴리시 증류(OPD)로 이어지는 V4의 표준 레시피를 잘 알려진 관행을 넘는 수정 없이 그대로 썼고, 실질적인 변화는 모두 데이터 파이프라인에 있다고 밝혀요. 바뀐 것은 학습 과제와 에이전트 환경을 대량으로 자동 생성하는 파이프라인, 비동기 학습 인프라, 추론 노력 조절 신호, 40개가 넘는 교사 모델을 쓰는 최종 증류 단계의 규모예요.
오픈 모델 기술 보고서를 왜 읽어야 하나요?
폐쇄형 모델은 대체로 구조와 학습 세부를 이 수준까지 공개하지 않아서, 비용이 어디서 생기고 성능이 무엇 덕분에 오르는지 확인하기 어려워요. DeepSeek 보고서는 층 배치, 캐시 크기, 학습 단계까지 적고 가중치도 MIT 라이선스로 공개해, 모델 위에서 제품을 만드는 팀이 비용 구조와 한계를 근거로 판단할 수 있게 해 줘요.
References
- [1]DeepSeek-AI, "DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression", Technical Report, 2026 (MIT 라이선스)
- [2]Yutao Sun et al., "You Only Cache Once: Decoder-Decoder Architectures for Language Models", 2024
- [3]Yuxian Gu et al., "MiniLLM: On-Policy Distillation of Large Language Models", ICLR 2024
- [4]Kevin Lu, Thinking Machines Lab, "On-Policy Distillation", 2025
- [5]Peter Petruš, "New DeepSeek V4.1 Flash (1017). Better results, but at what cost?", LinkedIn, 2026-10
- [6]Patrick Collins (Dam Secure), PR 리뷰 벤치마크 게시물, LinkedIn, 2026-09-28
Summary
- DeepSeek V4.1 Flash는 552B 멀티모달 MoE 모델로, 입력 처리 때 8B, 생성 때 16B 파라미터만 쓰고 최대 100만 토큰을 받아요.
- 인과 인코더-디코더, 층 간 KV 공유(CSA2), FP4 KV 캐시로 토큰당 전역 KV를 890바이트까지 줄였어요. V4-Flash의 4분의 1, V1의 437분의 1이에요.
- 로컬 창 KV를 SSD 영구 캐시에서 빼고 전역 KV도 4분의 1로 줄여, 오래 저장해 두는 KV는 V4-Flash의 8분의 1이 됐어요.
- 사후학습은 SFT, RL, 온폴리시 증류로 이어지는 V4 레시피를 그대로 썼고, 보고서는 사후학습 단계의 향상이 거의 모두 데이터와 환경 파이프라인에서 나왔다고 밝혀요.
- 점수는 자체 보고이고 구조와 데이터의 기여를 나눈 실험은 없으며, 외부 실사용 측정 두 건은 토큰 사용량이나 속도에서 불리했어요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility