LLM 위키에서 Open Knowledge Format까지, 에이전트가 쓰는 지식베이스
카파시가 개인 연구용으로 보여 준 LLM 위키를 구글이 조직 간에 주고받는 형식으로 정리했고, v0.2에서 에이전트가 쓴 문서의 출처와 확인 여부를 적는 자리를 만들었어요
카파시가 개인 연구용으로 보여 준 LLM 위키는 원자료를 모아 두면 LLM이 마크다운 위키를 쓰고 계속 고치는 방식이고, 구글은 이 패턴을 Open Knowledge Format(OKF)이라는 개방 규격으로 정리해 다른 도구와 조직이 그대로 주고받을 수 있도록 설계했어요 [1][3]. 저장소 기록상 7월에 반영된 v0.2는 에이전트가 쓴 문서가 늘어나는 상황을 전제로, 누가 썼고 어디서 왔고 누가 확인했는지를 앞머리에 적는 자리를 만들었어요 [4]. 그 자리가 실제로 채워지는지는 구글 공개 샘플에서도 아직 비어 있었어요 [5].
이 글은 카파시의 X 게시물과 gist 원문, 구글 클라우드 블로그, OKF 규격 문서(SPEC.md)를 2026년 10월에 읽고 서로 대조해 정리했어요 [1][2][3][4]. 샘플 번들의 필드 집계는 공식 저장소의 커밋 5d1345c를 받아 직접 센 값이에요 [5]. OKF 도구를 직접 써 보지는 않았고, 구글과 이해관계는 없어요.
LLM 위키란 무엇이고 RAG와 무엇이 다른가요
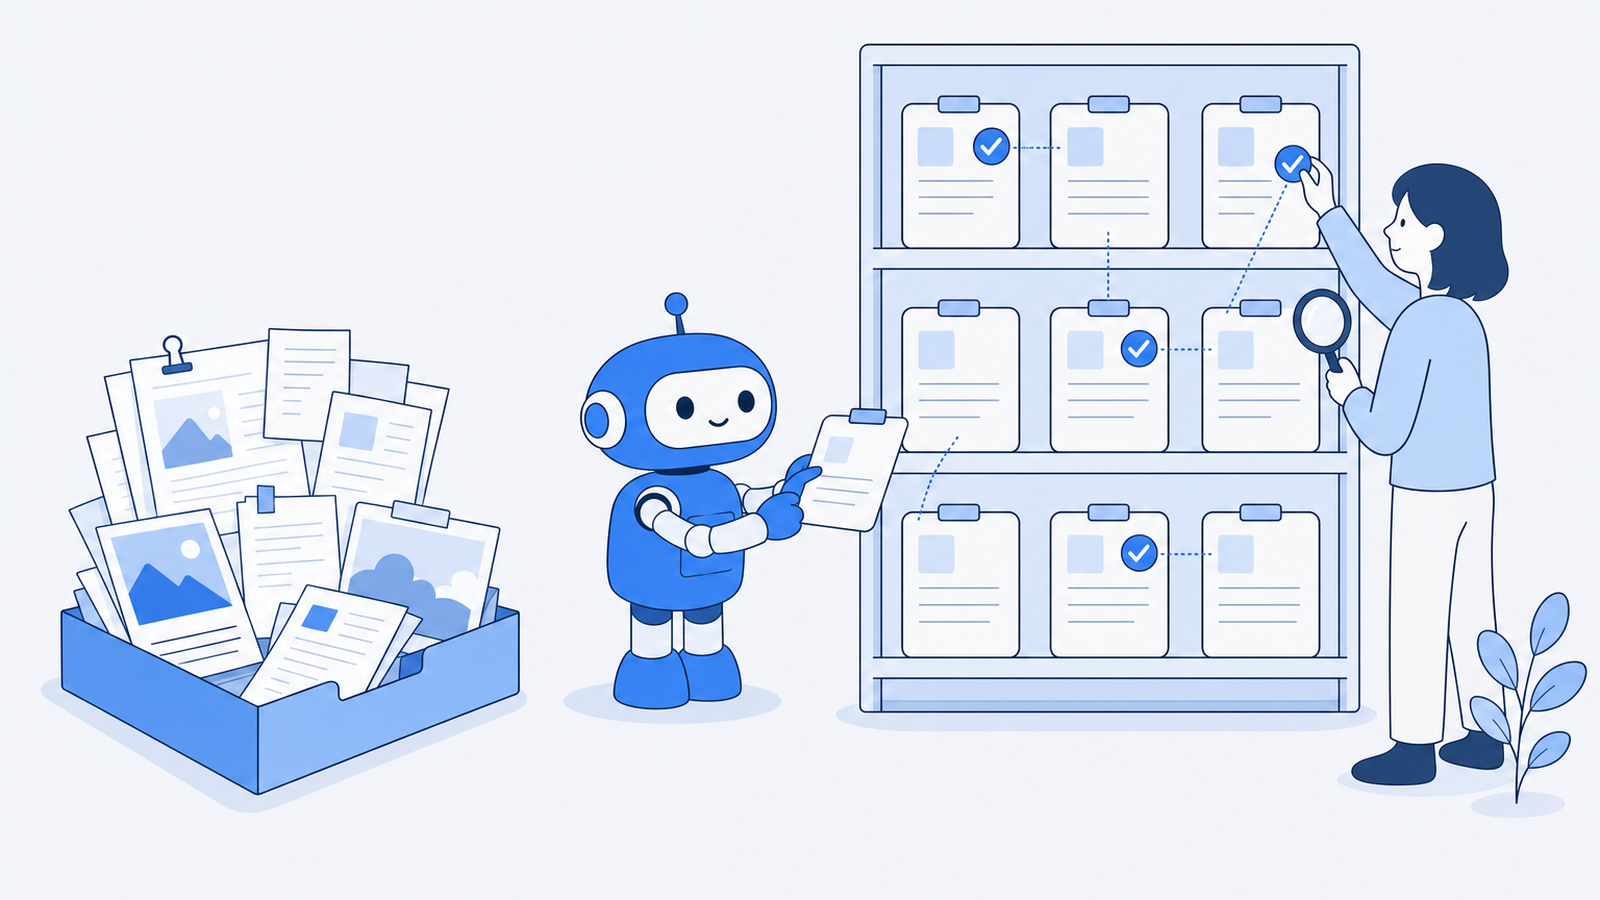
LLM 위키는 질문할 때마다 원문을 다시 찾는 대신, LLM이 원자료를 한 번 정리한 위키를 계속 고쳐 가며 그 위에서 답하는 방식이에요 [2]. 카파시는 2026년 4월 2일 X에 "LLM Knowledge Bases"라는 글을 올려, 최근 토큰 사용의 상당 부분이 코드보다 지식을 다루는 데 쓰인다고 적었어요 [1]. 흐름은 원자료를 raw/ 폴더에 모으고, LLM이 요약·백링크·개념 글로 된 마크다운 위키를 "컴파일"하고, 그 위키에 질문하고, 답을 다시 위키에 쌓는 순서예요 [1].
규모에 대한 관찰이 구체적이에요. 그의 연구 위키는 약 100편, 약 40만 단어였고, 처음엔 정교한 RAG가 필요하다고 생각했지만 LLM이 index 파일과 문서별 짧은 요약을 스스로 관리해 그 정도 규모에선 관련 자료를 무리 없이 읽어 냈다고 해요 [1]. 위키는 LLM이 쓰고 고치며, 본인은 거의 직접 손대지 않는다고 적었어요 [1].
별도로 공개한 gist "LLM Wiki"는 이를 세 층으로 정리해요 [2]. 원자료(raw sources)는 고치지 않는 진실 공급원이고, 위키는 LLM이 전부 소유하는 마크다운 파일 묶음이고, 스키마(CLAUDE.md나 AGENTS.md 같은 파일)는 위키의 구조와 작업 규칙을 LLM에게 알려 주는 설정 파일이에요 [2]. 작업은 수집(ingest), 질문(query), 점검(lint) 세 가지이고, 점검은 페이지 간 모순, 새 자료가 덮어쓴 낡은 주장, 들어오는 링크가 없는 고립 페이지를 찾는 일이에요 [2].
RAG와의 차이를 카파시는 "쌓이느냐"로 설명해요. NotebookLM이나 파일 업로드형 RAG는 다섯 문서를 엮어야 하는 질문이 오면 매번 조각을 다시 찾아 붙이지만, LLM 위키는 상호 참조와 모순 표시가 이미 들어 있는 상태에서 출발해요 [2]. 사람이 위키를 포기하게 만드는 것은 읽기나 생각보다 장부 정리 비용이고, LLM은 지루해하지 않고 한 번에 15개 파일을 고칠 수 있어 그 비용이 거의 0이 된다는 것이 그의 논지예요 [2].
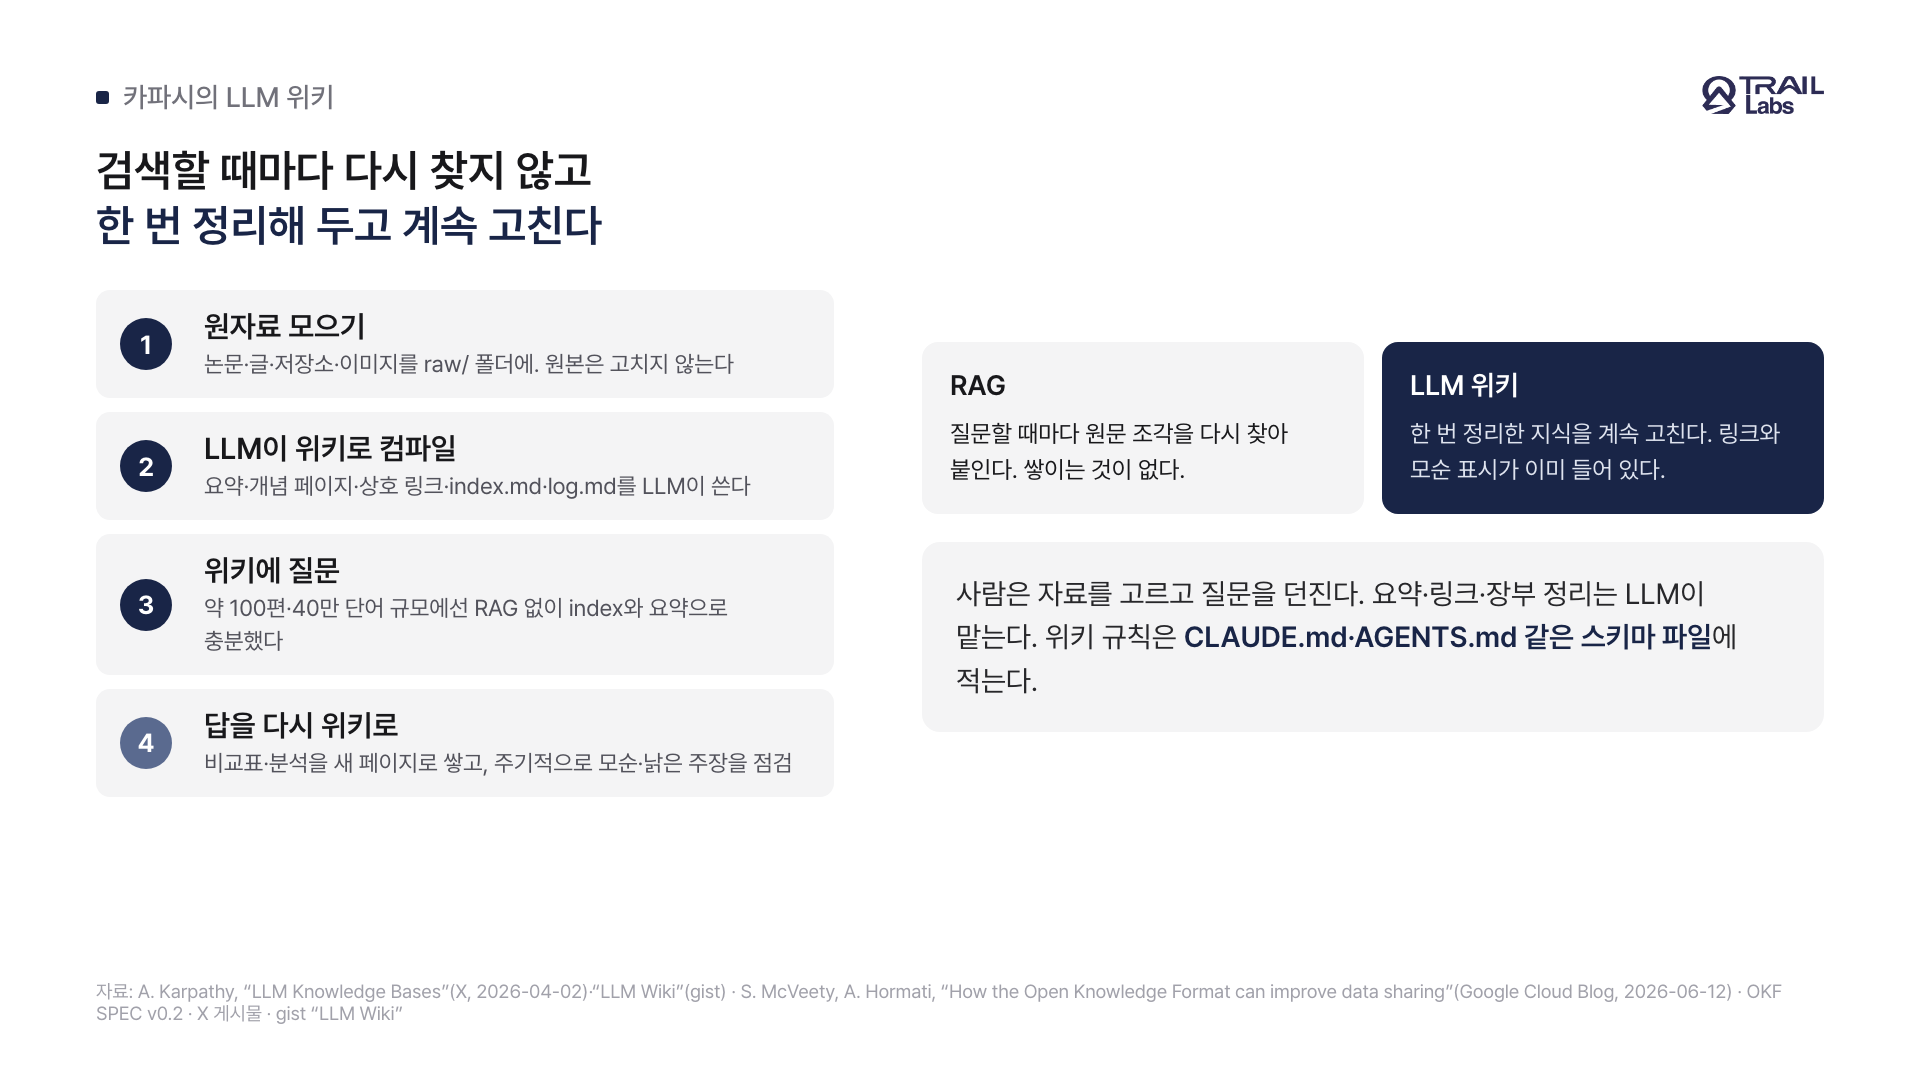
그림 1. LLM 위키는 원자료를 한 번 정리한 위키를 계속 고치며, 답도 다시 위키에 쌓아요 [1][2].
Open Knowledge Format은 무엇인가요
OKF는 LLM 위키 패턴을 다른 생산자와 소비자가 번역 없이 주고받을 수 있게 만든 개방 규격이에요 [3]. 구글 클라우드 데이터 클라우드 팀의 Sam McVeety와 Amir Hormati가 2026년 6월 12일 구글 클라우드 블로그에서 v0.1을 발표하면서 카파시의 gist를 직접 인용했어요 [3]. 문제 제기는 이래요. 카파시의 위키, 팀 위키, 벤더의 카탈로그 내보내기가 모두 마크다운·앞머리·상호 링크로 생겼지만, 서로 협력하도록 설계되지 않아 문서마다 어떤 필드를 둘지, 어떤 파일명이 무슨 뜻인지 합의가 없다는 것이에요 [3].
그래서 OKF는 새 서비스가 아니라 형식을 내놓았어요 [3]. 지식 묶음(bundle)은 마크다운 파일이 든 폴더이고, 파일 하나가 개념 하나이며 파일 경로가 그 개념의 이름이에요 [4]. 앞머리에서 필수는 type 하나이고, title·description·resource·tags는 권장 필드예요 [4]. index.md(폴더 목록, 점진적 공개용)와 log.md(변경 이력)는 예약 파일명이고, 개념끼리는 일반 마크다운 링크로 이어져 폴더 구조보다 풍부한 그래프가 돼요 [4].
| 카파시 LLM 위키 | OKF의 대응 | 비고 |
|---|---|---|
| 위키의 개념·요약 페이지 | 개념 문서(concept), type 필수 | 파일 경로가 개념의 이름 |
| index.md | index.md 예약 파일명 | 폴더마다 둘 수 있음 |
| log.md | log.md 예약 파일명 | 날짜별 변경 이력 |
| raw/ 원자료 | sources 필드, references/ 관례 | v0.2에서 앞머리로 이동 |
| 점검(모순·낡은 주장) | status, stale_after, verified | v0.2, 점검 절차 자체는 규정하지 않음 |
| 스키마 파일(CLAUDE.md, AGENTS.md) | 규정하지 않음 | 생산자 몫 |
표 1. 카파시가 gist에서 설명한 위키 요소와 OKF 규격의 대응이에요 [2][4]. 대응 관계는 두 문서를 대조해 우리가 정리한 것이에요.
설계 원칙은 세 가지예요. 최소한만 정한다(필수는 type 하나), 쓰는 쪽과 읽는 쪽이 독립적이다(사람이 쓴 묶음을 에이전트가 읽고, 한 LLM이 만든 묶음을 다른 LLM이 질의한다), 특정 플랫폼에 묶이지 않는다(독점 계정이나 SDK 없이 읽고 쓴다)예요 [3]. 함께 공개한 것은 BigQuery 데이터셋을 돌며 테이블마다 개념 문서를 쓰고 공식 문서로 보강하는 레퍼런스 에이전트, 묶음을 그래프로 보여 주는 정적 HTML 뷰어, 샘플 번들이에요 [3]. 저장소는 Apache-2.0 라이선스이고, 구글 클라우드 Knowledge Catalog가 OKF를 읽어 들이도록 바뀌었다고 블로그는 밝혀요 [3].
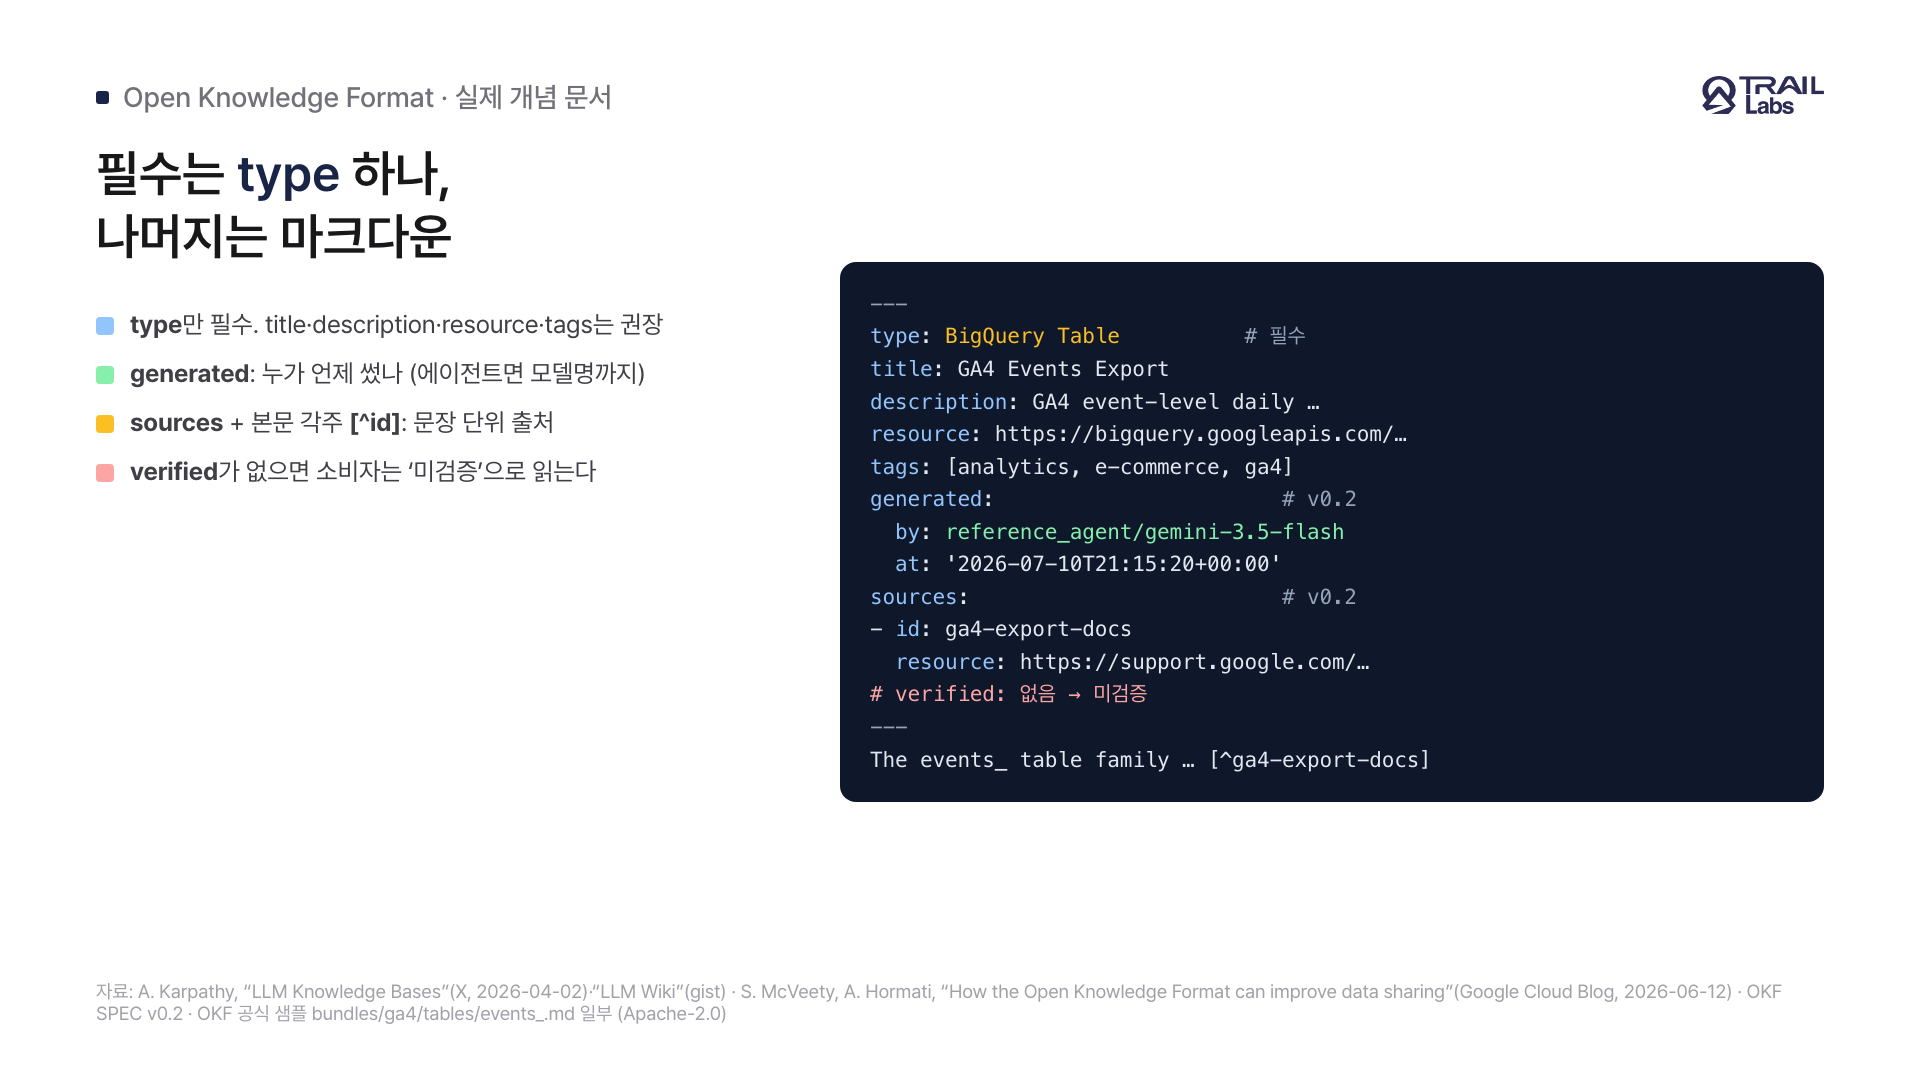
그림 2. OKF 공식 GA4 샘플의 개념 문서 한 장이에요. type만 필수이고, 출처는 앞머리 sources와 본문 각주로 이어져요 [4][5].
에이전트가 쓴 문서를 어떻게 믿을 수 있나요
v0.2는 지식 묶음을 에이전트가 계속 고쳐 쓰는 대상으로 보는 전제에서 출발해요 [4]. 규격 문서는 대부분이 기계가 만든 개념이라면 소비자에게 다섯 가지 답이 필요하다고 적어요. 무엇에서 만들었는가(출처), 얼마나 믿을 만한가(신뢰), 아직 사실인가(신선도), 현재 버전인가(상태), 숫자가 정해진 방식대로 계산됐는가(증명)예요 [4]. 저장소의 규격 문서 기록상 v0.2로의 이전은 2026년 7월 24일이었어요 [4].
출처는 sources 목록에 담고, 문장 단위 출처는 본문 각주의 이름을 sources의 id와 맞춰 연결해요 [4]. 순서 번호 대신 고정된 id를 쓰는 이유가 흥미로워요. 에이전트가 문서를 계속 고쳐 쓰다 보면 목록 순서가 바뀌고, 순서 번호로 연결한 출처는 소리 없이 엉뚱한 문장에 붙기 때문이에요 [4]. 출처마다 작성 주체, 사용 횟수, 마지막 수정 시각을 적을 수 있지만, 신뢰 점수 자체는 저장하지 않아요. 점수는 주관적이고 소비자마다 다르고 금방 낡는다는 이유예요 [4].
신뢰는 쓴 쪽과 확인한 쪽을 나눠 적어요. generated는 누가 언제 썼는지, verified는 누가 언제 확인했는지이고, 확인자가 사람이면 human:으로 시작하는 이름을 써야 해요 [4]. 소비자는 verified가 없으면 미검증, 프로세스나 에이전트만 확인했으면 기계 확인, 사람이 확인했으면 사람 검토로 등급을 읽어요 [4]. 상태는 draft·stable·deprecated 셋이고, stale_after는 이 시각 이후로는 낡은 내용으로 보라는 절대 시각이에요 [4]. 이 필드들이 없다고 문서를 거부해서는 안 되고, 등급은 접근 제어에 쓰지 않는 참고 신호예요 [4].
공식 샘플 번들을 직접 세어 보니, 형식이 자리를 만든 것과 그 자리가 채워지는 것은 별개였어요. 구글 레퍼런스 에이전트가 GA4·Stack Overflow·비트코인 공개 데이터로 만든 번들 3개의 개념 문서 44개는 모두 generated와 sources가 달렸지만, verified가 있는 문서는 하나도 없었어요 [5]. 규격대로 읽으면 44개 전부 미검증이에요. 확인 기록이 채워진 쪽은 가상의 소매 회사를 예시로 만든 acme_retail 번들로, 개념 문서 9개 중 8개에 사람 확인자가, 7개에 유효 기한이 적혀 있었어요 [5].
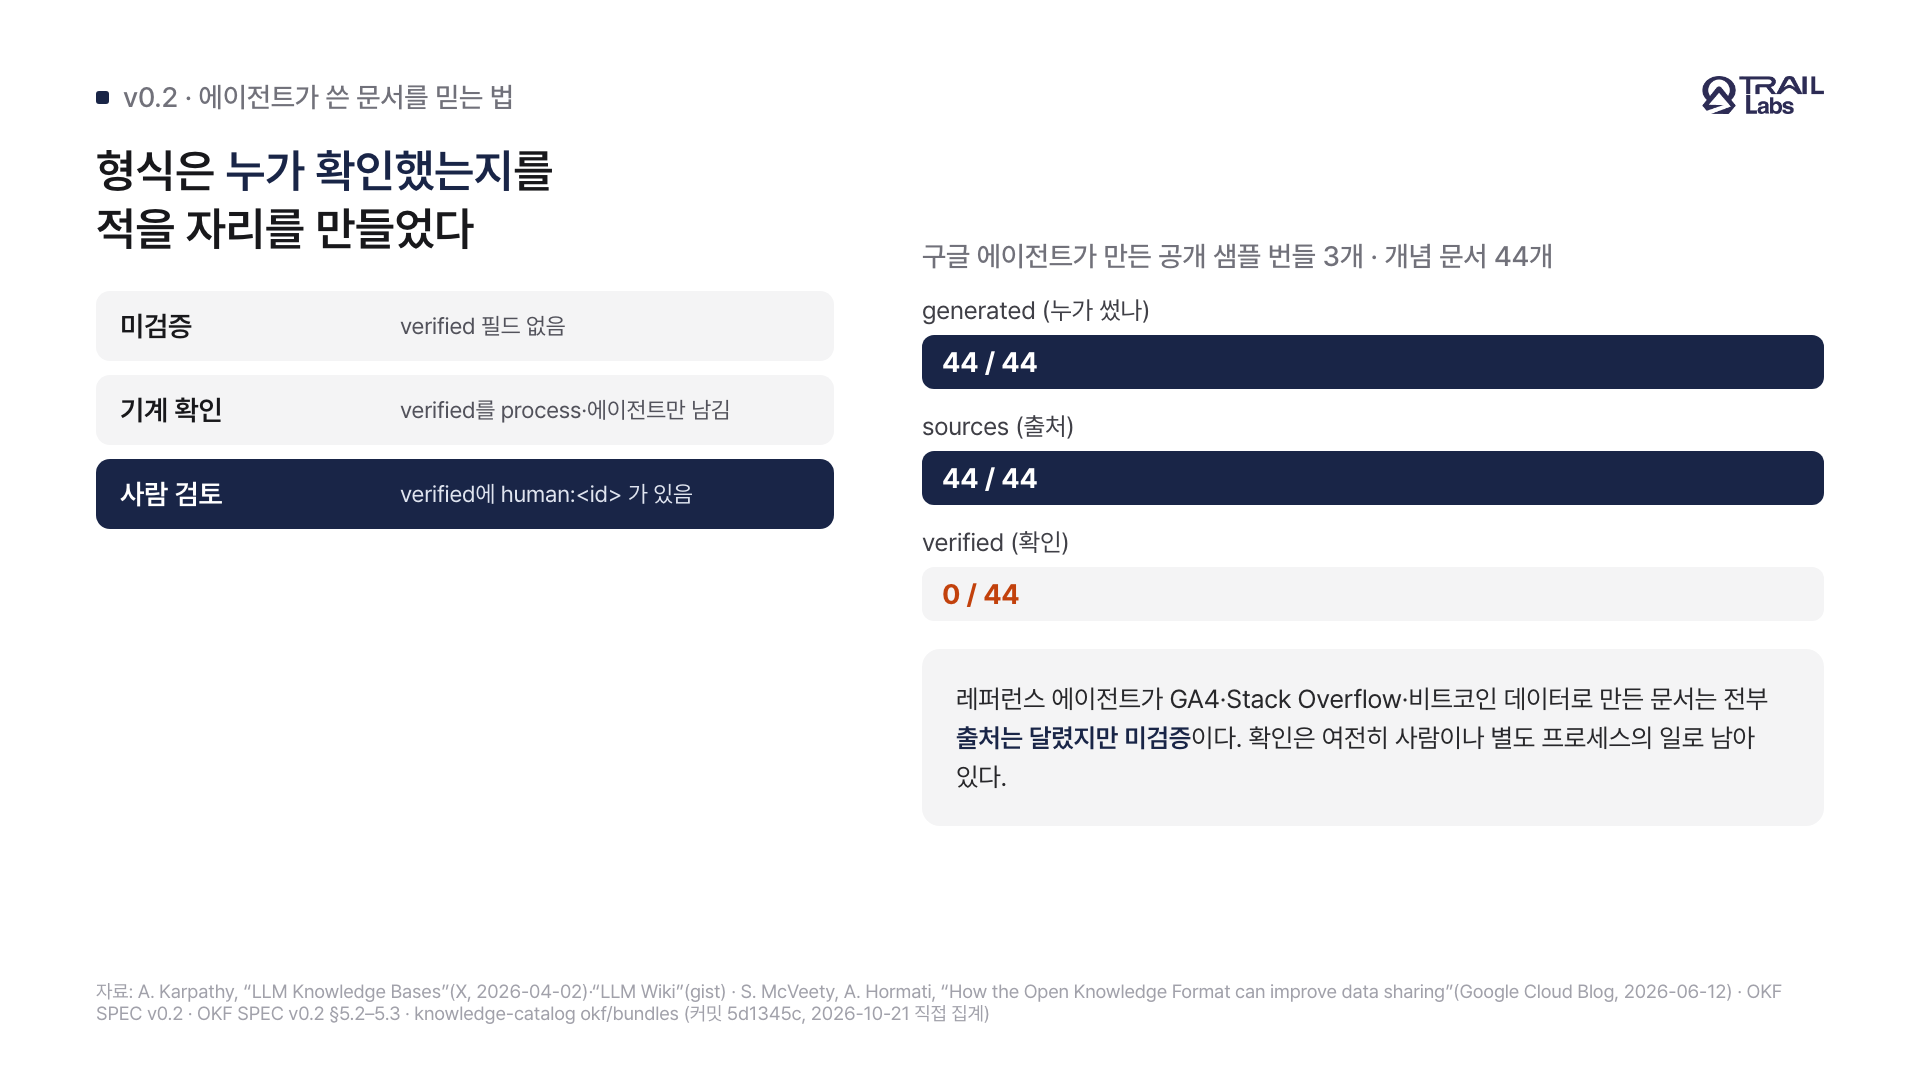
그림 3. 구글 에이전트가 만든 공개 샘플 44개 문서는 작성자와 출처는 모두 달렸고 확인 기록은 없었어요 [4][5].
AI 에이전트용 지식베이스는 어떤 형식으로 만들어야 하나요
사람이 편집기로 바로 읽고 에이전트가 별도 도구 없이 파싱하는 형식, 곧 앞머리가 달린 마크다운 파일 묶음이 지금 두 흐름이 만나는 지점이에요 [1][4]. 처음부터 규격 전체를 따를 필요는 없어요. OKF가 요구하는 것은 type 하나이고, 필드가 빠졌거나 링크가 깨진 묶음도 거부하지 말라고 규정해요 [4]. 작게 시작하는 순서는 이래요.
- 개념 하나를 파일 하나로 두고, 앞머리에 type과 description 한 줄을 적어요 [4].
- 폴더마다 index.md에 문서 목록과 한 줄 설명을 두고, log.md에 날짜별 변경을 남겨요. 카파시는 log.md 항목을 같은 머리말로 시작하면 grep 한 줄로 최근 기록을 뽑을 수 있다고 적었어요 [2].
- 에이전트가 쓴 문서에는 generated에 모델 이름을 적고, 근거 문장은 sources의 id와 각주로 연결해요 [4].
- 사람이 확인한 문서에만 verified를 달고, 숫자처럼 빨리 낡는 내용에는 stale_after를 적어요 [4].
- 위키의 구조와 작업 규칙은 CLAUDE.md나 AGENTS.md 같은 스키마 파일에 적어요. OKF는 이 부분을 규정하지 않아요 [2][4].
TRAIL Labs도 회사 사실을 마크다운 파일 묶음으로 두고, 에이전트가 회사 이야기가 들어가는 글을 쓰기 전에 그 묶음을 먼저 읽게 하고 있어요. 운영하며 부딪힌 문제는 v0.2가 다루는 문제 중 확인 시점과 같았어요. 에이전트가 고친 문장이 늘수록 이 내용이 아직 맞는지 확인한 시점이 필요해져서, 파일마다 마지막 확인 날짜를 적고 변경 이력을 따로 남기고 있어요. 다만 OKF 형식으로 옮기지는 않았고, 확인 기록도 파일 단위에 머물러 있어요.
이 글의 한계와 아직 모르는 것
OKF는 v0.x 규격이고, 구글 밖에서 얼마나 채택됐는지는 확인하지 못했어요. 구글 블로그와 규격 문서 모두 OKF를 썼을 때 에이전트 답변의 정확도가 얼마나 달라지는지에 대한 측정은 내놓지 않았어요 [3][4]. 형식이 맞으면 서로 읽을 수 있다는 것까지가 이 규격의 약속이에요.
카파시의 관찰은 한 사람의 연구 위키, 약 100편 규모에서 나온 것이에요 [1]. 그는 규모가 커지면 제대로 된 검색이 필요해진다고 적었고, 위키 위에 간단한 검색 엔진을 직접 만들어 쓰고 있다고 했어요 [1][2]. 같은 방식이 수천, 수만 개 문서의 조직 위키에서도 RAG 없이 통하는지는 공개된 근거가 없어요.
샘플 집계는 2026년 10월 21일 공식 저장소 기준이고, 레퍼런스 에이전트가 만든 공개 예시만 센 것이에요 [5]. 구글 내부나 다른 조직의 실제 운영 묶음에서 확인 기록이 얼마나 채워지는지는 알 수 없어요. 규격의 신뢰 등급은 확인했다는 기록일 뿐 내용이 맞다는 보장은 되지 못하고, 규격도 이를 참고 신호라고 밝혀요 [4].
Frequently asked questions
LLM 위키란 무엇이고 RAG와 무엇이 다른가요?
원자료를 모아 두면 LLM이 요약·개념 페이지·상호 링크로 된 마크다운 위키를 직접 쓰고 계속 고치는 방식이에요. RAG는 질문할 때마다 원문 조각을 다시 찾아 붙이지만, LLM 위키는 한 번 정리한 결과가 남아서 다음 질문과 새 자료가 그 위에 쌓여요. 카파시는 약 100편, 40만 단어 규모의 연구 위키에서 별도 RAG 없이 index 파일과 요약만으로 질문이 잘 풀렸다고 적었어요.
Open Knowledge Format은 무엇인가요?
구글 클라우드가 2026년 6월에 공개한 개방 규격으로, LLM 위키 패턴을 다른 도구와 조직이 그대로 주고받을 수 있게 정리한 형식이에요. 지식을 YAML 앞머리가 달린 마크다운 파일 묶음으로 표현하고, 필수 필드는 type 하나뿐이에요. index.md와 log.md는 예약 파일명이고, 문서끼리는 일반 마크다운 링크로 이어져요.
AI 에이전트용 지식베이스는 어떤 형식으로 만들어야 하나요?
사람이 편집기로 바로 읽고 에이전트가 별도 SDK 없이 파싱할 수 있는 형식이 출발점이에요. 개념 하나를 파일 하나로 두고, 앞머리에 type과 한 줄 설명을 적고, 폴더마다 index.md로 목록을, log.md로 변경 이력을 남기면 OKF 규격과 카파시의 위키 양쪽에 맞아요. 에이전트가 쓴 문서가 많아지면 출처와 확인자, 유효 기한도 앞머리에 적을 수 있고, OKF v0.2가 이 필드를 정의해요.
에이전트가 쓴 문서를 어떻게 믿을 수 있나요?
OKF v0.2는 누가 썼는지(generated), 어디서 왔는지(sources와 문장 단위 각주), 누가 확인했는지(verified), 언제까지 유효한지(stale_after)를 앞머리에 적게 했어요. 확인 기록이 없으면 미검증, 프로세스만 확인했으면 기계 확인, 사람이 확인했으면 사람 검토로 읽어요. 다만 규격은 적을 자리를 만들 뿐이라, 구글 에이전트가 만든 공개 샘플 44개 문서에도 확인 기록은 없었어요.
References
- [1]Andrej Karpathy, "LLM Knowledge Bases", X 게시물, 2026-04-02
- [2]Andrej Karpathy, "LLM Wiki", GitHub gist, 2026
- [3]Sam McVeety, Amir Hormati, "How the Open Knowledge Format can improve data sharing", Google Cloud Blog, 2026-06-12
- [4]Open Knowledge Format Specification v0.2, GoogleCloudPlatform/knowledge-catalog (Apache-2.0)
- [5]OKF 샘플 번들 (acme_retail · crypto_bitcoin · ga4 · stackoverflow), GoogleCloudPlatform/knowledge-catalog okf/bundles
Summary
- 카파시는 2026년 4월 X 게시물과 gist에서 원자료를 모아 두면 LLM이 마크다운 위키를 쓰고 계속 고치는 방식을 소개했고, RAG처럼 매번 다시 찾지 않고 정리한 결과가 쌓이는 점을 핵심으로 꼽았어요.
- 구글 클라우드는 2026년 6월 이 패턴을 Open Knowledge Format v0.1로 정리했어요. YAML 앞머리가 달린 마크다운 파일 묶음이고, 필수 필드는 type 하나, index.md와 log.md는 예약 파일명이에요.
- 7월(저장소 반영 기준) v0.2는 에이전트가 계속 고쳐 쓰는 지식을 전제로 출처(sources), 작성자(generated), 확인 기록(verified), 상태와 유효 기한(status, stale_after)을 추가했어요.
- 구글 레퍼런스 에이전트가 만든 공개 샘플 번들 3개의 44개 문서는 모두 작성자와 출처는 달렸지만 확인 기록은 없어, 규격상 미검증이었어요.
- OKF는 아직 v0.x이고 구글 밖 채택과 에이전트 정확도 개선 효과는 공개된 측정이 없어요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility