AI 검색이 인용한 페이지는 답변에 얼마나 반영될까: 인용 수와 흡수의 차이
ChatGPT·Google·Perplexity의 인용 21,143건으로 인용 선택과 인용 흡수를 나눠 잰 측정 연구 읽기
AI 검색이 페이지를 인용했다고 해서 그 페이지가 답변을 만든 것은 아니고, 얼마나 반영되는지는 플랫폼마다 반대로 움직였어요. 질문 602개를 ChatGPT, Google AI 개요/Gemini, Perplexity에 넣은 연구에서 질문당 평균 인용 수는 ChatGPT 6.88개로 가장 적었지만, 인용한 페이지가 답변에 반영된 정도를 나타내는 평균 흡수 점수는 0.2713으로 가장 높았어요 [1]. Perplexity는 평균 16.35개를 인용하면서 흡수 점수는 0.0646이었어요 [1].
이 글은 arXiv에 공개된 논문 원문 v2를 읽고 본문 표의 값에 대조해 정리했어요. 저자 세 명은 모두 독립 연구자이고, 분석한 데이터는 저자들이 직접 만든 공개 저장소 geo-citation-lab에 있어요 [1][2]. 저자들이 만든 데이터를 저자들이 분석했고, 논문에 이해관계 선언은 없어요. 논문은 p값이나 신뢰구간을 일부러 보고하지 않고, 자기 주장을 기술 통계 수준까지로 스스로 제한해요 [1]. 우리는 재현하지 않았어요. 우리도 AI 검색 진단 도구를 만드는 회사이고, 이 논문의 흡수 공식을 제품의 실험 지표에 가져다 썼어요.
AI 검색이 인용한 페이지는 답변에 얼마나 반영될까요?
인용 목록에 오르는 일과 답변 문장을 만드는 일은 서로 다른 단계라서, 반영되는 정도는 따로 재야 해요. 저자들은 앞 단계를 인용 선택(citation selection), 뒷 단계를 인용 흡수(citation absorption)라고 부르고, 인용 수는 폭을 재는 척도일 뿐 흡수를 재지 못한다고 못박아요 [1]. 같은 링크라도 배경 참조로만 붙을 수도 있고, 답변의 정의나 수치를 통째로 공급할 수도 있어요.
흡수는 사람이 판정하지 않고 다섯 가지 텍스트 신호의 가중합으로 계산해요 [1]. 답변에서 그 출처가 몇 번 다시 참조됐는지, 얼마나 일찍 등장했는지, 답변 문단을 얼마나 덮는지, TF-IDF 코사인 유사도, 단어 2·3개 묶음의 겹침이에요.
$$
여기서 ref는 답변 안 재참조 횟수, pos는 첫 등장 위치 비율, cov는 답변 문단 커버리지, tfidf는 페이지와 답변의 TF-IDF 코사인, bi와 tri는 2·3단어 묶음 겹침 비율이에요. 결과가 0과 1 사이 점수로 나오고, 높을수록 그 페이지가 답변을 더 많이 만들었다는 뜻이에요 [1].
연구는 인용 흡수를 어떻게 쟀을까요?
설계된 질문 602개를 세 플랫폼에 넣어 유효 인용 21,143건을 모았고, 인용 단위 피처 행 23,745건 중 본문을 가져올 수 있었던 18,151쪽에 흡수 점수를 매겼어요 [1]. 본문 수집 성공률은 76.44%였고, 흡수 분석은 이 페이지들로만 했어요 [1]. 질문은 과업 유형·산업·시의성을 나눈 주 실험 432개, 말투를 바꾼 대조 60개, 중국어·영어 쌍 60개, 고위험·모호·다중 제약 같은 어려운 시나리오 50개로 나뉘어요 [1].
페이지마다 72개 피처를 붙였어요 [1]. 단어 수·소제목·목록 같은 구조, 정의·숫자·비교·절차·코드·Q&A 같은 증거 유형, 답변과의 의미 유사도, 언어 모델이 매긴 질문 관련도와 품질, 도메인 유형이에요. 저자들은 흡수 점수를 만든 다섯 신호는 설명 변수로 쓰지 않는다는 규칙을 세워, 결과로 결과를 설명하는 순환을 피했어요 [1].
검색을 하느냐는 더 이상 차이를 만들지 않았어요. 세 플랫폼의 검색 실행률이 98.64%에서 100%였어요 [1]. 차이는 무엇을 몇 개 고르고, 그것을 얼마나 쓰느냐에서 났어요.
| 플랫폼 | 질문당 평균 인용 | 본문 수집 인용 | 평균 흡수 점수 | 흡수 중앙값 |
|---|---|---|---|---|
| ChatGPT | 6.88 | 3,323 | 0.2713 | 0.2611 |
| Google AI 개요/Gemini | 12.06 | 6,385 | 0.0584 | 0.0515 |
| Perplexity | 16.35 | 8,443 | 0.0646 | 0.0333 |
표 1. 플랫폼별 인용 폭과 흡수 깊이 [1].
ChatGPT와 Perplexity 중 어디가 출처를 더 깊이 쓸까요?
이 연구에서는 ChatGPT가 가장 적게 인용하고 가장 깊이 썼어요. ChatGPT의 평균 흡수 점수는 0.2713으로 Perplexity 0.0646의 네 배를 넘었고, Perplexity는 흡수 중앙값이 0.0333까지 내려갔어요 [1]. 저자들은 ChatGPT를 "인용은 드물고 흡수는 무거운" 플랫폼, Perplexity를 "인용이 많고 커버리지 지향인" 플랫폼으로 묘사해요 [1].
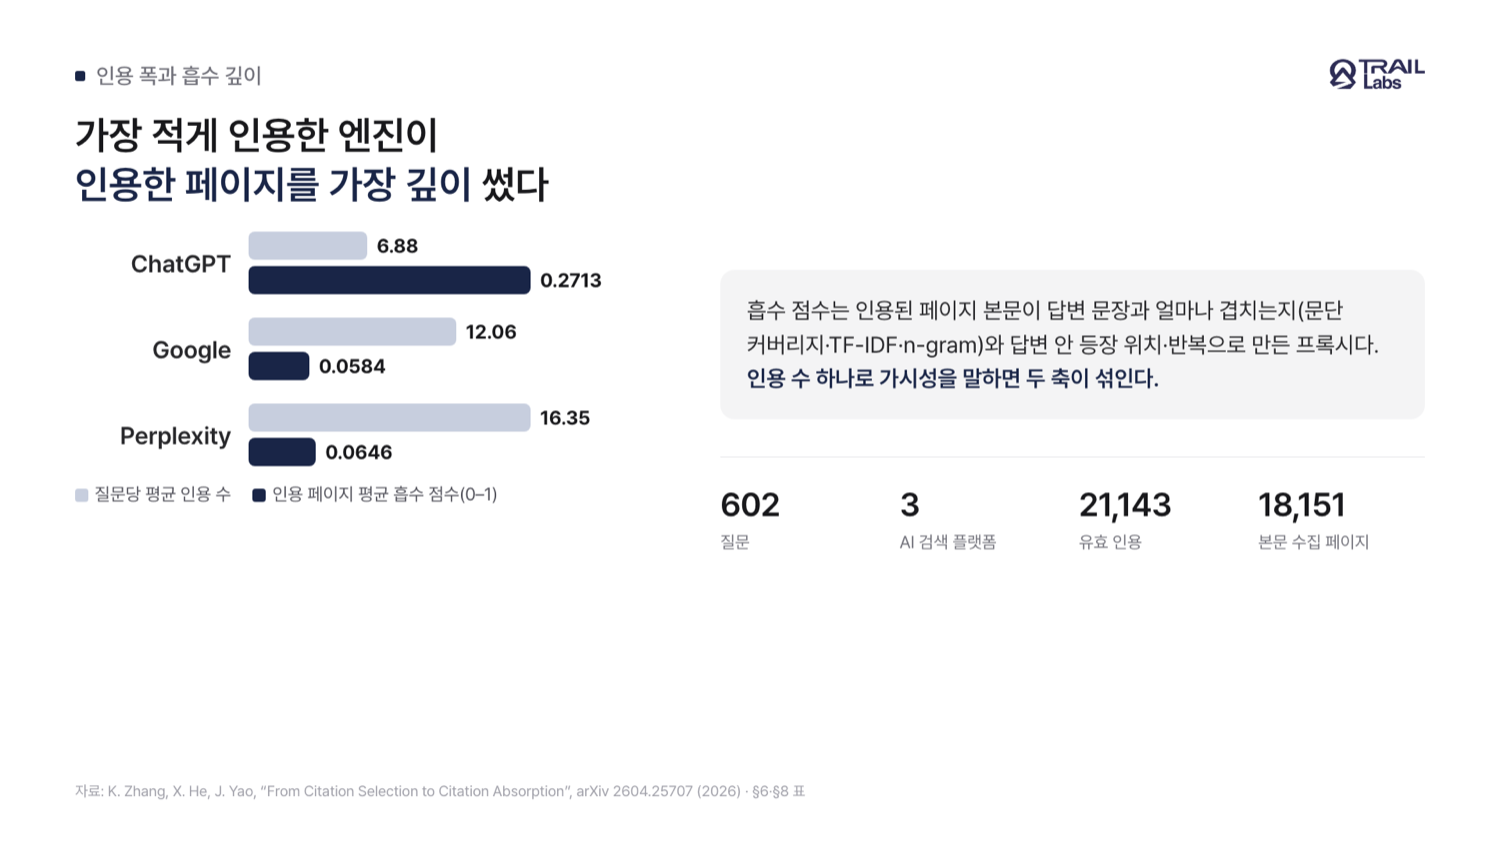
그림 1. 플랫폼별 인용 폭과 흡수 깊이.
목표에 따라 읽는 법이 달라져요. 저자들은 하나의 가시성 지표가 이 두 목표를 뭉개 중요한 정보를 잃는다고 적어요 [1]. 링크 노출과 유입이 목적이면 인용 폭이, 답변 서술을 누가 만드느냐가 목적이면 흡수가 더 중요한 축이에요. 저자들도 이 프로필이 플랫폼의 영구 법칙이 아니고, 인용 표시 방식이나 답변 길이 차이가 섞여 있을 수 있다고 밝혀요 [1].
FAQ 형식으로 쓰면 AI 검색에 더 잘 인용될까요?
이 연구에서는 Q&A 형식만으로 흡수가 늘지 않았어요. Q&A 형식 페이지의 평균 흡수 점수는 0.0947로, 그렇지 않은 페이지의 0.1005보다 5.74% 낮았어요 [1]. 반면 코드가 있는 페이지는 76.88%, 숫자·통계는 61.55%, 정의는 57.33%, 비교는 55.28%, 절차는 41.20% 높았어요 [1].
| 페이지에 있는 요소 | 있음 | 없음 | 차이 |
|---|---|---|---|
| 코드 | 0.1747 | 0.0988 | +76.88% |
| 숫자·통계 | 0.1171 | 0.0725 | +61.55% |
| 정의 표지 | 0.1252 | 0.0795 | +57.33% |
| 비교 내용 | 0.1389 | 0.0894 | +55.28% |
| 절차(how-to) | 0.1296 | 0.0918 | +41.20% |
| Q&A 형식 | 0.0947 | 0.1005 | −5.74% |
표 2. 증거 유형별 평균 흡수 점수 [1].
저자들은 이 결과를 "FAQ가 해롭다"로 읽지 말라고 해요 [1]. Q&A는 짧고 고립된 답을 만들기 쉬워서 복합 질문에 필요한 증거 밀도가 부족할 수 있고, 얇은 지원 FAQ와 상세 설명 문서가 같은 형식으로 분류되는 잡음도 있다는 해석이에요. 저자들은 가치가 헤딩의 물음표가 아니라 페이지 안의 증거에서 나온다고 해석해요. FAQ 리치 결과 종료 뒤 본문 Q&A 근거 구조로 전환하자고 쓴 글과 같은 방향이에요.
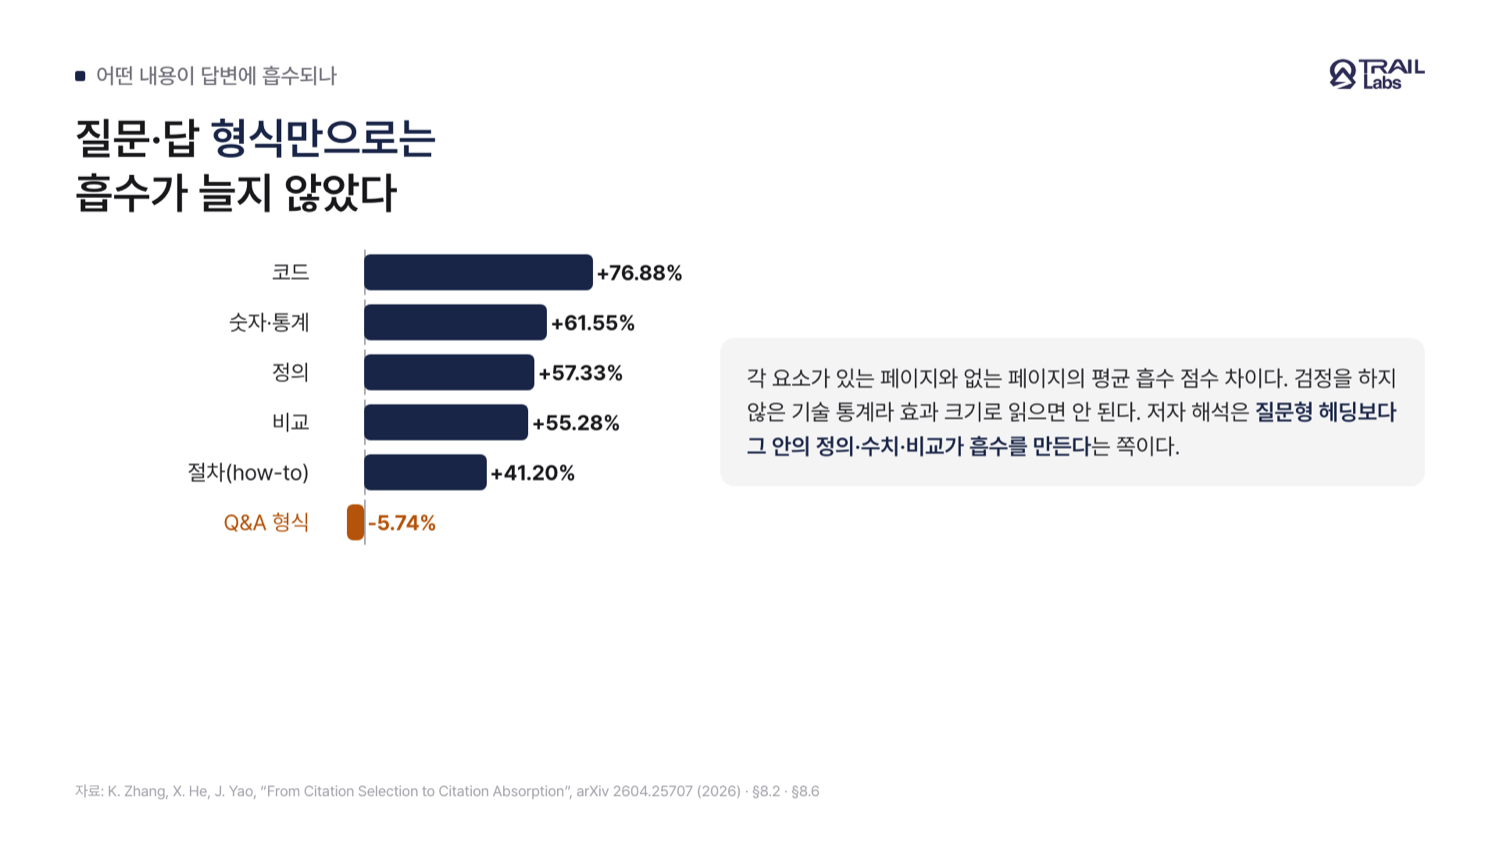
그림 2. 증거 유형별 흡수 점수 차이.
AI 답변에 반영되는 콘텐츠는 어떻게 써야 할까요?
질문에 맞는 정의·수치·비교를 구조 있게 담은 페이지가 더 많이 흡수됐어요. 관측된 차이일 뿐, 이렇게 바꾸면 오른다는 처방으로 확인된 것은 아니에요. 흡수 상위 25% 페이지는 하위 25%보다 단어 수가 11.44배, 소제목이 12.50배, 목록 밀도가 8.94배였고, 답변과의 의미 유사도는 2.31배 높았어요 [1]. 단일 피처 중에서는 언어 모델이 매긴 질문 관련도가 r=0.4322로 흡수와 가장 강하게 같이 움직였어요 [1].
길이만 늘리면 된다는 뜻은 아니에요. 저자들은 단어 수 구간별로 흡수가 대체로 늘지만 301–1,000단어 구간에서 정체가 있었다고 적고, 길이는 구조·정합·증거 밀도와 결합될 때만 의미가 있다고 해요 [1]. 구조가 편집 품질의 대리 지표일 가능성도 스스로 경고해요.
어떤 역할로 쓰였는지도 갈렸어요. 답변에 정의를 공급한 인용의 평균 흡수는 0.1531, 비교는 0.1524였고, 참조로만 붙은 인용은 0.0529였어요 [1]. 사실 출처로 쓰인 인용은 0.1241, 배경으로만 쓰인 인용은 0.0775였어요 [1]. 도메인 유형별로는 백과사전이 0.2144로 가장 높았고, 뉴스 매체는 0.0726으로 자주 인용되면서도 가장 얕게 흡수됐어요 [1].
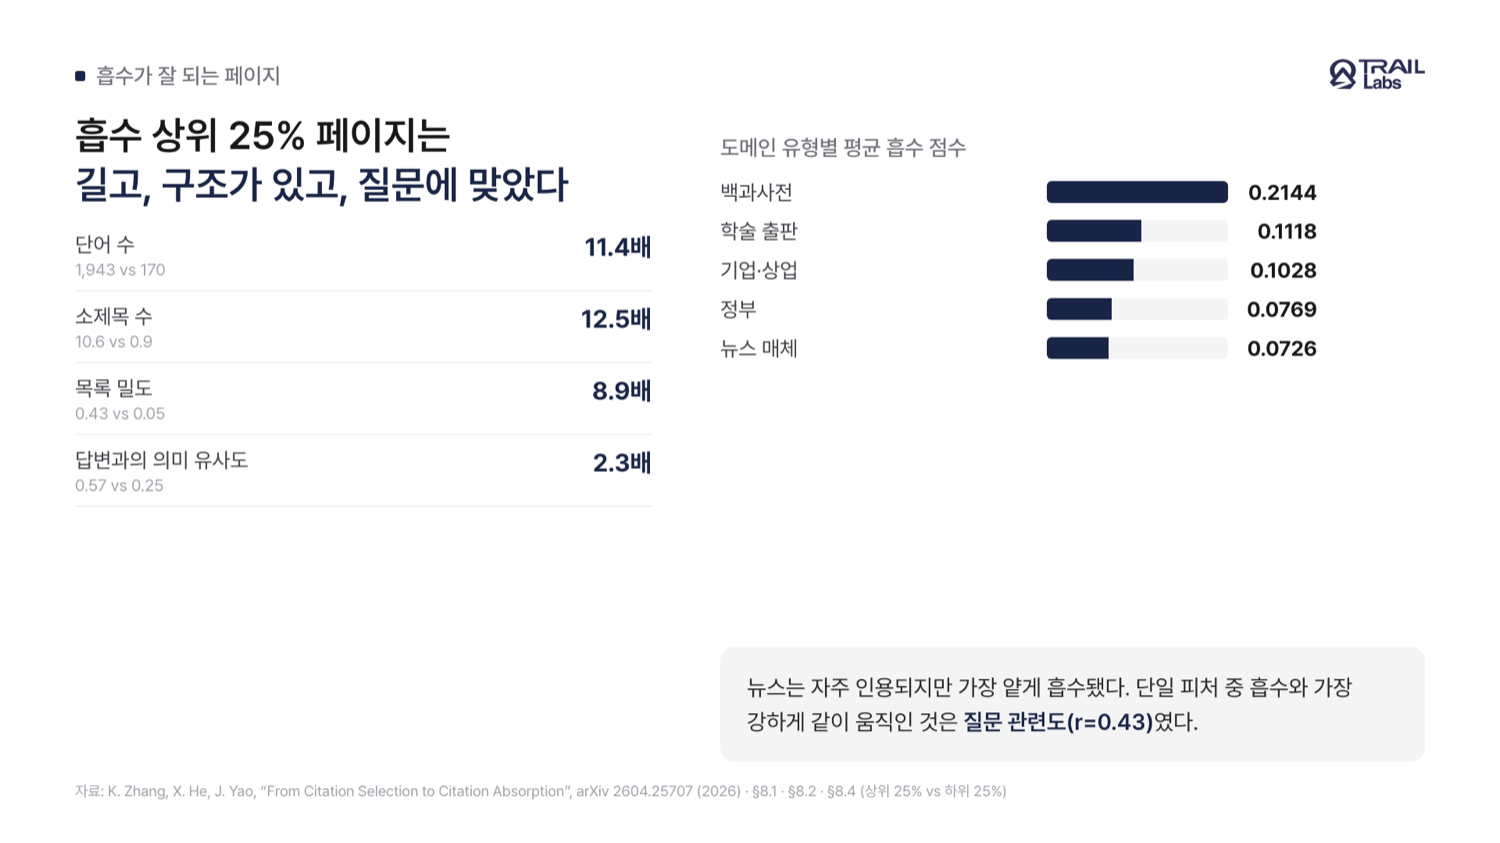
그림 3. 흡수가 잘 되는 페이지의 모습과 도메인 유형별 흡수.
같은 질문도 말투와 언어에 따라 인용이 달라질까요?
같은 내용이라도 질문을 어떻게 하느냐에 따라 플랫폼의 반응이 달랐어요. 출처를 달라고 요구한 질문에서 Google은 평균 15.90개, Perplexity는 17.15개를 인용해 가장 넓어졌고, ChatGPT는 전문가 역할을 준 질문에서 7.95개로 가장 많이 인용했어요 [1]. 반응하는 말투가 플랫폼마다 반대였어요.
언어도 한 방향으로 작용하지 않았어요. ChatGPT는 중국어 질문에 7.77개, 영어 질문에 7.03개를 인용했지만, Google은 중국어 7.53개, 영어 11.57개였어요 [1]. 영어로 물으면 언제나 인용이 넓어진다는 가정은 이 데이터에서 성립하지 않았어요.
조건이 많은 복잡한 질문에서는 차이가 더 벌어졌어요. 여러 제약을 한꺼번에 건 질문에서 ChatGPT는 평균 3.4개만 인용했고, Google은 12.6개, Perplexity는 17.7개를 인용했어요 [1]. 저자들은 복잡도가 한 플랫폼에서는 내부 합성으로 압축을, 다른 플랫폼에서는 검색 확장을 부른 것으로 해석하지만, 인과로 확인한 것은 아니라고 덧붙여요. 한국어 질문은 이 실험에 없어서, 한국어에서 어느 쪽으로 움직이는지는 따로 재야 해요.
한계
가장 큰 한계는 흡수 점수가 프록시라는 점이에요. 모델 내부의 주의 집중이나 실제 검색 기록을 본 값이 아니고, 답변과 페이지의 텍스트 겹침과 위치로 만든 가중합이에요 [1]. 가중치를 바꿔 보는 강건성 검정도 향후 과제로만 남아 있어요.
통계적 확인도 없어요. p값, 신뢰구간, 다중 비교 보정이 전부 빠져 있고, 저자들은 이것을 의도한 선택이라고 밝혀요 [1]. 이 글의 모든 차이는 효과 크기보다 평균 차이로 읽어야 해요.
표본과 시점도 좁아요. 질문 602개는 설계된 표본이고(ChatGPT는 출력 누락으로 587개 기준), 언어 대조는 중국어와 영어뿐이며, 모델 버전과 수집 날짜가 기록되지 않은 한 시점의 스냅샷이에요 [1]. 본문을 가져오지 못한 23.56%의 인용은 분석 밖이에요.
TRAIL에서는
TRAIL Search의 인사이트 화면에는 이 논문을 근거로 만든 "답변 흡수(실험)" 카드가 있어요. 엔진 답변이 인용한 페이지의 본문을 가져와, 그 페이지가 답변 문장을 실제로 얼마나 만들었는지 계산하고 자사 흡수율로 보여 줘요.
계산은 논문 공식에서 재참조 횟수와 첫 등장 위치를 뺀 변형이에요. 엔진마다 답변 안 참조 표시가 없는 경우가 있어서, 문단 커버리지·TF-IDF·단어 묶음 겹침 세 성분만 다시 가중했어요. 한국어는 조사를 떼어 어간끼리 비교하고, 같은 측정 회차 안 상위 사분위를 흡수로 봐요(측정 표본이 적은 회차는 고정 기준을 써요). 아직 분포를 맞추는 중이라 점수에는 넣지 않는 실험 지표예요.
이 논문이 보여 준 플랫폼 차이를 한국어 답변에서도 재 보는 것이 다음 질문이에요. 어제 다룬 브랜드 언급 단계 모형은 노출과 선택까지를 봤어요 [3]. 흡수는 그다음 단계예요.
Frequently asked questions
AI 검색이 인용한 페이지는 답변에 얼마나 반영되나요?
플랫폼마다 크게 달라요. 질문 602개를 쓴 이 연구에서 인용된 페이지의 평균 흡수 점수(0–1)는 ChatGPT 0.2713, Google 0.0584, Perplexity 0.0646이었어요. 링크가 붙는 것과 페이지 내용이 답변 문장을 실제로 만든 것은 다른 일이에요.
ChatGPT와 Perplexity 중 어디가 출처를 더 깊이 쓰나요?
이 연구에서는 ChatGPT였어요. ChatGPT는 질문당 평균 6.88개만 인용했지만 인용한 페이지를 가장 깊이 썼고, Perplexity는 16.35개를 인용하면서 페이지당 흡수는 얕았어요. 설계된 질문 표본으로 찍은 한 시점의 기술 통계예요.
FAQ 형식으로 쓰면 AI 검색에 더 잘 인용되나요?
이 연구에서 Q&A 형식 페이지의 평균 흡수 점수는 그렇지 않은 페이지보다 5.74% 낮았어요. 반면 코드, 숫자, 정의, 비교가 있는 페이지는 41–77% 높았어요. 저자들은 질문형 헤딩보다 그 안에 담긴 정의·수치·비교가 흡수를 만든다고 해석해요.
AI 답변에 반영되는 콘텐츠는 어떻게 써야 하나요?
흡수 상위 25% 페이지는 하위 25%보다 단어 수가 11.4배, 소제목이 12.5배 많았고 답변과의 의미 유사도가 2.3배 높았어요. 단일 피처 중 흡수와 가장 강하게 같이 움직인 것은 질문 관련도(r=0.43)였어요. 질문에 맞는 정의·수치·비교를 구조 있게 담은 페이지가 더 흡수됐다는 관측이고, 처방으로 검증된 것은 아니에요.
References
- [1]Zhang Kai, He Xinyue & Yao Jingang, "From Citation Selection to Citation Absorption: A Measurement Framework for Generative Engine Optimization Across AI Search Platforms", arXiv 2026
- [2]geo-citation-lab, GEO 실험 데이터·리포트 저장소 (GitHub)
- [3]Benjamin Tannenbaum, "From Prompt to Recommendation: A Fitted Stage Model of Brand Visibility in AI Search", arXiv 2026
Summary
- 이 연구는 AI 검색의 결과를 인용 선택(링크가 붙는가)과 인용 흡수(페이지가 답변 문장을 실제로 만들었는가)로 나눠 쟀어요.
- 질문당 평균 인용은 ChatGPT 6.88개, Google 12.06개, Perplexity 16.35개였지만 평균 흡수 점수는 0.2713, 0.0584, 0.0646으로 순서가 뒤집혔어요.
- 코드·숫자·정의·비교가 있는 페이지는 흡수 점수가 41–77% 높았고, Q&A 형식만 있는 페이지는 5.74% 낮았어요.
- 흡수 상위 25% 페이지는 길고 구조가 있었으며, 단일 피처 중에서는 질문 관련도(r=0.43)가 흡수와 가장 강하게 같이 움직였어요.
- 검정 없는 기술 통계이고 흡수 점수는 텍스트 겹침으로 만든 프록시라, 방향으로 읽어야 해요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility