AI는 브랜드 정보를 어디서 가져올까: 인용 출처 85.7%는 제3자
유럽 12개 시장·13개 언어에서 AI가 브랜드 답변에 단 인용 167,551건을 분류한 연구
AI가 브랜드에 대해 답할 때 근거로 단 URL 인용의 85.7%는 그 브랜드가 소유하지 않은 사이트를 가리켰어요. 유럽 12개 시장, 13개 언어, 128개 브랜드에 대해 검색을 붙인 AI 모델이 단 인용 167,551건을 하나씩 분류한 연구의 결론이에요 [1]. 이 연구는 답변에 무엇이 쓰였는지보다 한 단계 앞, 답변을 쓰기 전에 모델이 무엇을 읽었는지를 봤어요. 자사 사이트는 14.3%에 그쳤고, 위키백과가 거의 모든 언어에서 1위 출처였지만 그 점유는 4–6%였어요.
이 글은 arXiv에 공개된 논문 원문 v1을 읽고, 본문의 수치를 논문의 표 1–6에 대조해 정리했어요. 모든 수치는 논문 데이터 기준이고, 우리는 재현하지 않았어요. 저자는 AI 브랜드 인텔리전스 도구를 만드는 회사에 소속돼 있고, 분석한 세 데이터셋이 그 회사의 연구 데이터라는 이해관계를 논문에 밝혀요 [1]. 대신 데이터와 분석 코드를 Zenodo에 CC BY 4.0으로 공개해 누구나 수치를 다시 낼 수 있게 했어요. 논문 안에서 폴란드 수치 하나가 두 가지로 적혀 있어 그 부분은 비율만 옮겼어요. 우리도 AI 검색 진단 도구를 운영하는 회사라서, 마지막 섹션에서 우리 제품과 연결되는 부분은 따로 표시했어요.
왜 AI 답변보다 인용 출처를 봐야 할까
검색을 붙인 모델은 먼저 웹페이지를 가져오고, 가져온 페이지로 답을 쓰기 때문에 모델이 읽은 출처가 모델이 할 수 있는 말의 범위를 정해요 [1]. 대부분의 AI 브랜드 가시성 모니터링은 답변 텍스트를 봐요. 추천됐는가, 어조는 어떤가, 경쟁사가 같이 나왔는가예요. 이 연구는 그보다 한 단계 앞의 질문을 던져요. AI는 우리 브랜드에 대한 정보를 어디서 가져오는가, 그리고 우리가 그 출처에 영향을 줄 수 있는가예요.
이 질문이 실무적인 이유는 답이 정반대의 전략으로 이어지기 때문이에요. AI가 주로 자사 사이트를 읽는다면 자사 사이트를 잘 쓰면 되고, 주로 제3자를 읽는다면 브랜드가 통제하지 못하는 곳에서 언급을 얻어야 해요. 어느 쪽인지 알려면 출처를 세야 해요.
인용이 출처를 정확히 비추는 거울은 못 된다는 점도 중요해요. 생성형 검색 엔진의 검증 가능성을 감사한 연구에서는 생성된 문장 중 인용으로 완전히 뒷받침되는 문장이 51.5%였고, 붙은 인용 중 그 문장을 실제로 뒷받침하는 인용은 74.5%였어요 [3]. 그래서 이 연구는 인용 구성을 측정할 뿐, 그것이 실제 평판이나 사람들의 인식과 같다고 주장하지 않는다고 처음부터 선을 그어요 [1]. 측정 대상은 "AI가 무엇을 인용했는가"까지예요.
데이터와 방법: 세 데이터셋, 167,551건의 URL 인용
이 연구는 측정 도구 회사가 모은 인용 데이터셋 세 개를 합쳤어요 [1]. 각각 검색을 붙인 LLM에 브랜드에 대해 묻고 모델이 단 출처를 기록한 데이터예요.
| 데이터셋 | 기록 단위 | 규모 |
|---|---|---|
| 북유럽·발트 (NB) | 브랜드 × 언어 × 모델 × 프롬프트 × 인용 | 150,093행 |
| 폴란드 (PL) | 브랜드 × 프롬프트 × 모델 × 반복 | 4,151건 기록, 인용 35,880건 |
| 중동부 유럽 (CEE) | 출처 언급 귀속 | 4,001행 (URL 있는 행 157개) |
표 1. 합친 세 데이터셋의 구성. 도메인 분석이 가능한 URL 인용은 NB 131,514건, PL 35,880건, CEE 157건으로 모두 167,551건이에요 [1].
다룬 브랜드는 128개, 언어는 13개, 자국 시장은 12개예요. 체코, 덴마크, 에스토니아, 핀란드, 독일, 라트비아, 리투아니아, 노르웨이, 폴란드, 슬로바키아, 스웨덴과 헝가리예요 [1]. 북유럽·발트 데이터의 모델은 Perplexity Sonar Pro, Gemini 3.1 Pro, GPT-5.4였어요. 저자는 합친 데이터를 하나의 균질한 표로 볼 수 없다는 점을 먼저 밝혀요. 실제 도메인으로 풀리는 URL을 가진 것은 NB와 PL뿐이고, CEE는 출처의 96.1%를 "주요 뉴스" 같은 키워드로만 귀속했어요. 그래서 도메인 단위의 모든 수치는 NB와 PL의 URL 데이터로 계산했어요.
분류 방법은 단순해요 [1]. 각 인용 URL을 등록 도메인으로 줄이고, 위키백과의 언어별 하위 도메인은 wikipedia.org 하나로 합쳤어요. 인용 도메인에 브랜드 이름 토큰이 들어 있으면 자사 인용으로 셌어요. 예를 들어 Wise 브랜드의 wise.com이에요. 데이터에는 회사 웹사이트, 위키백과, 산업 리포트, 주요 뉴스, 소셜, 리뷰 플랫폼, 정부, 기타 웹 같은 출처 유형 라벨도 붙어 있어서, 저자는 도메인 기준과 라벨 기준을 함께 보고하고 라벨이 오해를 부르는 곳을 따로 표시했어요.
AI 브랜드 답변의 인용 출처, 자사 사이트는 14.3%예요
북유럽·발트 데이터의 URL 인용 131,514건 중 85.7%가 브랜드가 소유하지 않은 사이트를, 14.3%가 자사 도메인을 가리켰어요 [1]. URL 없이 모델 내부 지식으로 답한 행까지 포함한 150,093행 기준으로는 자사 14.4%, 제3자 76.1%, 암묵 지식 9.5%예요. 어느 기준으로 세도 AI는 브랜드에 대해 자사 사이트보다 제3자를 4–6배 더 많이 읽었어요.
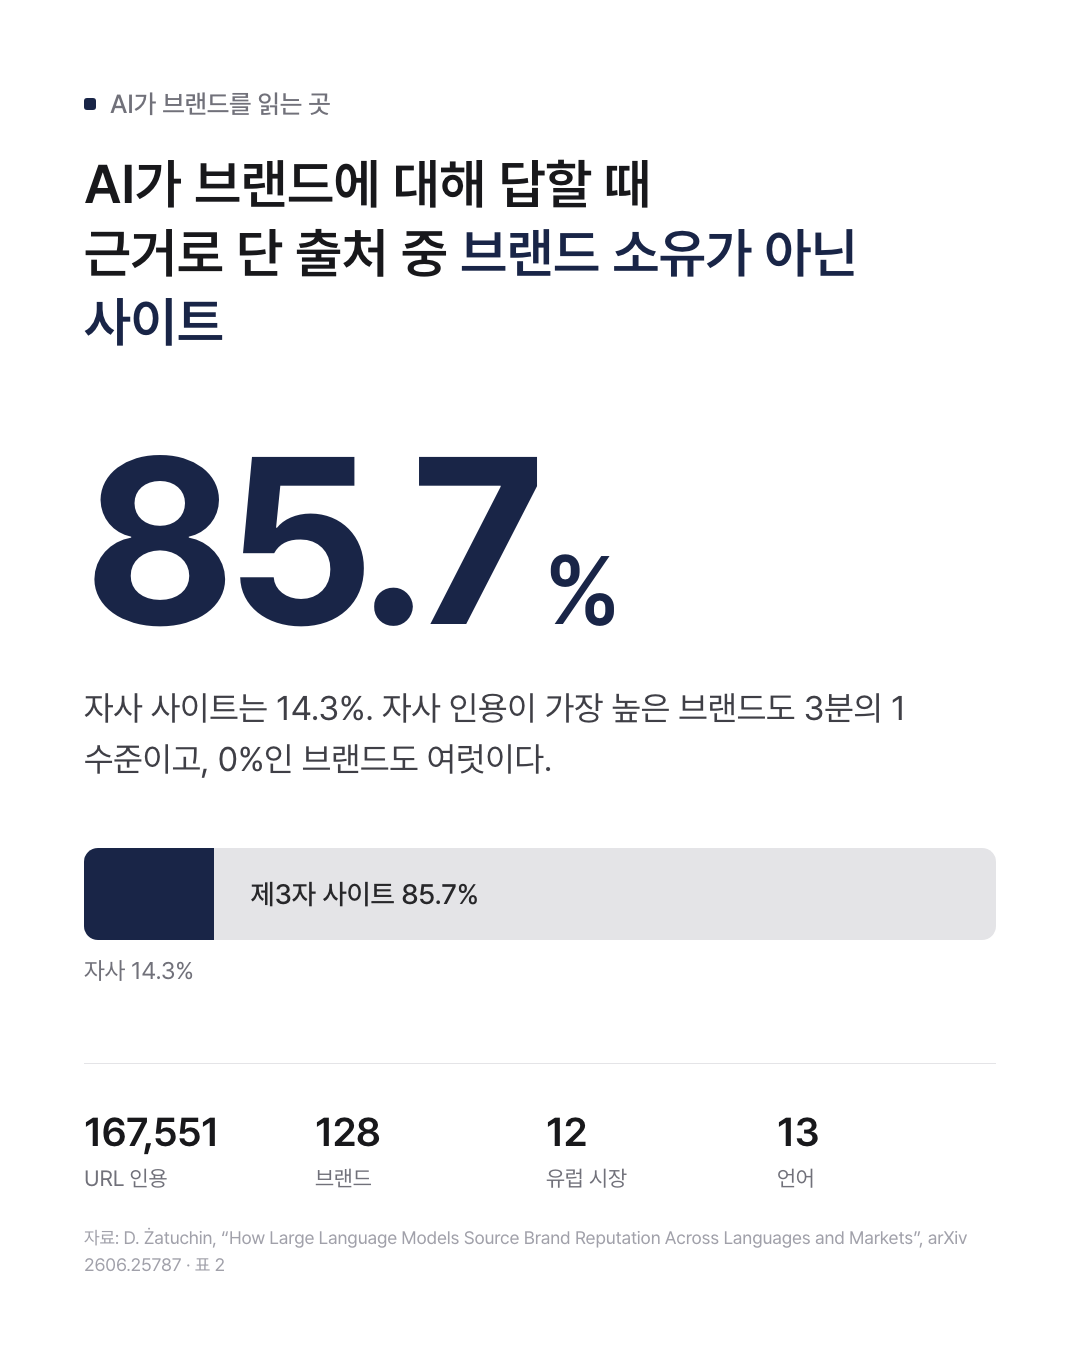
그림 1. 제3자 사이트 85.7%와 자사 14.3%의 비율 막대, 그리고 URL 인용 167,551건·브랜드 128개·유럽 시장 12개·언어 13개라는 연구 규모. 논문 표 2의 값으로 우리가 그린 카드예요 [1].
| 구분 | 자사 | 제3자 |
|---|---|---|
| 전체 URL 인용 | 14.3% | 85.7% |
| 회사 웹사이트 라벨 기준 | 16.4% | 83.6% |
| B2B 브랜드 | 13.1% | 86.9% |
| B2C 브랜드 | 15.7% | 84.3% |
표 2. 자사 대 제3자 인용 비중, 북유럽·발트 URL 인용 131,514건 기준 [1].
B2B와 B2C의 차이는 작았어요. B2C 브랜드가 조금 더 자사 인용을 받았을 뿐 방향은 같아요. 자사 인용은 사라지지 않고 일부 브랜드에 몰려요 [1]. 인용이 1,500건 이상인 브랜드 중 자사 비중이 가장 높은 곳은 Tatra Banka 34.4%, Statkraft 33.9%, ESET 33.2%, Wise 32.4%였어요. 가장 잘 된 경우도 3분의 1이에요. 반대편에는 Slovak Telekom, PKN Orlen, Kiwi.com처럼 자사 인용이 0.0%인 브랜드가 여럿 있었어요. AI가 이 브랜드들을 설명하면서 그 브랜드의 사이트를 한 번도 근거로 쓰지 않았다는 뜻이에요.
이 방향은 앞선 연구와도 맞아요. 생성형 검색 최적화를 다룬 연구는 AI 검색이 브랜드 소유 콘텐츠보다 제3자 권위 매체를 체계적으로 선호한다고 보고했어요 [2]. 이 논문은 같은 경향을 개별 브랜드 인용 수준에서 다국가 데이터로 확인한 셈이에요.
인용 출처는 소수 도메인에 몰려 있어요
AI가 브랜드에 대해 읽는 웹은 넓지만, 인용의 대부분은 작은 머리 부분에서 나와요 [1]. 등록 도메인 20,815개 중 3,778개, 약 18.2%가 전체 인용의 80%를 가져갔어요. 호스트 기준으로는 547개(2.3%)가 인용의 절반을 차지했고, 나머지 20%의 인용이 1만 7천여 개의 꼬리 도메인에 흩어졌어요.
저자는 상위 1,000개 도메인 순위에 대해 로그-로그 회귀로 Zipf 법칙을 적합했어요 [1].
은 위 도메인이 받는 인용 수예요. 지수가 0.86이라는 것은 순위가 두 배 내려갈 때마다 인용이 대략 절반을 조금 넘게 남는다는 뜻이고, 0.983은 이 단순한 법칙이 상위 1,000위 분포를 거의 그대로 설명한다는 뜻이에요. 꼬리는 실재하지만 얇아요.
출처 유형 라벨로 보면 "기타 웹"이 77.0%로 압도적이고, 자사 16.4%, 위키백과 3.9%, 산업 리포트 1.0%, 주요 뉴스 0.7%, 소셜 0.4%, 리뷰 플랫폼 0.3%, 정부 0.1% 순이었어요 [1]. 저자는 이 표를 그대로 읽지 말라고 적어요. 라벨 분류기가 실제 뉴스와 리뷰 도메인 대부분을 기타 웹으로 떨어뜨렸기 때문이에요. 정직한 요약은 "열린 제3자 웹이 어떤 큐레이션된 범주보다 지배적인 근거"라는 거예요. 전체 데이터에서 가장 많이 인용된 도메인은 위키백과(5,800건), YouTube(2,826건), Statista(1,310건)였고, 그 뒤로 브랜드 자사 사이트들과 Reddit 같은 소셜 플랫폼이 이어졌어요.
언어가 바뀌면 1위 인용 출처가 바뀌어요
위키백과는 12개 언어 중 11개에서 가장 많이 인용된 도메인이었지만, 시장마다 위키백과를 앞서는 현지 출처가 따로 있었어요 [1]. 위키백과의 점유는 폴란드어 3.71%에서 핀란드어 5.70% 사이였어요. "위키백과가 지배한다"는 말은 1위라는 뜻이지 대부분이라는 뜻이 아니에요.
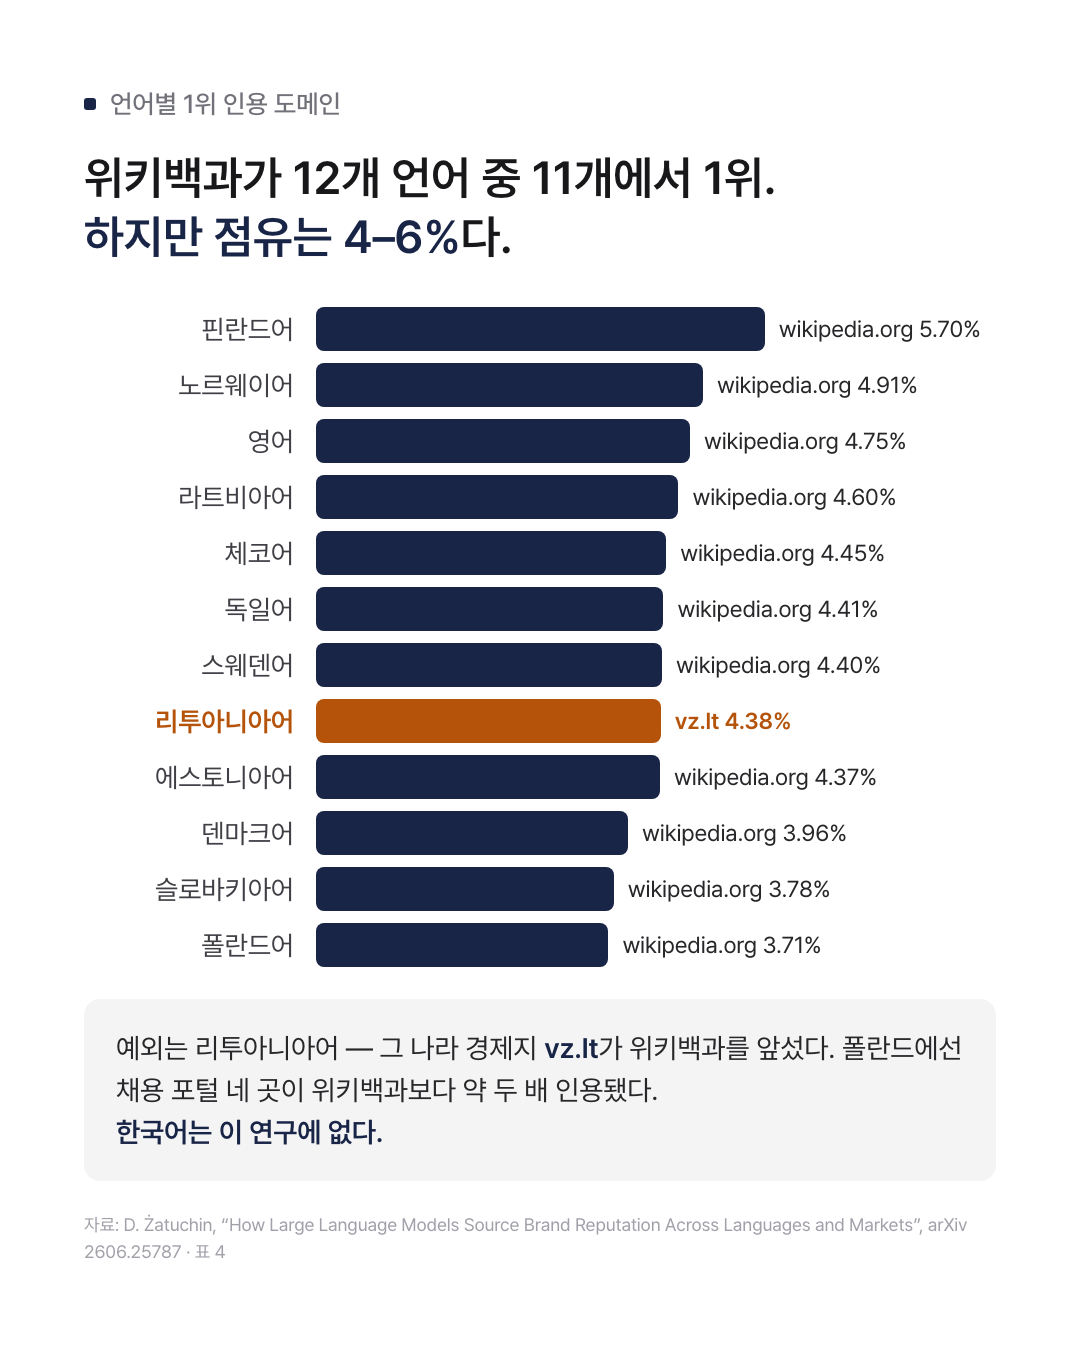
그림 2. 언어별 1위 인용 도메인. 11개 언어에서 wikipedia.org가 3.71–5.70%로 1위이고, 리투아니아어만 vz.lt(4.38%)가 1위예요. 아래 상자는 폴란드의 채용 포털 사례와 한국어가 연구에 없다는 점을 적었어요. 논문 표 4의 값으로 우리가 그린 카드예요 [1].
유일한 예외인 리투아니아어에서는 그 나라 경제지 Verslo žinios(vz.lt)가 4.38%로 위키백과를 앞섰어요 [1]. 저자는 이 예외가 교훈적이라고 봐요. 영어만 보거나 위키백과 중심으로만 AI 출처를 보면 바로 이런 현지 경제지를 놓치고, 이런 출처는 백과사전이 채우지 못하는 공간을 현지 언론이 채우는 작은 언어 시장에서 나타나요.
폴란드는 더 선명해요 [1]. 46개 폴란드 자국 브랜드의 인용 35,880건에서 가장 많이 인용된 단일 도메인은 YouTube(6.4%)였고, 가격 비교·마켓플레이스 사이트인 ceneo.pl과 allegro.pl이 뒤를 이었어요. 그 바로 아래에서 채용·커리어 포털 네 곳(pl.indeed.com, livecareer.pl, interviewme.pl, randstad.pl)이 합쳐서 폴란드어 위키백과보다 약 두 배 많이 인용됐어요. 채용 리뷰 사이트가 강한 시장에서는 AI가 브랜드를 설명할 때 그 사이트를 읽는다는 뜻이에요. 커리어 포털에서 브랜드가 어떻게 보이는지가 백과사전 항목보다 AI 답변에 더 많이 들어갈 수 있는 거예요.
흥미롭게도 출처 유형의 비율은 언어 사이에 거의 같았어요. 카이제곱 검정은 유의했지만(χ² = 1906.4, p < 0.001) 효과 크기 Cramér's V는 0.036으로 아주 작았어요 [1]. 표본이 이만큼 크면 유의성은 쉽게 나오고, 작은 V가 정직한 요약이에요. 언어마다 달라지는 것은 출처 유형의 구성보다 그 시장에서 어느 도메인이 1위를 하느냐예요. 어족별로 보면 우랄어(에스토니아어·핀란드어)와 발트어(리투아니아어·라트비아어) 답변이 자사 사이트와 위키백과에 조금 더 기댔고(자사 15.5%·15.0%), 슬라브어(폴란드어·체코어·슬로바키아어)가 가장 덜 기댔어요(자사 12.5%). 저자는 현지어 웹이 얇은 언어일수록 AI가 자사 사이트와 백과사전으로 물러난다고 해석해요.
Gemini 인용 23,027건은 구글 리다이렉트 주소로 들어왔어요
이 논문에서 측정 실무에 가장 쓸모 있는 부분은 결과가 아닌 방법 절의 한 문단이에요 [1]. 북유럽·발트 데이터에서 23,027행, URL 행의 17.5%가 실제 출처 도메인 대신 vertexaisearch.cloud.google.com이라는 리다이렉트 호스트를 담고 있었어요. 전부 Gemini 인용이었고, Gemini 인용 23,032건의 사실상 전부예요. Gemini API의 Google 검색 그라운딩으로 받은 인용 링크가 원문 주소가 아닌 구글의 중계 주소였던 거예요. 실제 도메인은 인용의 제목 필드에 있었고, 저자는 23,027건을 전부 제목에서 복원했어요.
저자는 이 단계를 "하중을 받는" 단계라고 불러요 [1]. 복원하지 않으면 리다이렉트 호스트가 모든 언어에서 1위 도메인이 되고, 위키백과는 모든 언어에서 1위를 잃어요. 폴란드 데이터에서도 Gemini 인용이 google.com 리다이렉트 주소로 들어와 같은 방식으로 복원했어요.
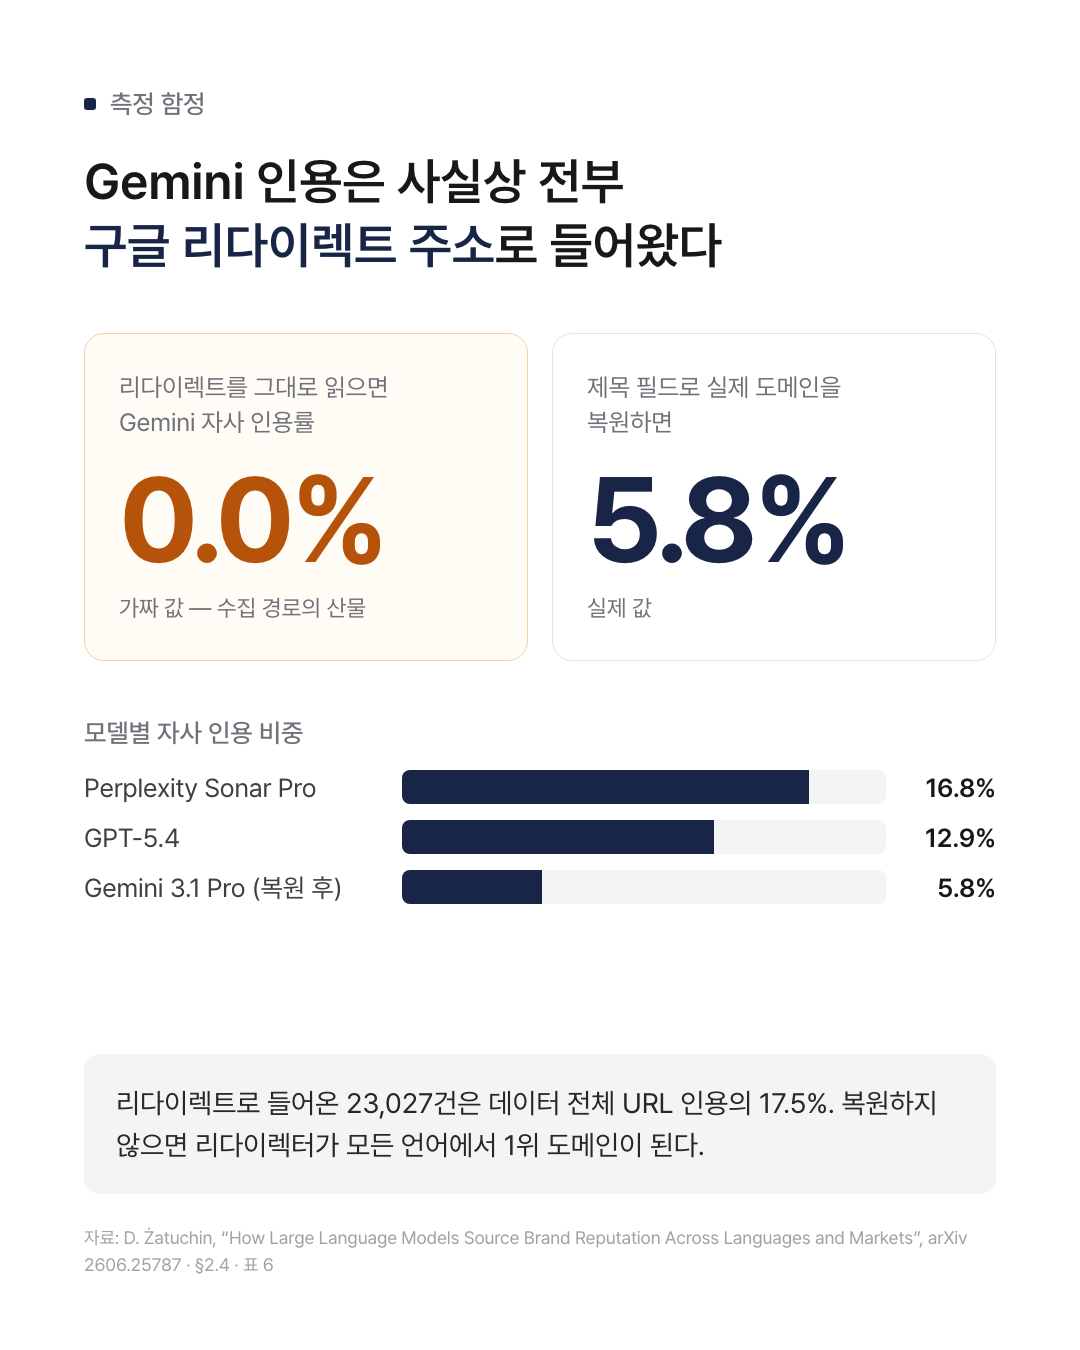
그림 3. Gemini 리다이렉트 함정. 리다이렉트를 그대로 읽은 자사 인용률 0.0%와 복원한 값 5.8%, 그리고 모델별 자사 인용 비중(Perplexity Sonar Pro 16.8%, GPT-5.4 12.9%, Gemini 3.1 Pro 복원 후 5.8%). 논문 §2.4와 표 6의 값으로 우리가 그린 카드예요 [1].
| 모델 | 인용 수 | 도메인 수 | 자사 (도메인 기준) | 자사 (라벨 기준) | 위키백과 |
|---|---|---|---|---|---|
| Perplexity Sonar Pro | 90,276 | 15,995 | 16.8% | 20.7% | 4.9% |
| Gemini 3.1 Pro | 23,032 | 6,568 | 5.8% | 0.0% | 2.6% |
| GPT-5.4 | 18,206 | 3,284 | 12.9% | 16.2% | 4.3% |
표 3. 모델별 인용 행태, 북유럽·발트 데이터의 리다이렉트 복원 후 기준 [1].
라벨 기준으로 Gemini의 자사 인용이 0.0%인 이유는 출처 유형 분류기가 실제 도메인 대신 리다이렉트 주소 위에서 돌았기 때문이에요 [1]. 복원한 도메인으로 다시 세면 5.8%예요. 폴란드 데이터에서도 Gemini는 리다이렉트 때문에 자사 0.0%로 나왔어요(Perplexity 18.7%, OpenAI 11.7%). 저자의 결론은 분명해요. 모델 간 자사 인용률을 비교하려면 리다이렉트 복원이 먼저이고, 그러지 않으면 모델의 수집 산물을 브랜드에 대한 발견으로 보고하게 돼요.
이 함정은 이 논문만의 일이 아니에요. 발리 식당 4,776곳을 전수 조사한 AI 추천 감사 연구도 Gemini API가 근거 링크를 중계 주소로만 돌려줘서 인용 제목에서 실제 도메인을 복원했다고 밝혀요 [4]. 서로 다른 두 연구가 같은 처리를 따로 했다는 것은, Gemini 인용을 다루는 모든 측정에 이 단계가 필요하다는 신호예요. 모델별 차이 자체도 컸어요. Perplexity가 북유럽·발트 인용의 68.6%를 차지할 만큼 가장 많이, 가장 넓게(15,995개 도메인) 인용했고, GPT-5.4는 좁은 도메인 집합(3,284개)에 기댔어요.
이 연구의 한계
가장 큰 한계는 지역이에요. 12개 시장이 전부 유럽이고, 한국을 비롯한 아시아 시장은 데이터에 없어요 [1]. 이 연구의 비율을 한국어 답변에 그대로 옮길 근거는 없어요.
데이터 구조의 한계도 저자가 직접 적어요 [1]. 세 데이터셋은 관련은 있지만 같지 않은 프로토콜로 모였고, 그래서 합친 결과는 NB와 PL의 URL 백본에 CEE를 교차 연결한 형태예요. 자사 판정은 도메인에 브랜드 이름이 들어 있는가라는 휴리스틱이라, 브랜드 이름이 없는 자사 도메인은 놓치고 우연히 이름이 들어간 제3자 도메인은 자사로 셀 수 있어요. 인용은 답변 단위로 붙기 때문에, 모델이 여러 브랜드를 나열하고 출처 하나를 달면 그 출처가 나열된 모든 브랜드에 붙어요.
시간과 버전의 한계도 있어요. 데이터는 특정 모델 버전과 특정 수집 기간을 반영하고, 검색을 붙인 모델은 검색 방식을 자주 바꿔요 [1]. 도메인 점유와 모델별 수치는 시점과 버전에 따라 달라져요.
수치 하나는 논문 안에서 일치하지 않아요. 폴란드 채용 포털과 위키백과의 인용 수가 초록·결과·결론에서는 한 쌍의 값으로, 한계 절에서는 다른 쌍의 값으로 적혀 있어요 [1]. 두 쌍 모두 비율은 약 두 배라서, 우리는 이 글에서 "약 두 배"라는 비율만 옮겼어요. 마지막으로, 데이터를 모은 주체가 이 질문과 맞닿은 도구를 파는 측정 회사라는 이해관계가 있어요. 저자는 회사가 설계와 해석에 따로 개입하지 않았다고 밝히고 데이터와 코드를 공개했지만, 우리는 이 결과를 재현해 보지 않았어요.
AEO/GEO 실무에 어떻게 쓸까
저자가 데이터에서 직접 끌어내는 실무 결론은 네 가지예요 [1]. 첫째, 자사 사이트에만 기대지 말고 제3자 언급을 얻어야 해요. 명확한 회사 페이지는 필요하지만 AI가 브랜드를 주로 읽는 곳은 아니에요. 둘째, 분포의 머리를 잡아야 해요. 인용의 80%가 약 18%의 도메인에서 나오니, 꼬리에 흩어진 언급보다 머리 도메인에서의 언급이 더 값져요. 셋째, 위키백과는 거의 모든 언어에 걸친 공통 출처이고, 현지 매체는 시장마다 따로 있어요. 넷째, 시장별로, 그리고 모델별로 감사해야 해요. 영어 하나, 모델 하나로 본 감사는 AI가 브랜드를 읽는 곳의 한 조각만 보여 줘요.
이 결론은 우리가 앞서 정리한 글들과 같은 방향이에요. 오프사이트 AEO: 사이트가 완벽한데 AI가 인용하지 않는 이유에서 다룬 사이트 밖 출처 지도, AI 검색엔진은 어떤 브랜드를 언급할까에서 본 다섯 AI 엔진의 제3자 중심 출처 구성, 그리고 AEO는 누구의 일인가에서 브랜드 합의를 SEO팀 밖까지 넓혀야 한다고 쓴 것이 이 연구의 다국가 데이터로 한 번 더 뒷받침돼요.
TRAIL 관점에서 이 논문은 우리 코드를 점검하게 만들었어요. TRAIL Search의 진단은 엔진이 단 인용 URL을 자사, 위키(나무위키 포함), 유튜브, 리뷰·커뮤니티(네이버 블로그·카페 포함), 매체, 리스티클로 나눠요. 이 논문을 읽고 Gemini 리다이렉트 문단이 우리 파이프라인에도 해당하는지 확인했고, 해당했어요. 우리 파이프라인도 Gemini 인용의 vertexaisearch.cloud.google.com 주소를 그대로 도메인으로 읽고 있었고, 그래서 Gemini 인용에서는 자사 출처가 잡힐 수 없는 구조였어요. 지금은 인용 제목 필드에서 실제 도메인을 복원하도록 고쳐 배포했어요. 수집 경로의 처리 방식 하나가 브랜드에 대한 발견처럼 보이는 숫자를 만들 수 있다는 것이 이 논문이 준 가장 실용적인 교훈이에요.
그리고 이 지도에는 한국이 없어요. 한국어 답변이 위키백과와 나무위키 중 어디에 더 기대는지, 네이버 블로그와 카페가 얼마나 근거로 쓰이는지에 대한 공개된 숫자를 우리는 아직 보지 못했어요. 리투아니아의 경제지나 폴란드의 채용 포털처럼 한국에서만 1위인 출처가 있을지도 직접 재 봐야 알 수 있어요. 우리가 다음에 재 보고 싶은 질문이에요.
Frequently asked questions
AI가 브랜드에 대해 답할 때 자사 사이트를 얼마나 인용하나요?
유럽 128개 브랜드를 다룬 이 연구에서는 URL 인용의 14.3%만 브랜드 자사 도메인이었어요. 나머지 85.7%는 브랜드가 소유하지 않은 사이트였어요. 자사 인용이 가장 높은 브랜드도 34% 수준이었고, 0%인 브랜드도 여럿이었어요.
AI 답변에서 가장 많이 인용되는 사이트는 어디인가요?
이 연구의 북유럽·발트 데이터에서는 위키백과가 12개 언어 중 11개에서 가장 많이 인용된 도메인이었어요. 다만 점유는 3.71–5.70%로, 1위라는 뜻이지 대부분이라는 뜻은 아니에요. 리투아니아어에서는 경제지 vz.lt가, 폴란드 브랜드 데이터에서는 YouTube가 1위였어요.
Gemini 인용은 왜 따로 처리해야 하나요?
이 연구에서 Gemini 인용 23,027건이 실제 출처 대신 구글 리다이렉트 주소로 들어왔어요. 실제 도메인은 인용 제목 필드에 있었어요. 복원하지 않으면 리다이렉트 주소가 모든 언어에서 1위 도메인이 되고, Gemini의 자사 인용률은 라벨 기준 0.0%로 잘못 나와요. 복원하면 5.8%예요.
이 결과를 한국 시장에 그대로 적용해도 되나요?
안 돼요. 12개 시장이 전부 유럽이고 한국어 데이터는 없어요. 한국어 답변이 위키백과와 나무위키 중 어디에 기대는지, 네이버 블로그와 카페가 얼마나 근거로 쓰이는지는 이 연구로 알 수 없어요. 방향을 참고하되 수치는 직접 재야 해요.
References
- [1]Dmitrij Żatuchin, "How Large Language Models Source Brand Reputation Across Languages and Markets", arXiv 2026
- [2]Chen, Wang, Chen & Koudas, "Generative Engine Optimization: How to Dominate AI Search", arXiv 2025
- [3]Liu, Zhang & Liang, "Evaluating Verifiability in Generative Search Engines", Findings of EMNLP 2023
- [4]Vladimir Pitenin, "Invisible to the Machine: Auditing AI Restaurant, Café, and Bar Recommendation Against a Complete Market Census", arXiv 2026
Summary
- 유럽 12개 시장·13개 언어·128개 브랜드에서 AI가 답변 근거로 단 URL 인용 167,551건을 도메인과 출처 유형으로 분류한 연구예요.
- 인용의 85.7%가 브랜드가 소유하지 않은 사이트였고 자사는 14.3%였어요. 자사 인용이 가장 높은 브랜드도 3분의 1 수준이었어요.
- 인용의 80%가 도메인의 약 18%에서 나왔고, 도메인 순위 분포는 지수 0.86의 Zipf 법칙에 맞았어요.
- 위키백과가 12개 언어 중 11개에서 1위였지만 점유는 4–6%였고, 리투아니아어는 경제지 vz.lt, 폴란드 브랜드는 YouTube가 1위였어요.
- Gemini 인용 23,027건이 구글 리다이렉트 주소로 들어와, 제목 필드에서 실제 도메인을 복원해야 자사 인용률(0.0%에서 5.8%)과 1위 도메인이 바로 잡혔어요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility