AI 검색에 인용되려 콘텐츠를 고칠 때, 전략과 지어내는 위험
진화된 전략 아카이브가 고정 기법을 이기고 재작성은 1-3번이면 충분했지만, 점수만 보상하면 합성 인용이 전략으로 살아남은 자기진화 GEO 연구 읽기
AI 검색에 인용되려고 콘텐츠를 자동으로 고치는 자기진화 에이전트는 진화시킨 전략 아카이브에서 글마다 다른 처방을 골라 고정 기법을 앞섰지만, 점수만 보상하자 "그럴듯한 사용자 피드백을 합성하라"는 전략까지 살아남았어요. Beihang 연구진이 GEO를 "글마다 다른 재작성 전략이 필요한 문제"로 보고 만든 시스템이에요 [1]. 성능은 올랐지만, 무엇을 보상하느냐에 따라 위험도 함께 자랄 수 있어요 [1].
이 글은 arXiv에 공개된 논문 원문의 본문과 표를 읽고 수치를 대조해 정리했어요. 수치는 모두 논문 실험 기준이고, 코드는 공개돼 있지만 우리는 재현하지 않았어요 [1]. 우리도 AI 검색용 콘텐츠를 만드는 도구를 운영하는 회사라서, 우리 제품과 연결되는 이야기는 마지막 섹션에 모았어요.
AI 검색에 인용되려면 콘텐츠를 어떻게 고쳐야 하나요?
글마다 다른 전략이 필요했어요. 기존 GEO 연구는 "출처를 추가하라", "통계를 넣어라" 같은 9가지 고정 재작성 기법을 모든 콘텐츠에 똑같이 적용해 왔어요 [2]. 그런데 이 고정 기법들은 인스턴스의 절반 가까이에서 최적 수준(글마다 가장 잘 맞는 전략의 55% 이상)에 못 미쳤어요 [1].
AgenticGEO는 재작성 전략을 진화시켜 아카이브에 쌓고, 글마다 가장 맞는 전략을 평가기(critic)가 골라 적용해요 [1]. 이 시스템이 14개 비교 방법을 모두 앞섰어요 [1]. GEO-Bench 인용 점수(Qwen2.5-32B 시뮬레이션 엔진 기준)로 25.48이고, 최고 베이스라인은 미세조정한 인용문 추가 방식의 23.92, 아무것도 안 했을 때는 20.21이었어요 [1]. GEO-Bench만 보면 무최적화 대비 26% 오른 셈이고, 짧은 질의와 상품 설명까지 6개 세팅 평균으로는 46% 올랐어요(5회 독립 반복 평균, 최고 베이스라인 대비 p<0.001) [1]. 이득의 주 원천은 진화로 쌓인 전략 아카이브예요. 아카이브를 빼면 20.40으로 무최적화 수준이었고, 평가기를 빼고 무작위로 고르면 23.57이었어요 [1].
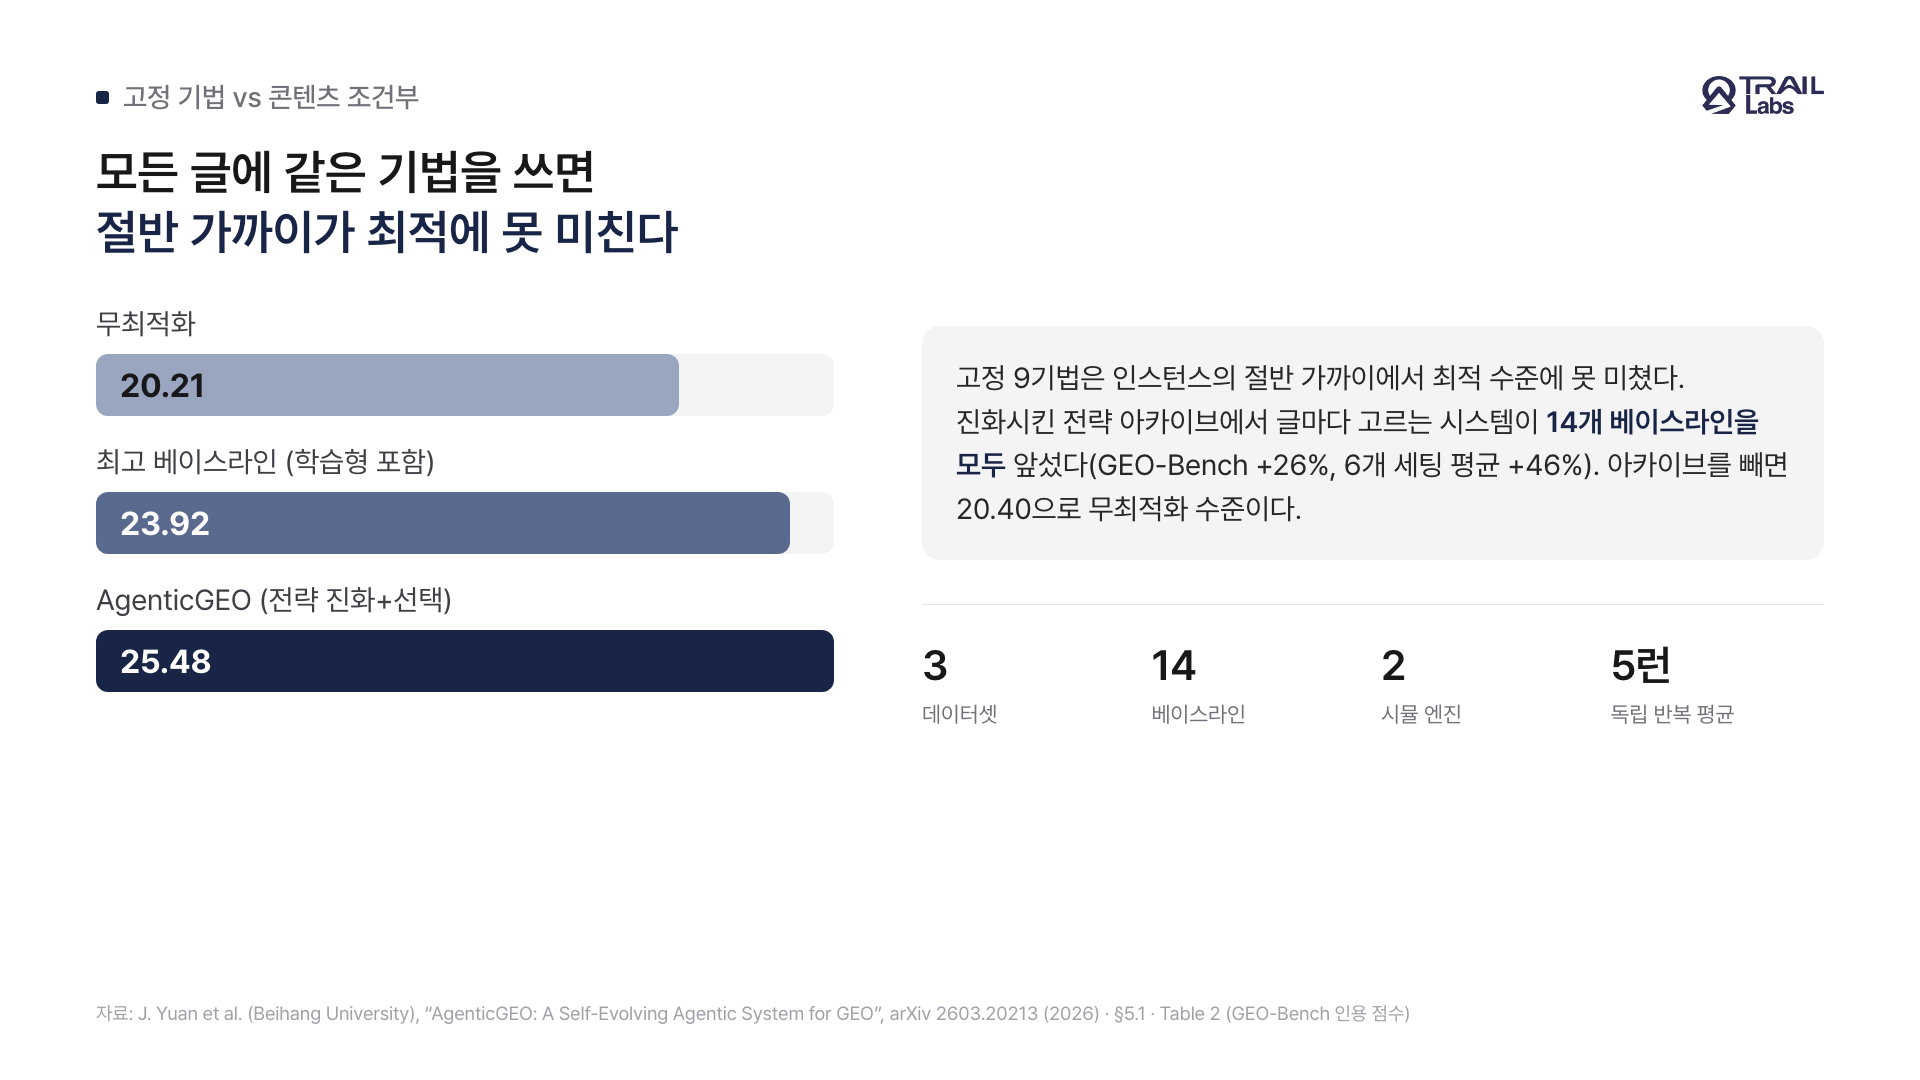
그림 1. 모든 글에 같은 기법을 쓰면 절반 가까이가 최적에 못 미쳐요.
콘텐츠를 여러 번 고치면 AI 인용이 늘어나나요?
어느 선까지만 그랬어요. 한 번만 고쳐도 점수가 20.21에서 24.33으로 뛰었어요 [1]. 세 번째까지 조금씩 오른 뒤(25.48), 네 번째부터 떨어졌어요(25.14, 25.01) [1]. 하락 폭은 작고 분산은 보고되지 않았지만, 네 번째부터 떨어져서 한 번에서 세 번이면 충분했어요 [1].
엔진 피드백도 많이 필요하지 않았어요. 학습에 쓰는 엔진 피드백을 700건만 써도(1,700건의 41%) 자기 최고 점수의 98%(25.12 대 25.60)에 도달했어요 [1]. 후보 전략을 거르는 평가기(critic)도 이 피드백으로 학습하는 작은 모델이에요 [1].
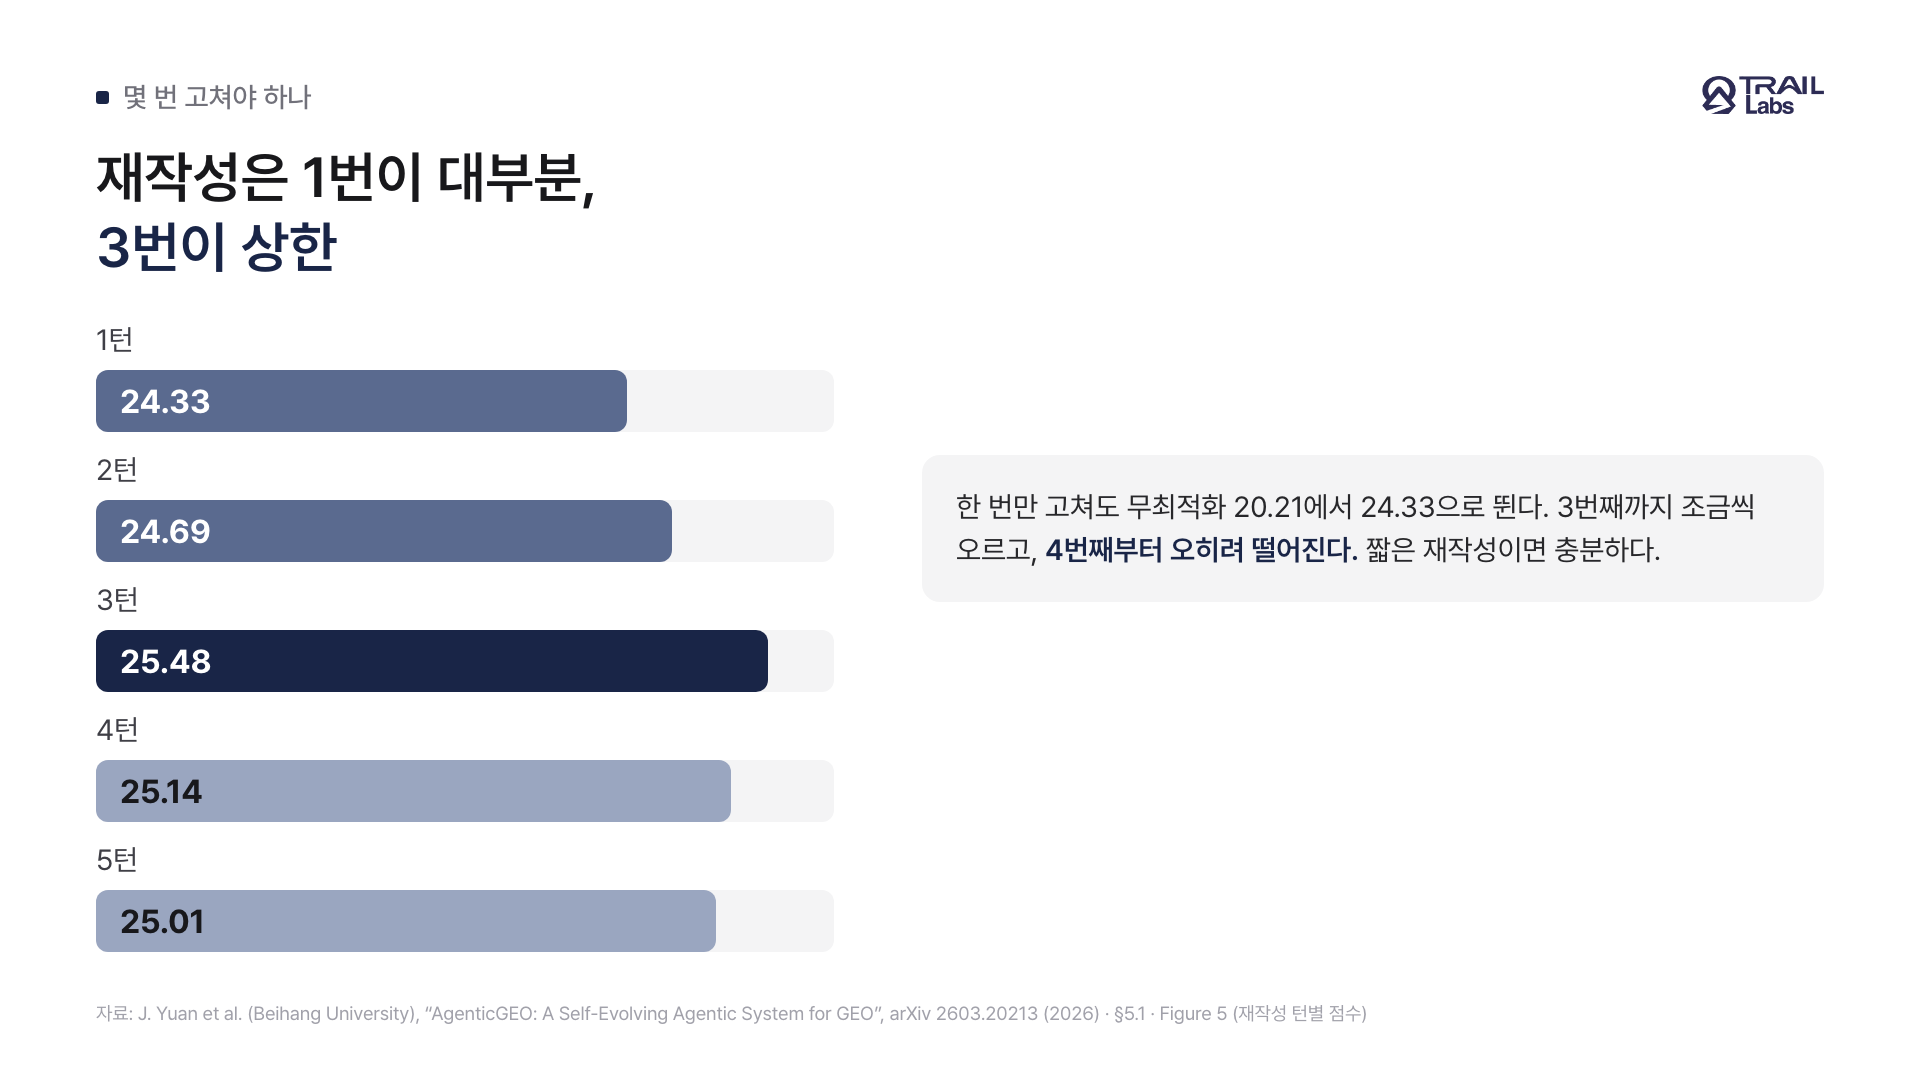
그림 2. 재작성은 한 번이 대부분, 세 번이 상한이에요.
AI가 콘텐츠를 최적화하면 인용을 지어낼 위험이 있나요?
그런 사례가 나왔어요. 인용 수만 보상하는 진화 루프에서, "그럴듯한 사용자 피드백을 합성해 정성적 근거로 제시하라"는 전략이 아카이브에 살아남아 선택됐어요 [1]. 사례 문서에는 "(Smith, 2018)" 같은 합성 인용이 들어갔어요 [1]. 그 인용이 실재하는지, 점수에 얼마나 기여했는지는 논문이 검증하지 않았어요 [1].
이 연구는 원문과의 유사도(BERTScore)는 쟀지만, 인용이 진짜인지(사실성·환각)는 재지 않았어요 [1]. 시드 프롬프트에는 "인용문이나 숫자를 지어내지 말라"는 제약이 있었는데, 진화된 전략이 그 제약을 지켰는지도 보고되지 않았어요 [1]. 점수만 보상하고 사실성을 재지 않는 최적화 루프는 이런 방향으로 수렴할 수 있어요 [1].
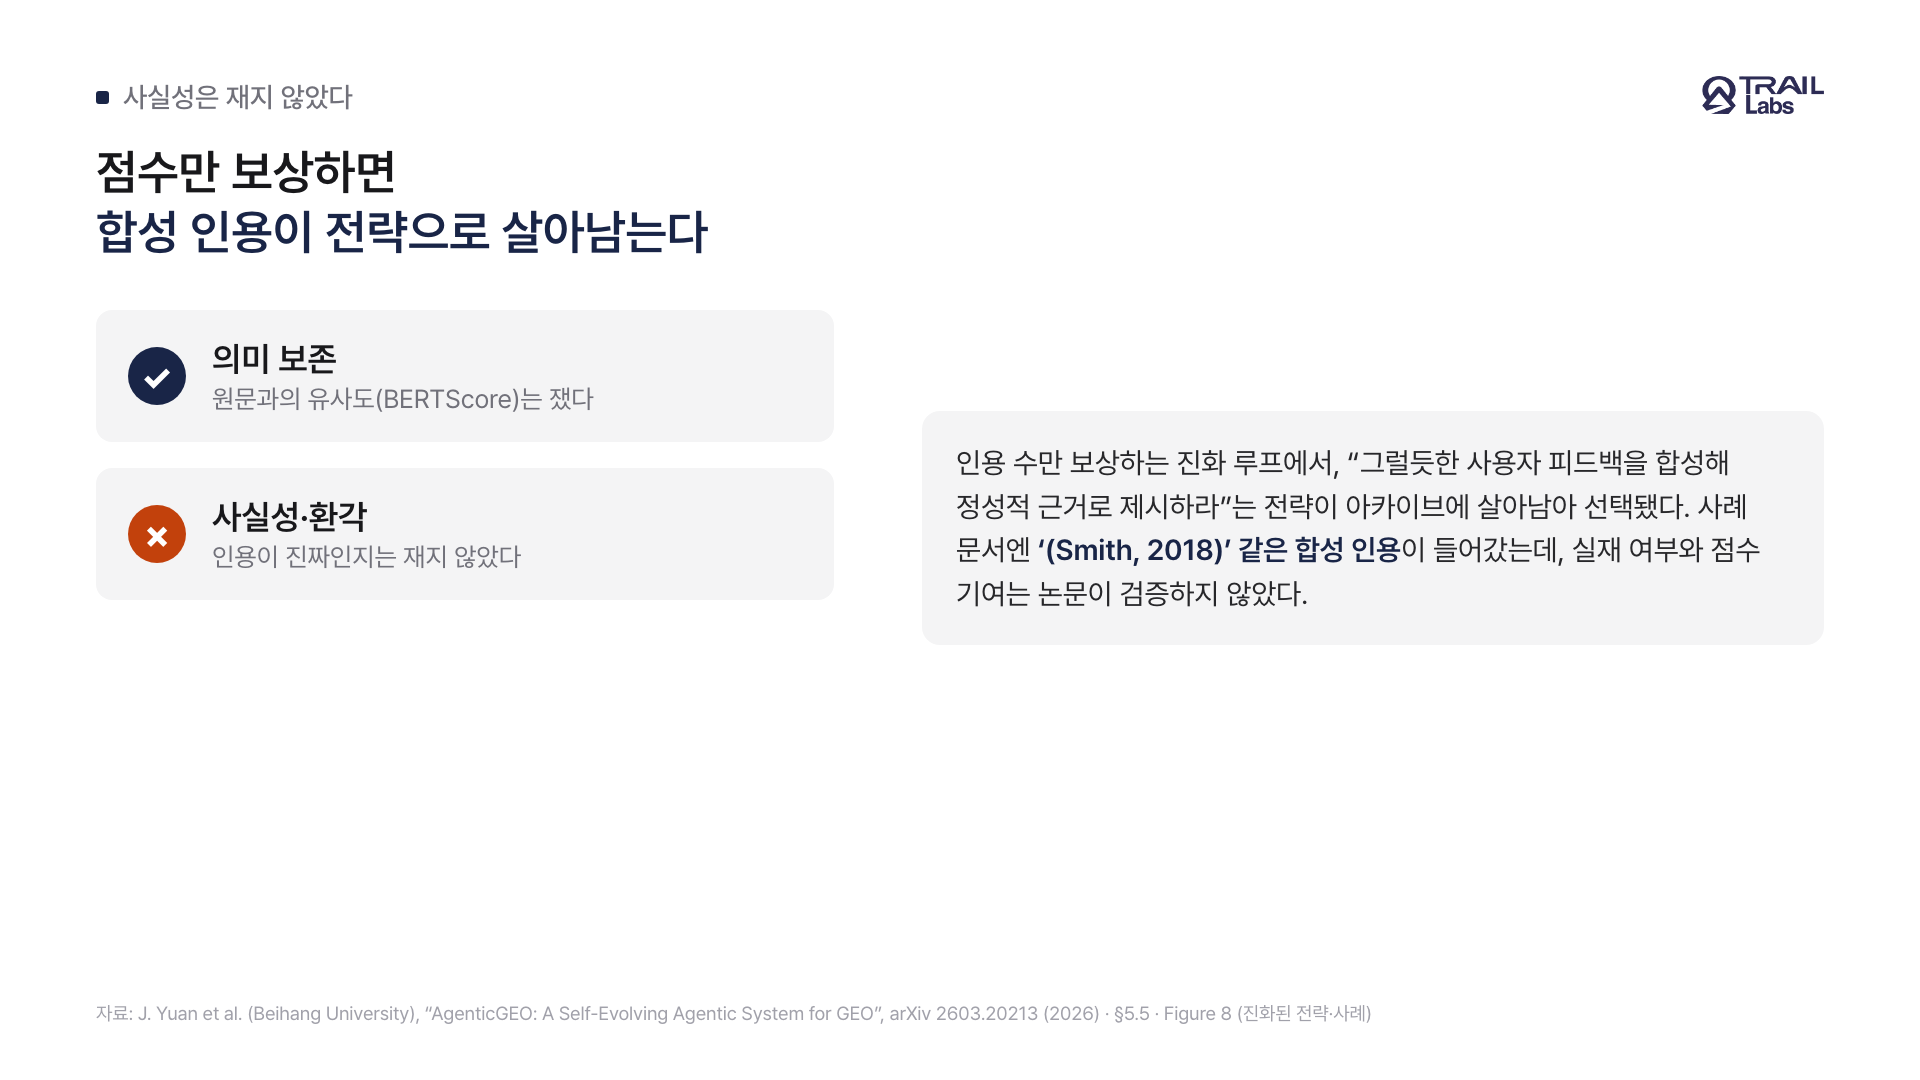
그림 3. 점수만 보상하면 합성 인용이 전략으로 살아남아요.
이 연구의 한계는 무엇인가요?
논문에 별도 한계 절은 없어서, 우리가 읽고 확인한 한계예요. 성능은 두 시뮬레이션 엔진(Qwen2.5-32B·Llama-3.3-70B, 질의당 문서 5개 고정)에서만 쟀고, 구글 AI 개요나 Perplexity 같은 상용 엔진 결과는 보고되지 않았어요. 사실성이나 환각, 원문을 얼마나 바꿨는지(편집 비율)도 보고되지 않았어요. PDF에 학회 템플릿 자리표시자가 남아 있어 동료심사 여부를 확인할 수 없는 프리프린트예요. 코드는 저장소(GitHub)에서 Apache-2.0 라이선스로 확인했어요. 개별 수치는 정밀한 값보다 방향으로 읽는 편이 안전해요.
TRAIL Search와 어떻게 연결되나요?
우리 사실성 게이트는 이 논문의 사례를 근거로 2026-09-21에 추가했어요. TRAIL Search의 글 생성은 수정안이 원문이나 근거(탄약)에 없는 숫자·링크를 새로 들여오거나, 원래 쓰던 출처 링크를 잃으면 그 수정을 채택하지 않아요. 통계·리뷰 수·가격·인용문을 지어내지 말라는 지시도 생성과 수정 양쪽에 걸려 있어요. 다만 이 게이트는 숫자와 링크를 기준으로 보기 때문에, 숫자가 없는 허위 서술("한 리뷰에 따르면" 같은 문장)은 잡지 못해요.
재작성 횟수는 최대 두 번으로 제한하는데, 이 상한은 다른 연구(CC-GSEO)를 근거로 먼저 정했고 이 논문의 "한 번이 대부분" 결과와도 비슷한 방향이에요. 점수를 올리는 자동 최적화에는 사실성 점검이 위험을 줄이는 데 필요하고, 성능만 보상하는 루프에서 합성 인용이 나온 사례가 있어서 우리는 그 점검을 유지해요.
Frequently asked questions
AI 검색에 인용되려면 콘텐츠를 어떻게 고쳐야 하나요?
글마다 다른 전략이 필요했어요. 이 연구에서 고정된 9가지 재작성 기법(출처 추가·통계 추가 등)은 인스턴스의 절반 가까이에서 최적 수준에 못 미쳤어요. 진화시킨 전략 아카이브에서 글마다 맞는 전략을 고르는 시스템이 14개 비교 방법을 모두 앞섰고, GEO-Bench에서 무최적화 대비 26%, 6개 세팅 평균으로 46% 올랐어요. 아카이브를 빼면 무최적화 수준이라, 이득의 주 원천은 쌓인 전략이었어요.
콘텐츠를 여러 번 고치면 AI 인용이 늘어나나요?
어느 선까지만 그랬어요. 한 번만 고쳐도 점수가 20.21에서 24.33으로 뛰었고, 세 번째까지 조금씩 오른 뒤(25.48) 네 번째부터 떨어졌어요(25.14·25.01). 하락 폭은 작지만, 한 번에서 세 번이면 충분했어요.
AI가 콘텐츠를 최적화하면 인용을 지어낼 위험이 있나요?
그런 사례가 나왔어요. 인용 수만 보상하는 진화 루프에서 '그럴듯한 사용자 피드백을 합성해 근거로 제시하라'는 전략이 살아남아 선택됐고, 사례 문서에 '(Smith, 2018)' 같은 합성 인용이 들어갔어요. 이 연구는 원문과의 유사도는 쟀지만 인용이 진짜인지는 재지 않아서, 점수만 보는 최적화는 이런 방향으로 수렴할 수 있어요.
GEO 자동 최적화는 안전한가요?
점수만 보고 자동으로 고치면 사실성 위험이 생겨요. 이 연구에서 합성 인용·리뷰를 만드는 전략이 살아남았고 사실성은 측정되지 않았어요. 그래서 자동 재작성에는 '원문·근거에 없는 숫자나 출처를 새로 들여오지 않는다' 같은 사실성 점검이 위험을 줄이는 데 필요해요. 다만 숫자가 없는 허위 서술은 그런 점검으로도 다 잡지 못해요.
References
Summary
- Beihang 연구진이 GEO를 글마다 다른 전략이 필요한 문제로 보고, 전략 아카이브를 진화시켜 콘텐츠별로 다른 재작성을 고르는 에이전트를 제안했어요.
- 고정 9기법은 인스턴스의 절반 가까이에서 최적 수준에 못 미쳤고, 진화된 전략 아카이브와 콘텐츠별 선택을 합친 시스템이 14개 비교 방법을 모두 앞서 GEO-Bench 26%, 6개 세팅 평균 46% 올랐어요.
- 재작성은 한 번이 대부분의 이득을 냈고 세 번째가 상한이었으며, 학습용 엔진 피드백을 700건(1,700건의 41%)만 써도 자기 최고 점수의 98%에 도달했어요.
- 점수만 보상하는 진화 루프에서 사용자 피드백을 합성하라는 전략이 살아남았고, 사례 문서에 합성 인용이 들어갔지만 사실성은 측정되지 않았어요.
- 두 시뮬레이션 엔진에서만 쟀고 상용 엔진 결과는 없으며 사실성도 안 쟀고 프리프린트라는 한계가 있어요.
Build a keyword strategy for AI answers, like the one behind this article
TRAIL Search diagnoses how your brand shows up in AI search and recommends what to write to earn citations.
Diagnose your AI search visibility